
PostgreSQL / 系统课时
设计可重入的批量归档任务
设计可重入的批量归档任务
在线归档的关键不是循环执行 INSERT 和 DELETE,而是让每个批次都有稳定边界和唯一提交点。本课把复合游标、幂等目标表、批次复制删除和进度推进放进同一事务,使任务中断后能够从最后一次已提交的位置安全续跑。
学习目标
- 使用
(created_at, id)复合游标切分历史数据,避免OFFSET漂移 - 让归档目标具备与源表一致的唯一标识,确保重复执行不会制造重复数据
- 在同一事务内完成复制、删除和进度推进,使续跑边界可验证
用稳定游标而不是 OFFSET
批次边界必须稳定且全序。只按时间戳分页时,多行可能具有相同时间;使用 OFFSET 时,前序数据被删除后,后续行的位置还会变化。下面示例明确假设 orders(id) 是主键,并使用不可变的 created_at 与主键 id 组成复合游标。
为了避免每批都扫描大量历史数据,源表应建立与游标排序一致的索引。
CREATE INDEX CONCURRENTLY IF NOT EXISTS idx_orders_archive_cursor
ON orders (created_at, id);
预期结果
CREATE INDEXCREATE INDEX CONCURRENTLY 可以减少对在线写入的阻塞,但仍会消耗 I/O、CPU 和额外磁盘空间,生产环境应先确认资源余量。
建立可证明幂等的归档目标
进度不能只保存在脚本内存或本地文件中,否则进程崩溃或更换执行节点后,很难证明已经提交到哪里。先建立持久化进度表,再创建与源表索引语义兼容的归档表。
CREATE TABLE IF NOT EXISTS archive_job_progress (
    job_name text PRIMARY KEY,
    last_created_at timestamptz NOT NULL,
    last_id bigint NOT NULL,
    updated_at timestamptz NOT NULL DEFAULT clock_timestamp()
);

INSERT INTO archive_job_progress (job_name, last_created_at, last_id)
VALUES ('orders-history', TIMESTAMPTZ '1970-01-01 00:00:00+00', 0)
ON CONFLICT (job_name) DO NOTHING;

CREATE TABLE IF NOT EXISTS archive_orders (
    LIKE orders INCLUDING INDEXES
);
预期结果
CREATE TABLE
INSERT 0 <VALUE>
CREATE TABLE
首次初始化时 <VALUE> 通常为 1,记录已存在时为 0。INCLUDING INDEXES 会在新表上创建源表索引的对应副本,并保留由主键、唯一约束和排他约束形成的索引语义;这里没有复制 Identity、生成列表达式、外键、触发器和权限等对象,因此这些能力若归档库确实需要,必须单独审核和创建。
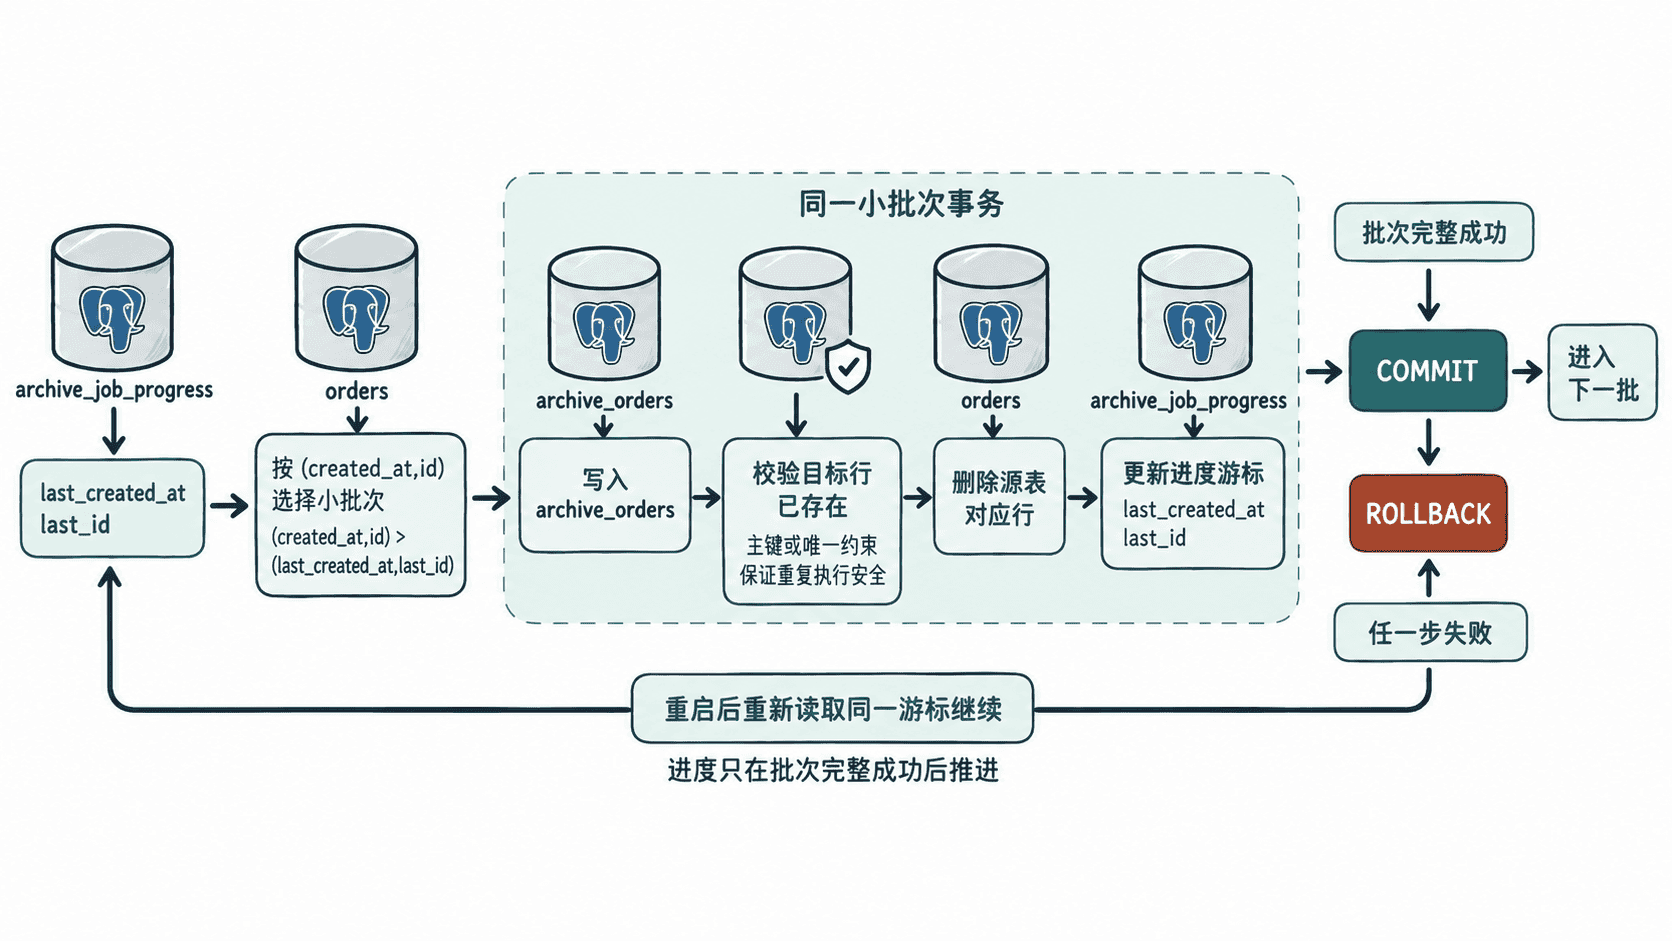
在一个事务里完成批次与进度推进
主事务先锁住该任务的进度行,避免同一 job_name 的多个执行器同时从相同游标起跑;随后把本批完整记录写入临时表。临时表同时保存 created_at 和 id,因此事务末尾可以直接从本批真实数据中取得最后一个复合游标。
BEGIN;

SELECT last_created_at, last_id
FROM archive_job_progress
WHERE job_name = 'orders-history'
FOR UPDATE;

CREATE TEMP TABLE archive_batch ON COMMIT DROP AS
SELECT o.*
FROM orders AS o
JOIN archive_job_progress AS p
  ON p.job_name = 'orders-history'
WHERE o.created_at < DATE '2025-01-01'
  AND (o.created_at, o.id) > (p.last_created_at, p.last_id)
ORDER BY o.created_at, o.id
LIMIT 1000
FOR UPDATE OF o;

INSERT INTO archive_orders
SELECT *
FROM archive_batch
ON CONFLICT (id) DO NOTHING;

DELETE FROM orders AS o
USING archive_batch AS b
WHERE o.id = b.id
  AND EXISTS (
      SELECT 1
      FROM archive_orders AS a
      WHERE a.id = b.id
  );

UPDATE archive_job_progress AS p
SET (last_created_at, last_id) = (
        SELECT b.created_at, b.id
        FROM archive_batch AS b
        ORDER BY b.created_at DESC, b.id DESC
        LIMIT 1
    ),
    updated_at = clock_timestamp()
WHERE p.job_name = 'orders-history'
  AND EXISTS (SELECT 1 FROM archive_batch);

COMMIT;
预期结果
BEGIN
 last_created_at | last_id
-----------------+---------
 <TIME>          | <ID>
(1 row)

SELECT <VALUE>
INSERT 0 <VALUE>
DELETE <VALUE>
UPDATE <VALUE>
COMMIT
实际 <TIME>、<ID> 和各处 <VALUE> 取决于数据。批次为空时,UPDATE 的 EXISTS 条件使进度保持不变;批次非空时,归档写入、源表删除和游标推进共享同一个提交点。如果事务在 COMMIT 前失败,三部分一起回滚;如果数据库已经提交而客户端随后断线,下一次执行会读取已经推进的新游标。
这里的 ON CONFLICT (id) DO NOTHING 依赖 archive_orders(id) 上存在主键或唯一约束。删除步骤又确认目标表已经存在同一 id,因此源记录只有在归档目标可确认时才会被删除。
验证续跑而不是只验证清零
可重入性应主动演练,而不是只看任务最终有没有跑完。可以在某批 COMMIT 前终止会话,确认重启后仍从旧游标重新读取;再模拟数据库已提交但客户端没有收到成功响应,确认重试不会产生重复归档行,也不会跳过未提交的数据。
最后分别检查进度边界和截止点之前仍留在源表的数据。
SELECT job_name, last_created_at, last_id
FROM archive_job_progress
WHERE job_name = 'orders-history';

SELECT count(*) AS remaining_rows
FROM orders
WHERE created_at < DATE '2025-01-01';
预期结果
   job_name     | last_created_at | last_id
----------------+-----------------+---------
 orders-history | <TIME>          | <ID>
(1 row)

 remaining_rows
----------------
 0
(1 row)只有业务要求截止点之前所有记录都必须完成归档时,remaining_rows = 0 才是正确验收条件;如果允许保留例外数据,应把例外条件显式写进验证 SQL。可靠的可重入任务必须同时满足三点:批次边界稳定、重复执行没有额外副作用、进度只在该批数据成功处置的同一提交点推进。