
PostgreSQL / 系统课时
建立生命周期监控指标
建立生命周期监控指标
生命周期治理不能只看“任务有没有成功”。真正需要持续观测的是数据规模、归档积压、任务吞吐、失败趋势和存储余量。把这些信号转换为可计算、可告警的指标,才能在大表再次失控或磁盘逼近上限前发现风险。
学习目标
- 建立表增长、分区数量、归档积压和任务执行质量指标
- 使用 PostgreSQL 系统函数和系统视图采集容量与对象规模数据
- 使用增长率、吞吐和容量余量组合判断生命周期风险
把生命周期状态拆成六类信号
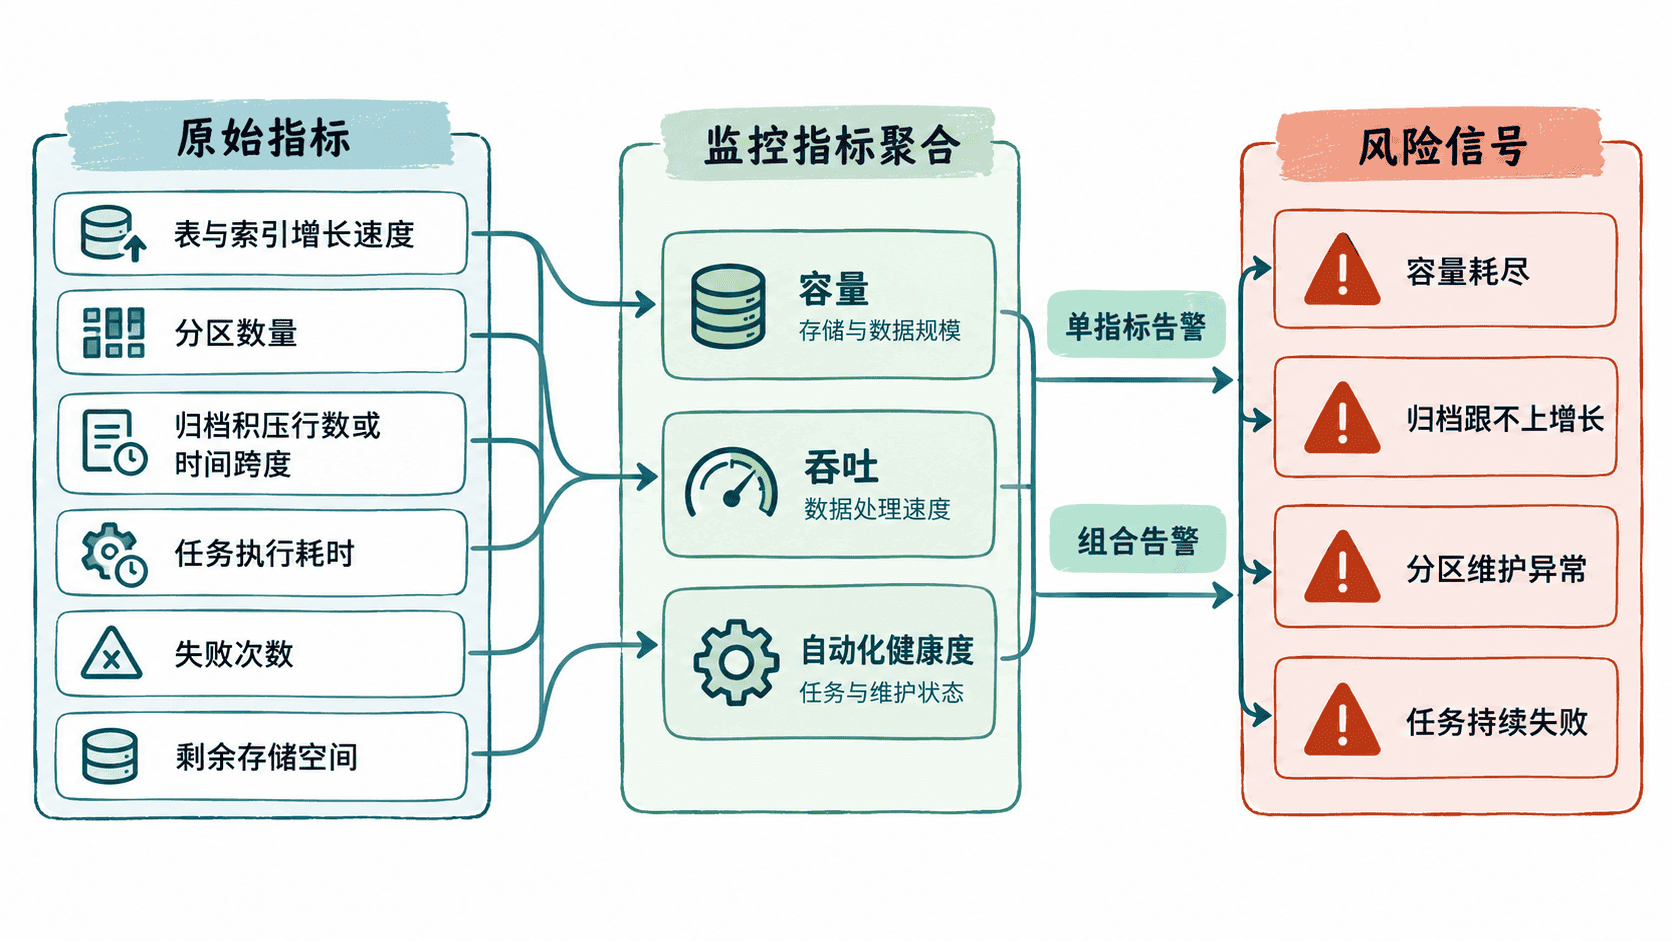
生命周期监控至少覆盖六个方向:表增长速度反映在线数据是否持续超出预期;分区数量反映对象创建和清理是否符合规划;归档积压反映到期数据是否及时迁出;执行耗时与吞吐反映任务处理能力;失败次数反映自动化稳定性;剩余存储空间则决定系统还能承受多久的净增长。
这些指标不能彼此孤立。例如磁盘使用率升高可能只是正常业务增长,但如果同时出现归档积压扩大和任务吞吐下降,就更可能说明生命周期链路的处理能力已经跟不上数据增长。
采集表、索引与分区规模
PostgreSQL 可以直接查询关系对象的容量。监控采集时应优先保存原始字节数,再按需生成易读单位;否则只保存 pg_size_pretty 文本会增加后续增长率计算的难度。下面以 event_log 为例,同时获取表数据及其附属存储、索引、总占用以及直接子分区数量。
SELECT
    pg_table_size('event_log') AS table_bytes,
    pg_indexes_size('event_log') AS index_bytes,
    pg_total_relation_size('event_log') AS total_bytes,
    (
        SELECT count(*)
        FROM pg_inherits
        WHERE inhparent = 'event_log'::regclass
    ) AS partition_count;
预期结果
table_bytes | index_bytes | total_bytes | partition_count
------------+-------------+-------------+----------------
<VALUE> | <VALUE> | <VALUE> | <VALUE>实际容量和分区数量取决于当前数据库。pg_table_size 包含表的主数据以及 TOAST、FSM、VM 等附属存储,但不包含索引;pg_indexes_size 返回该关系全部索引占用;pg_total_relation_size 则包含表及索引。这里的 pg_inherits 查询只统计 event_log 的直接子分区;如果使用多级分区,应根据监控目标改用 pg_partition_tree 统计全部层级或叶子分区。
表增长速度需要比较连续采样点,例如按 增长速度 = (当前 total_bytes - 上次 total_bytes) / 时间间隔 计算。单次容量快照只能回答“现在有多大”,连续采样才能进一步估算“按当前趋势多久会耗尽空间”。
量化归档积压与任务质量
如果生命周期规则以时间字段作为边界,归档积压至少应记录两个值:仍滞留在线库的到期行数,以及最老待归档记录的时间。前者衡量剩余工作量,后者反映任务已经落后了多久。
下面查询使用固定 cutoff 演示积压采集。实际监控必须复用归档任务已经确定的 cutoff,避免监控口径和执行口径不一致。
SELECT
    count(*) AS backlog_rows,
    min(created_at) AS oldest_backlog_at
FROM orders
WHERE created_at < TIMESTAMP '2026-03-01 00:00:00';
预期结果
backlog_rows | oldest_backlog_at
-------------+-------------------
<VALUE> | <TIME>当没有积压记录时,backlog_rows 为 0,oldest_backlog_at 为 NULL。任务侧还应记录每次运行的开始时间、结束时间、处理行数、最终状态和错误原因,从而计算执行耗时、单位时间处理行数、连续失败次数和最近一次成功时间。只记录“成功或失败”,会错过吞吐持续下降这类更早出现的异常。
监控剩余存储空间
数据库对象大小只能反映 PostgreSQL 当前占用了多少空间,不能直接给出文件系统还有多少可用容量。因此生命周期容量监控通常需要把数据库规模指标与主机、容器平台或云磁盘指标组合起来。
数据库侧可以先采集当前数据库的原始占用字节数,同时保留易读值供人工查看。
SELECT
    current_database() AS database_name,
    pg_database_size(current_database()) AS database_bytes,
    pg_size_pretty(pg_database_size(current_database())) AS database_size;
预期结果
database_name | database_bytes | database_size
--------------+----------------+--------------
<VALUE>       | <VALUE>        | <VALUE>
文件系统剩余容量应由操作系统或基础设施监控采集。除了剩余百分比,还应结合近期净增长速度计算预计耗尽时间;同样是剩余 30%,每天仍快速增长的实例通常比容量长期稳定的实例更需要优先处置。
用组合条件设置告警
告警应围绕“生命周期处理能力是否跟得上数据增长”设计,而不是机械地给每个指标设置一个固定阈值。更有诊断价值的组合包括:归档积压连续多个周期扩大且任务吞吐下降;分区数量持续超过规划范围且旧分区没有减少;连续失败增加且最近成功时间越来越远;磁盘余量下降且预计耗尽时间已经小于运维处置窗口。
最终需要形成一条从原始容量和任务记录,到增长速度、积压程度、处理吞吐与预计耗尽时间的连续监控链。只要这些指标按统一时间轴长期保存,就能把生命周期治理从事后清理转变为对容量和处理能力的持续控制。