
PostgreSQL / 系统课时
设计失败重试与幂等机制
设计失败重试与幂等机制
自动归档真正难处理的不是一次成功,而是进程中断、目标端异常或部分批次完成后怎样安全重跑。本课用稳定批次标识、目标端唯一约束、完整性验证和显式状态恢复,让同一归档范围重复执行也不会重复写入或误删源数据。
学习目标
- 区分可直接重试、部分成功和状态不确定三类失败
- 用稳定批次标识与唯一约束实现幂等归档写入
- 设计验证通过后才允许删除源数据的可恢复流程
先定义归档批次的稳定边界
不要把“归档程序启动了一次”当成幂等单位。更可靠的做法是为一个确定的数据范围生成稳定的 batch_key,例如由源表、时间窗口和分片共同确定。相同范围重试时必须继续使用同一个键,而不是创建新的逻辑批次。
批次状态可以包含 PENDING、COPYING、COPIED、DELETING、DONE 和 FAILED。这些状态的作用不是展示进度,而是让重启后的任务判断上次停在哪个阶段,以及下一步是否允许继续。
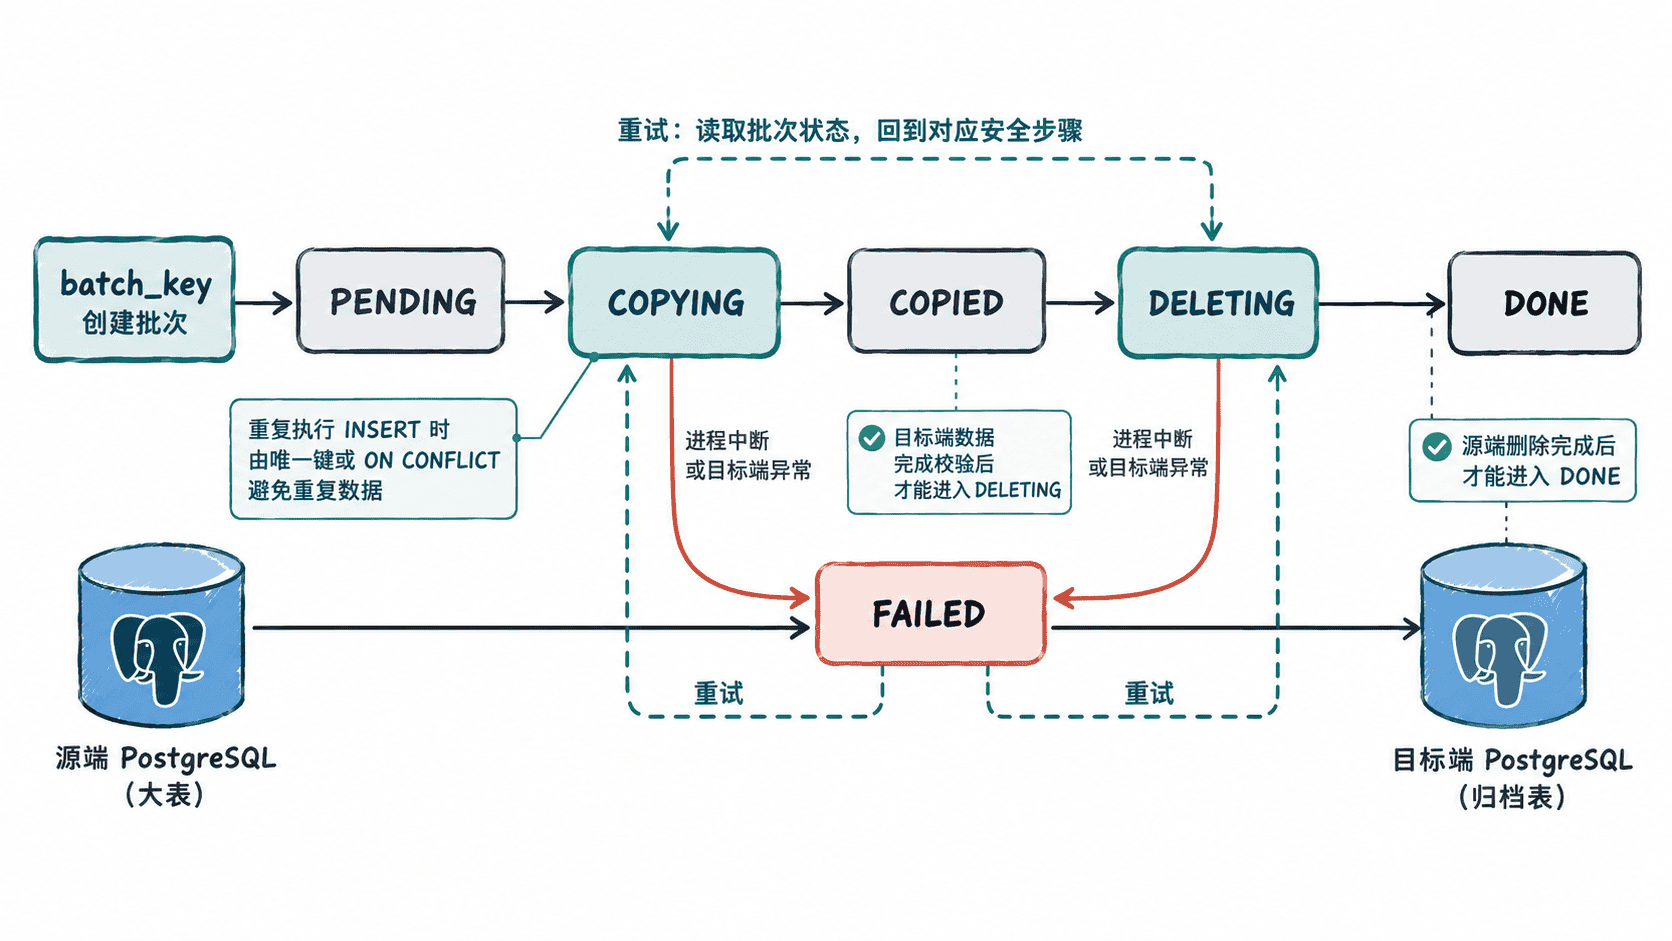
下面建立批次控制表和归档目标表。示例假设 orders.id 是稳定唯一标识,因此在目标表上显式建立主键,供后续 ON CONFLICT (id) 使用。LIKE ... INCLUDING CONSTRAINTS 会复制适用的约束定义,但不会复制源表索引,因此不能依赖它自动产生主键或唯一索引。
CREATE TABLE archive_job_batch (
    batch_key text PRIMARY KEY,
    range_start timestamptz NOT NULL,
    range_end timestamptz NOT NULL,
    status text NOT NULL,
    copied_rows bigint,
    updated_at timestamptz NOT NULL DEFAULT now()
);

CREATE TABLE orders_archive (
    LIKE orders INCLUDING DEFAULTS INCLUDING CONSTRAINTS
);

-- ON CONFLICT (id) 必须由目标表上的唯一或排除约束提供冲突仲裁条件。
ALTER TABLE orders_archive
    ADD PRIMARY KEY (id);

INSERT INTO archive_job_batch (
    batch_key, range_start, range_end, status
)
VALUES (
    'orders-2026-01-01',
    '2026-01-01 00:00:00+00',
    '2026-02-01 00:00:00+00',
    'PENDING'
)
ON CONFLICT (batch_key) DO NOTHING;
预期结果
CREATE TABLE
CREATE TABLE
ALTER TABLE
INSERT 0 1
再次执行最后一条 INSERT 时,预期结果为 INSERT 0 0,表示相同 batch_key 不会产生第二条批次记录。如果源表的 id 不能保证唯一,应改用真正稳定且唯一的业务键,并在目标归档表上建立对应的唯一约束。
让复制步骤可以安全重复
复制阶段最危险的情况是“目标端已经写入一部分,但任务还没来得及更新批次状态”。因此,看到 COPYING 并不能推断目标表为空;恢复时应重新执行一个本身可重复的写入操作。
目标表已经对 id 建立主键后,可以用 ON CONFLICT (id) DO NOTHING 跳过已存在的记录。即使进程在部分写入后退出,下一次运行也只补齐尚未归档的数据。
INSERT INTO orders_archive
SELECT *
FROM orders
WHERE created_at >= '2026-01-01 00:00:00+00'
  AND created_at <  '2026-02-01 00:00:00+00'
ON CONFLICT (id) DO NOTHING;
预期结果
INSERT 0 <VALUE><VALUE> 是这一次真正新增到目标表的行数。发生重试后,它可能小于该归档范围的总行数,甚至为 0;只要目标范围已经完整,这都属于正常结果。
把完整性验证放在删除之前
复制 SQL 成功与源数据可以安全删除是两个不同结论。删除前至少应比较同一个稳定范围内的源端和目标端行数;关键业务还可以增加金额汇总、校验和或抽样比对。
SELECT
    (SELECT count(*)
     FROM orders
     WHERE created_at >= '2026-01-01 00:00:00+00'
       AND created_at <  '2026-02-01 00:00:00+00') AS source_rows,
    (SELECT count(*)
     FROM orders_archive
     WHERE created_at >= '2026-01-01 00:00:00+00'
       AND created_at <  '2026-02-01 00:00:00+00') AS archive_rows;
预期结果
 source_rows | archive_rows
-------------+--------------
 <VALUE>     | <VALUE>
只有两侧满足预先定义的完整性条件,批次状态才能从 COPYING 推进到 COPIED。如果结果不一致,应继续补拷或排查原因,而不是进入删除阶段。生产环境还应冻结 cutoff 或保存明确的主键集合,确保重试时选择的数据边界不会变化。
让删除阶段也能中断后继续
源端删除同样可能只完成一部分便中断。为了让 DELETING 状态可恢复,删除条件必须始终使用同一个稳定范围,并只删除已经确认存在于目标表中的记录。通过稳定唯一键关联,可以避免误删尚未成功归档的数据。
DELETE FROM orders AS s
USING orders_archive AS a
WHERE s.id = a.id
  AND s.created_at >= '2026-01-01 00:00:00+00'
  AND s.created_at <  '2026-02-01 00:00:00+00';
预期结果
DELETE <VALUE>如果任务在删除部分数据后中断,再次执行相同 SQL 只会处理仍然存在的源端记录。删除结束后还应再次检查该稳定范围内的剩余行数;只有确认符合完成条件后,才能将批次标记为 DONE。
重启时根据数据库事实恢复
任务启动后应先读取已有批次记录。PENDING 或 COPYING 可以重新执行幂等复制并再次验证;COPIED 或 DELETING 应先确认目标端完整性,再继续删除;DONE 直接跳过。对于 FAILED,应结合持久化的失败阶段和数据库当前事实选择恢复入口,而不是无条件从头执行。
幂等归档的关键并不是“失败后再执行一次”,而是让复制、验证和删除中的每一步在重复执行时都不会破坏最终结果。稳定的批次标识、目标端唯一约束、删除前完整性验证和显式状态恢复共同构成这条安全边界。