
PostgreSQL / 系统课时
排查归档任务执行变慢
排查归档任务执行变慢
归档吞吐下降时,直接增大批次或提高并发往往会进一步放大锁、WAL 和 I/O 压力。更可靠的做法是沿着读取源数据、锁定与修改、写入目标端这条链路逐层定位,先确定瓶颈发生在哪里,再决定优化手段。
学习目标
- 按执行计划、批次范围、索引、锁等待、I/O 和目标端性能定位归档变慢原因
- 使用 PostgreSQL 统计视图与
EXPLAIN区分扫描慢、等待慢和目标写入慢 - 根据证据选择缩小批次、补索引、解除阻塞或优化目标端等修复方式
先确认慢在哪一个阶段
一个典型归档批次通常包含读取候选行、复制或写入归档端、校验、删除源数据和提交事务。总耗时增加并不说明所有阶段都变慢,因此第一步应分别记录各阶段耗时,并与历史正常批次比较。
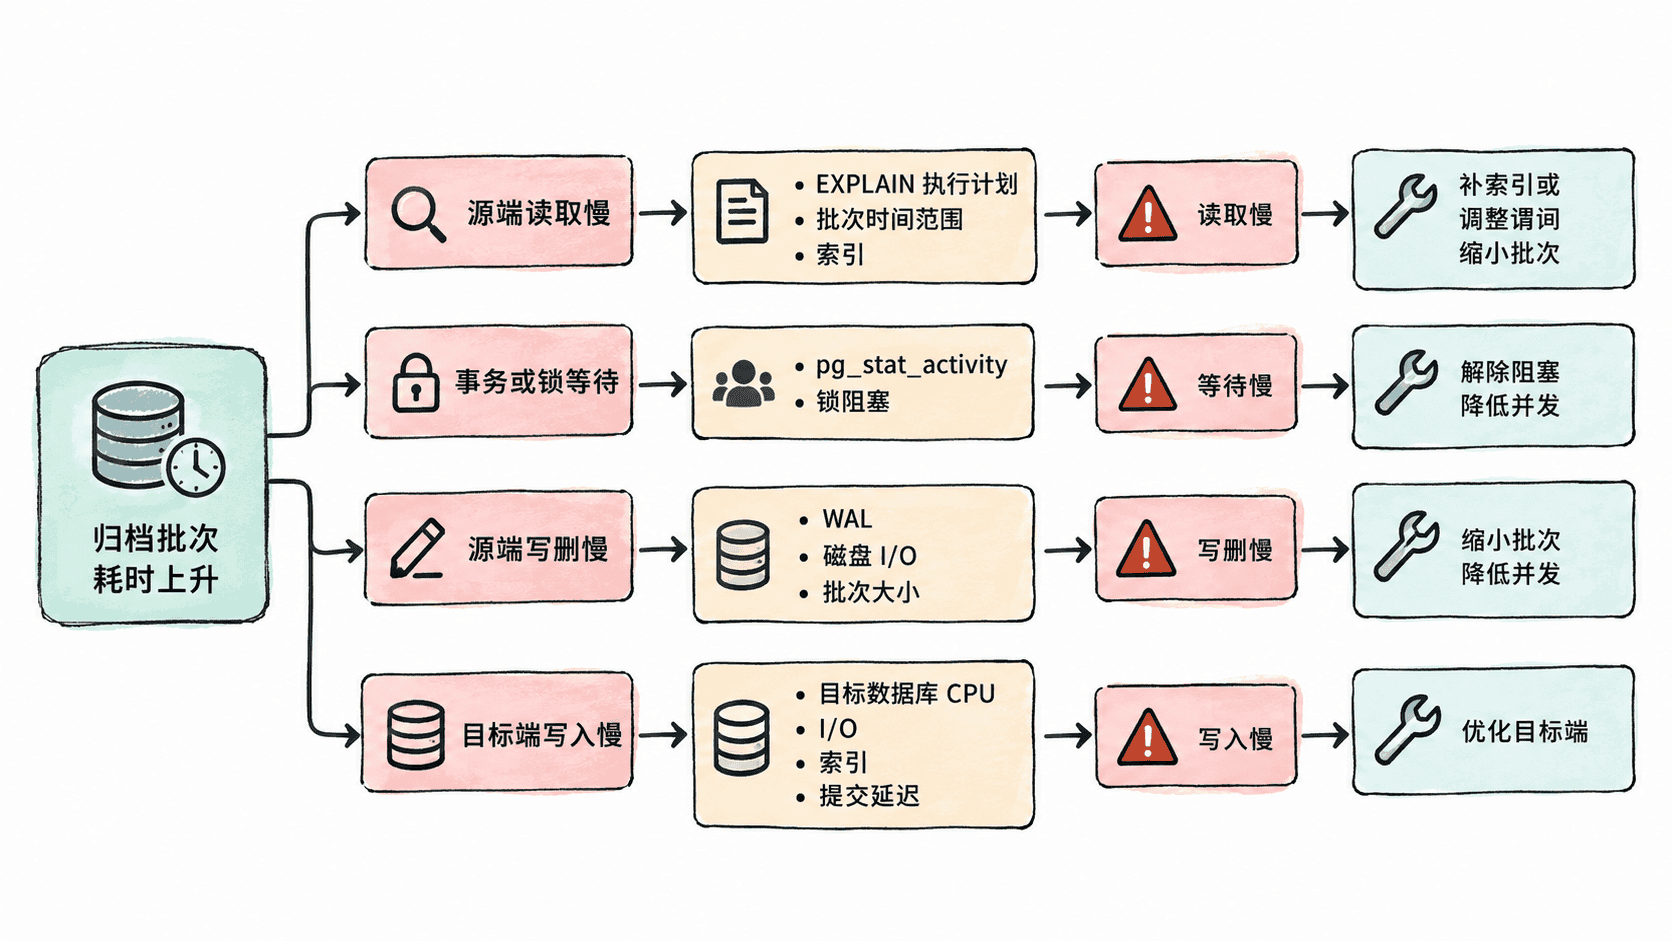
如果只有读取候选行阶段变慢,重点检查查询计划和索引;如果 SQL 实际执行很快,但归档会话长期处于等待状态,应优先排查锁或其他等待事件;如果源端读取稳定而目标端写入越来越慢,继续调整源表索引通常不会解决问题。
检查执行计划和批次范围
先对归档任务用于选择候选数据的实际 SQL 执行 EXPLAIN (ANALYZE, BUFFERS)。不要只测试简化后的过滤条件,否则可能遗漏排序、批次游标或其他实际执行成本。生产环境执行 ANALYZE 会真正运行查询,应先确认该查询只读且成本可控。
EXPLAIN (ANALYZE, BUFFERS)
SELECT id, created_at
FROM orders
WHERE created_at < TIMESTAMP '2026-03-01 00:00:00'
  AND (created_at, id) > (TIMESTAMP '2026-02-01 00:00:00', 0)
ORDER BY created_at, id
LIMIT 5000;
预期结果
Limit  (cost=<VALUE> rows=<VALUE> width=<VALUE>) (actual time=<VALUE> rows=<VALUE> loops=1)
  ->  <INDEX OR SCAN PLAN>
        Buffers: shared hit=<VALUE> read=<VALUE>
Planning Time: <VALUE> ms
Execution Time: <VALUE> ms
实际数值会因数据分布、缓存和机器负载不同而变化。重点不是某个固定耗时,而是访问方式和实际扫描量:如果计划从合适的索引扫描退化为大范围顺序扫描,或为了返回 5000 行访问了远多于预期的数据页,就应继续检查过滤条件与索引是否匹配。
对于按 (created_at, id) 稳定游标推进的归档任务,通常需要能支持该过滤与排序顺序的索引。可以先确认现有索引定义。
SELECT indexname, indexdef
FROM pg_indexes
WHERE schemaname = 'public'
  AND tablename = 'orders';
预期结果
indexname | indexdef
----------+-----------------------------------------------
<VALUE>   | <VALUE>
如果缺少与批次查询匹配的索引,应在评估建索引期间的 I/O、额外存储和持续写入成本后再补充,而不是简单提高 LIMIT 5000。批次越大,一次低效扫描、锁持有和事务提交的影响通常越明显。
排除锁与其他等待
执行计划看起来正常但任务仍偶发卡住时,应观察归档会话当前状态和等待事件。下面的查询可以同时查看活动 SQL、等待类型以及直接阻塞它的后端 PID。
SELECT
    pid,
    state,
    wait_event_type,
    wait_event,
    pg_blocking_pids(pid) AS blocking_pids,
    now() - query_start AS query_age,
    query
FROM pg_stat_activity
WHERE datname = current_database()
  AND state <> 'idle';
预期结果
pid  | state   | wait_event_type | wait_event | blocking_pids | query_age | query
-----+---------+-----------------+------------+---------------+-----------+------
<ID> | <VALUE> | <VALUE>         | <VALUE>    | <VALUE>       | <TIME>    | <VALUE>
实际 PID、时间和等待事件会随运行状态变化。如果归档会话的 wait_event_type 为 Lock,并且 blocking_pids 非空,应先确认阻塞事务的业务来源、事务年龄和持锁时间。此时主要耗时发生在等待阶段,仅优化归档 SQL 的扫描计划通常无法消除卡顿。
判断是否受 I/O、WAL 与批次大小限制
没有明显锁等待时,如果 EXPLAIN 显示访问的数据块显著增加,或者批次扩大后耗时增长明显快于处理行数,就应检查源库的 I/O、WAL 和事务压力。大量复制与删除会同时带来表页访问、索引维护、WAL 生成和提交压力。
数据库级累计统计可以帮助判断趋势,但 blks_read 并不等同于物理磁盘读取次数,因为操作系统缓存也可能参与读取。排障时应比较同一时间窗口内的增量,并结合主机或存储监控判断真实 I/O 延迟。
SELECT
    datname,
    blks_read,
    blks_hit,
    temp_files,
    temp_bytes,
    xact_commit,
    xact_rollback
FROM pg_stat_database
WHERE datname = current_database();

SELECT
    wal_records,
    wal_fpi,
    wal_bytes
FROM pg_stat_wal;
预期结果
datname | blks_read | blks_hit | temp_files | temp_bytes | xact_commit | xact_rollback
--------+-----------+----------+------------+------------+-------------+--------------
<VALUE> | <VALUE>   | <VALUE>  | <VALUE>    | <VALUE>    | <VALUE>     | <VALUE>

wal_records | wal_fpi | wal_bytes
------------+---------+----------
<VALUE>     | <VALUE> | <VALUE>
这些值都是累计统计,实际数值会不同,应通过两次采样求时间窗口增量。若任务在较小批次下稳定,扩大批次后平均吞吐反而下降,应优先缩短事务并限制单批处理量,而不是继续扩大批次。归档关注的是可持续吞吐,而不是让单个事务一次搬走尽可能多的数据。
检查目标端是否成为瓶颈
源端读取、锁和资源压力都正常时,要把计时点放到目标端写入和提交阶段。如果读取并传输 5000 行耗时稳定,而目标端 INSERT、COPY 或事务提交持续变慢,瓶颈已经不在源表扫描路径。
目标端应结合 CPU、存储延迟、检查点、索引数量和并发写入进行判断。归档表如果维护大量并不服务历史查询的索引,每批写入都需要同步更新这些索引,随着数据规模增长可能逐渐拖低写入吞吐。
可以在目标库查看写入会话当前处于执行还是等待状态。
SELECT
    pid,
    state,
    wait_event_type,
    wait_event,
    now() - xact_start AS transaction_age,
    query
FROM pg_stat_activity
WHERE datname = current_database()
  AND state <> 'idle';
预期结果
pid  | state   | wait_event_type | wait_event | transaction_age | query
-----+---------+-----------------+------------+-----------------+------
<ID> | <VALUE> | <VALUE>         | <VALUE>    | <TIME>          | <VALUE>
如果目标端已成为瓶颈,应根据历史查询需求评估是否存在可删除的冗余索引,同时控制并发归档任务、改善存储性能或调整写入方式。仅在源端增加更多工作线程,通常只会把更多写入压力推向已经饱和的目标端。
按证据选择修复动作
归档变慢可以固定按这条路径定位:先分阶段计时,再检查候选查询计划;执行计划正常则检查锁和等待事件;没有等待瓶颈再观察源端 I/O、WAL 与批次大小;最后确认目标端写入和提交性能。这样可以避免在没有证据时同时调整批次、索引和并发度。
修复后应使用与故障时相同的数据范围和批次大小重新测量,比较单批耗时、处理行数、等待时间以及连续多个批次的平均吞吐。只有吞吐恢复,并且没有把压力转移成新的锁等待、WAL 积压、磁盘瓶颈或目标端排队,才算真正解决归档任务执行变慢的问题。