
PostgreSQL / 系统课时
注入归档失败与容量故障
注入归档失败与容量故障
本节把生命周期治理从“正常路径可运行”推进到“异常时可控”:在隔离演练环境中可重复注入 worker 中断、归档积压、物理复制回放延迟和容量门禁失败,并验证任务能否正确暂停、重试与恢复。
学习目标
- 能用可撤销步骤注入四类归档故障,并记录演练批次。
- 能区分归档积压、复制回放延迟与复制槽 WAL 保留量,选择正确观测指标。
- 能验证故障解除后任务进度、归档数据和门禁状态一致。
建立可撤销的演练边界
只在隔离环境或审批后的演练窗口执行。固定归档边界、批次大小和恢复目标,不使用填满磁盘、删除 WAL 文件或强杀主库等不可逆手段。下面先创建演练状态表和一张模拟待归档队列表,后续四类故障都围绕这组对象进行。
CREATE TABLE IF NOT EXISTS lifecycle_drill_run (
    run_id bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    fault_type text NOT NULL,
    status text NOT NULL,
    started_at timestamptz NOT NULL DEFAULT now(),
    finished_at timestamptz,
    note text
);

CREATE TABLE IF NOT EXISTS lifecycle_drill_queue (
    id bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    created_at timestamptz NOT NULL DEFAULT now(),
    archived_at timestamptz
);

INSERT INTO lifecycle_drill_run (fault_type, status, note)
VALUES ('worker_interrupt', 'RUNNING', 'archive drill')
RETURNING run_id, fault_type, status;
预期结果
 run_id |    fault_type    | status
--------+------------------+---------
 <ID>   | worker_interrupt | RUNNING
<ID> 为实际生成的批次编号。
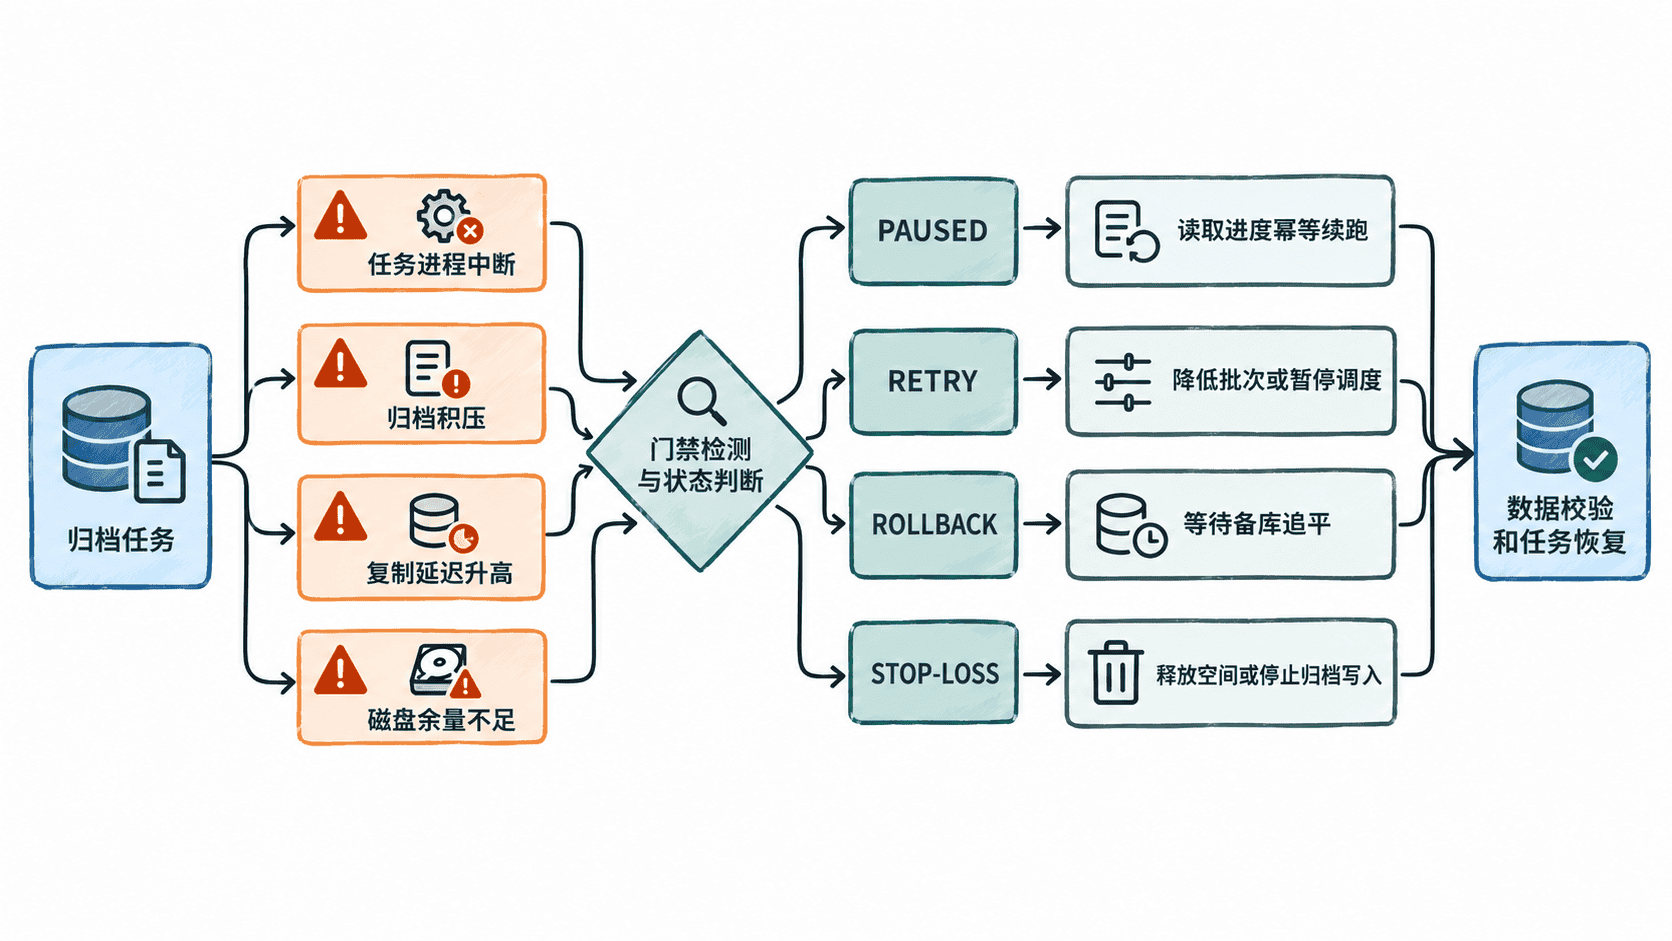
注入 worker 中断与归档积压
先启动一个可识别的演练 worker,让它在事务中处理队列并停留数十秒;另一个会话按 application_name 精确终止该连接。这样可以验证事务回滚和后续幂等重试,而不会误杀其他数据库会话。
会话 A:
SET application_name = 'archive_drill_worker';
BEGIN;
INSERT INTO lifecycle_drill_queue DEFAULT VALUES;
SELECT pg_sleep(30);
UPDATE lifecycle_drill_queue
SET archived_at = now()
WHERE archived_at IS NULL;
COMMIT;
会话 B 在 pg_sleep 期间执行:
SELECT pg_terminate_backend(pid)
FROM pg_stat_activity
WHERE application_name = 'archive_drill_worker'
  AND pid <> pg_backend_pid();
预期结果
 pg_terminate_backend
----------------------
 t
会话 A 会断开,未提交事务会回滚。重新连接后执行 SELECT count(*) FROM lifecycle_drill_queue WHERE archived_at IS NULL;,应看到本次未提交写入没有留下半完成状态。
积压演练先停止归档 worker,再一次性插入可控数量的待处理记录:
INSERT INTO lifecycle_drill_queue (created_at)
SELECT now() - interval '1 day'
FROM generate_series(1, 10000);

SELECT count(*) AS backlog_rows
FROM lifecycle_drill_queue
WHERE archived_at IS NULL;
预期结果
 backlog_rows
--------------
 10000
实际数量可能叠加已有演练数据。恢复 worker 后应观察积压持续下降;如果下降速度长期小于新增速度,应减小单事务批次、提高调度频率或暂停在线清理,避免积压和写放大同时恶化。
注入并观测物理复制回放延迟
物理备库的回放延迟应通过 pg_stat_replication 观察,而不是用 pg_replication_slots.restart_lsn 代替。restart_lsn 反映槽消费者仍可能需要的最早 WAL 位置,适合判断 WAL 保留压力,但不等价于备库 replay lag。
在演练备库上暂停 WAL 回放:
SELECT pg_wal_replay_pause();
SELECT pg_is_wal_replay_paused();
预期结果
 pg_is_wal_replay_paused
-------------------------
 t
随后在主库制造一小段可控 WAL:
INSERT INTO lifecycle_drill_queue (created_at)
SELECT now()
FROM generate_series(1, 5000);

SELECT application_name,
       write_lag,
       flush_lag,
       replay_lag,
       pg_wal_lsn_diff(pg_current_wal_lsn(), replay_lsn) AS replay_bytes
FROM pg_stat_replication;
预期结果
 application_name | write_lag | flush_lag | replay_lag | replay_bytes
------------------+-----------+-----------+------------+-------------
<VALUE> | <VALUE> | <VALUE> | <VALUE> | <VALUE>暂停回放后,replay_lag 或 replay_bytes 应随主库继续产生 WAL 而增大。达到演练阈值后,归档调度器应进入 PAUSED,停止新的大批量删除。演练结束必须在备库执行 SELECT pg_wal_replay_resume();,并确认 pg_is_wal_replay_paused() 返回 f。
注入容量门禁失败
容量故障不需要真的写满磁盘。可以把测试阈值故意设置为“当前可用空间加 1 字节”,强制门禁拒绝新批次,同时保留真实文件系统不受损。
DATA_DIR="${PGDATA:?PGDATA is required}"
FREE_BYTES=$(df -PB1 "$DATA_DIR" | awk 'NR==2 {print $4}')
TEST_MIN_FREE_BYTES=$((FREE_BYTES + 1))

if [ "$FREE_BYTES" -lt "$TEST_MIN_FREE_BYTES" ]; then
  echo "PAUSED disk_free_below_threshold free=$FREE_BYTES threshold=$TEST_MIN_FREE_BYTES"
  exit 2
fi
预期输出
PAUSED disk_free_below_threshold free=<VALUE> threshold=<VALUE>脚本退出码应为 2。这类注入验证的是容量门禁本身:调度器不得启动新归档批次,也不得继续大批量 DELETE。演练结束后恢复真实阈值并重新检查磁盘余量。
验证恢复后的数据与门禁
故障解除后不能只看任务重新运行,还要确认积压、归档进度和复制状态都回到允许区间。先核对模拟队列是否仍有待处理记录,再确认备库恢复回放。
SELECT count(*) AS remaining_backlog
FROM lifecycle_drill_queue
WHERE archived_at IS NULL;

SELECT application_name,
       state,
       replay_lag,
       pg_wal_lsn_diff(pg_current_wal_lsn(), replay_lsn) AS replay_bytes
FROM pg_stat_replication;
预期结果
 remaining_backlog
-------------------
 <VALUE>

 application_name |   state   | replay_lag | replay_bytes
------------------+-----------+------------+-------------
 <VALUE>          | streaming | <VALUE>    | <VALUE>
<VALUE> 随环境变化。恢复条件应同时满足:失败原因已消除、积压趋势可控、复制回放继续推进、容量门禁恢复正常,并且同一批次的重复执行不会产生重复归档或漏处理。只有这些检查通过后,任务才应从 PAUSED 回到 RUNNING。