
PostgreSQL / 系统课时
执行在线归档与历史清理
执行在线归档与历史清理
本课把生命周期方案落到一次可控的在线执行中:冻结归档边界,以固定小批次复制历史数据,在事务内验证本批数据已经进入归档表后再删除源记录,并持续观察锁、WAL、复制延迟和业务响应,确保任务能够暂停、重试和安全续跑。
学习目标
- 按固定边界和小批次执行可重入的在线归档
- 在删除源数据前完成本批完整性验证
- 根据复制延迟和业务压力决定继续、节流或暂停
冻结本次归档范围
执行前先确定不会变化的 cutoff。例如策略要求只保留六个月在线数据,可以在任务启动时计算一次边界,并把它与任务 ID、批次状态一起持久化。运行过程中不要反复按当前时间重新计算,否则长任务的处理范围会不断向前移动。
下面的查询用于确认固定边界内仍有多少候选数据,并预览下一批。使用 (occurred_at, id) 排序可以为批次选择提供稳定顺序。
SELECT id, occurred_at, payload
FROM event_log
WHERE occurred_at < TIMESTAMP '2026-03-01 00:00:00'
ORDER BY occurred_at, id
LIMIT 1000;
预期结果
   id   |     occurred_at      | payload
--------+----------------------+---------
 <ID>   | <TIME>               | <VALUE>
 ...    | ...                  | ...
(1000 rows or fewer)
真实批次可能少于 1000 行;结果为 0 行时,说明这个固定边界内已经没有待处理记录。
按复制、验证、删除顺序提交
安全批次不能先删后传。推荐顺序是锁定本批主键、幂等写入归档表、验证归档表已完整覆盖本批主键,再删除对应源记录并提交。生产任务还应为每批保存稳定的 batch_key 和状态,例如 SELECTED、COPIED、VERIFIED、DELETED,让失败重启后能够判断该批已经完成到哪一步,并从最近一个已确认状态继续,而不是重复猜测执行进度。
以下主示例适用于在线表与归档表位于同一 PostgreSQL 数据库的演练环境。临时表保存当前批次主键;验证失败会抛出异常并回滚,因此删除不会发生在验证之前。归档表需要对 id 建立唯一约束,以支持重试时的幂等写入。
BEGIN;

CREATE TEMP TABLE archive_batch_ids (
    id bigint PRIMARY KEY
) ON COMMIT DROP;

INSERT INTO archive_batch_ids (id)
SELECT id
FROM event_log
WHERE occurred_at < TIMESTAMP '2026-03-01 00:00:00'
ORDER BY occurred_at, id
LIMIT 1000
FOR UPDATE SKIP LOCKED;

INSERT INTO archive_event_log
SELECT e.*
FROM event_log AS e
JOIN archive_batch_ids AS b USING (id)
ON CONFLICT (id) DO NOTHING;

DO $$
BEGIN
    IF EXISTS (
        SELECT 1
        FROM archive_batch_ids AS b
        LEFT JOIN archive_event_log AS a USING (id)
        WHERE a.id IS NULL
    ) THEN
        RAISE EXCEPTION 'archive verification failed: batch contains missing rows';
    END IF;
END
$$;

DELETE FROM event_log AS e
USING archive_batch_ids AS b
WHERE e.id = b.id;

COMMIT;
预期结果
BEGIN
CREATE TABLE
INSERT 0 <VALUE>
INSERT 0 <VALUE>
DO
DELETE <VALUE>
COMMIT
各处 <VALUE> 会随批次规模和是否属于重试而变化。第二个 INSERT 在重试时可能插入 0 行,但只要验证确认归档表已经包含本批全部主键,仍可安全进入删除步骤。若验证发现缺失行,DO 会报错,当前事务回滚,源数据不会被删除。
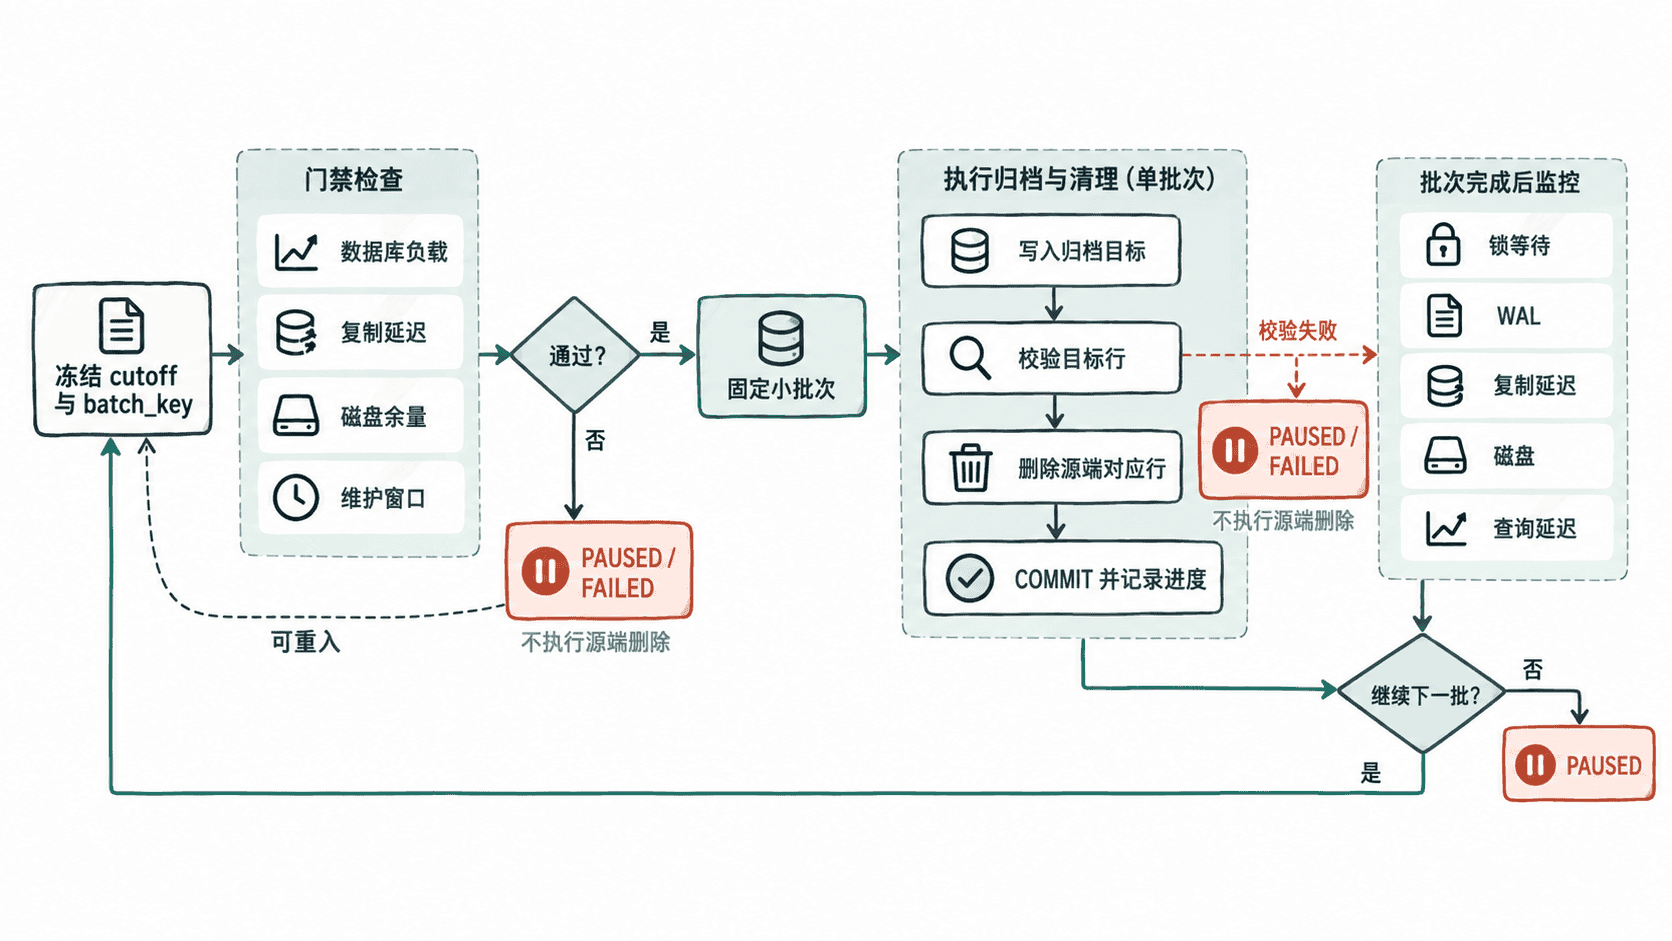
跨数据库归档不能依赖一个 PostgreSQL 本地事务同时覆盖源库和归档库。此时应把 batch_key、主键集合和阶段状态持久化,并通过目标端唯一键、幂等写入和删除前重新验证来获得相同的可恢复语义。
增加业务完整性验证
主键全部存在只能证明本批没有漏传。对高价值数据,还应在删除前比较关键业务字段、聚合值或确定性抽样结果,例如核对金额总和、租户维度数量或不可变摘要。验证范围必须直接来自当前批次保存的主键集合,而不是重新执行一个随并发数据变化的宽泛时间条件。
如果归档表与源表字段一致,可以先检查本批行数是否匹配。
SELECT
    (SELECT count(*) FROM archive_batch_ids) AS batch_rows,
    (SELECT count(*)
     FROM archive_event_log AS a
     JOIN archive_batch_ids AS b USING (id)) AS archived_rows;
预期结果
 batch_rows | archived_rows
------------+--------------
 <VALUE>    | <VALUE>
进入删除阶段前,两列应相等;如果业务字段还需要更强校验,应在同一批次主键范围内完成并把结果记录到任务日志。
持续观察资源压力
每次批次提交后都要重新判断系统是否允许继续。长事务会延长锁和旧版本生命周期,大批量 DELETE 会产生 WAL、索引维护和 I/O 压力;流复制环境还要关注任务是否造成备库追赶困难。
可以用下面的查询观察当前流复制状态。write_lag、flush_lag 和 replay_lag 在没有可报告延迟时可能为 NULL,不能把空值直接解释为复制故障。
SELECT application_name,
       state,
       write_lag,
       flush_lag,
       replay_lag
FROM pg_stat_replication;
预期结果
 application_name |   state   | write_lag | flush_lag | replay_lag
------------------+-----------+-----------+-----------+-----------
 <VALUE>          | streaming | <VALUE>   | <VALUE>   | <VALUE>
实际延迟值会随负载变化。若复制延迟、业务查询时间、锁等待、WAL 增长或磁盘余量突破预设门禁,应停止获取新批次,让正在执行的短事务正常结束,而不是继续堆积工作。
保留批次证据
任务结束或暂停时,应能从运行记录回答本次使用哪个 cutoff、执行过哪些 batch_key、每批处于什么状态、复制和删除各有多少行、哪些验证通过以及为何暂停。不要在任务退出时清除这些记录,它们既是断点续跑依据,也是审计与排障证据。
一次合格的在线归档不是“SQL 执行成功”就结束,而是每批源数据只在目标端确认可用且验证通过后才被清理,资源压力始终受门禁约束,并且任务中断后能够依据明确的批次状态继续执行。