
PostgreSQL / 系统课时
判断何时应该使用分区表
判断何时应该使用分区表
分区表不是“大表自动优化开关”。本课从查询裁剪、历史数据维护和归档操作三个角度判断是否值得分区,并通过 PostgreSQL 示例验证分区裁剪,避免因为表变大就过早引入额外管理复杂度。
学习目标
- 判断业务访问模式是否具备稳定、可利用的分区键。
- 理解分区裁剪和按分区维护带来的主要收益。
- 识别分区表不能解决的问题以及不适合分区的场景。
先判断问题是不是分区能解决的
分区最有价值的场景通常同时具备两个特征:数据可以沿稳定维度切分,而且查询或生命周期操作经常只涉及其中一部分。日志、订单历史、事件流水等按时间持续增长的数据,经常满足这一条件。
如果主要问题只是某条查询缺少索引、统计信息失真或 SQL 写法低效,改成分区表并不会自动解决根因。分区首先是一种数据组织和管理手段,其次才可能通过分区裁剪减少扫描范围。
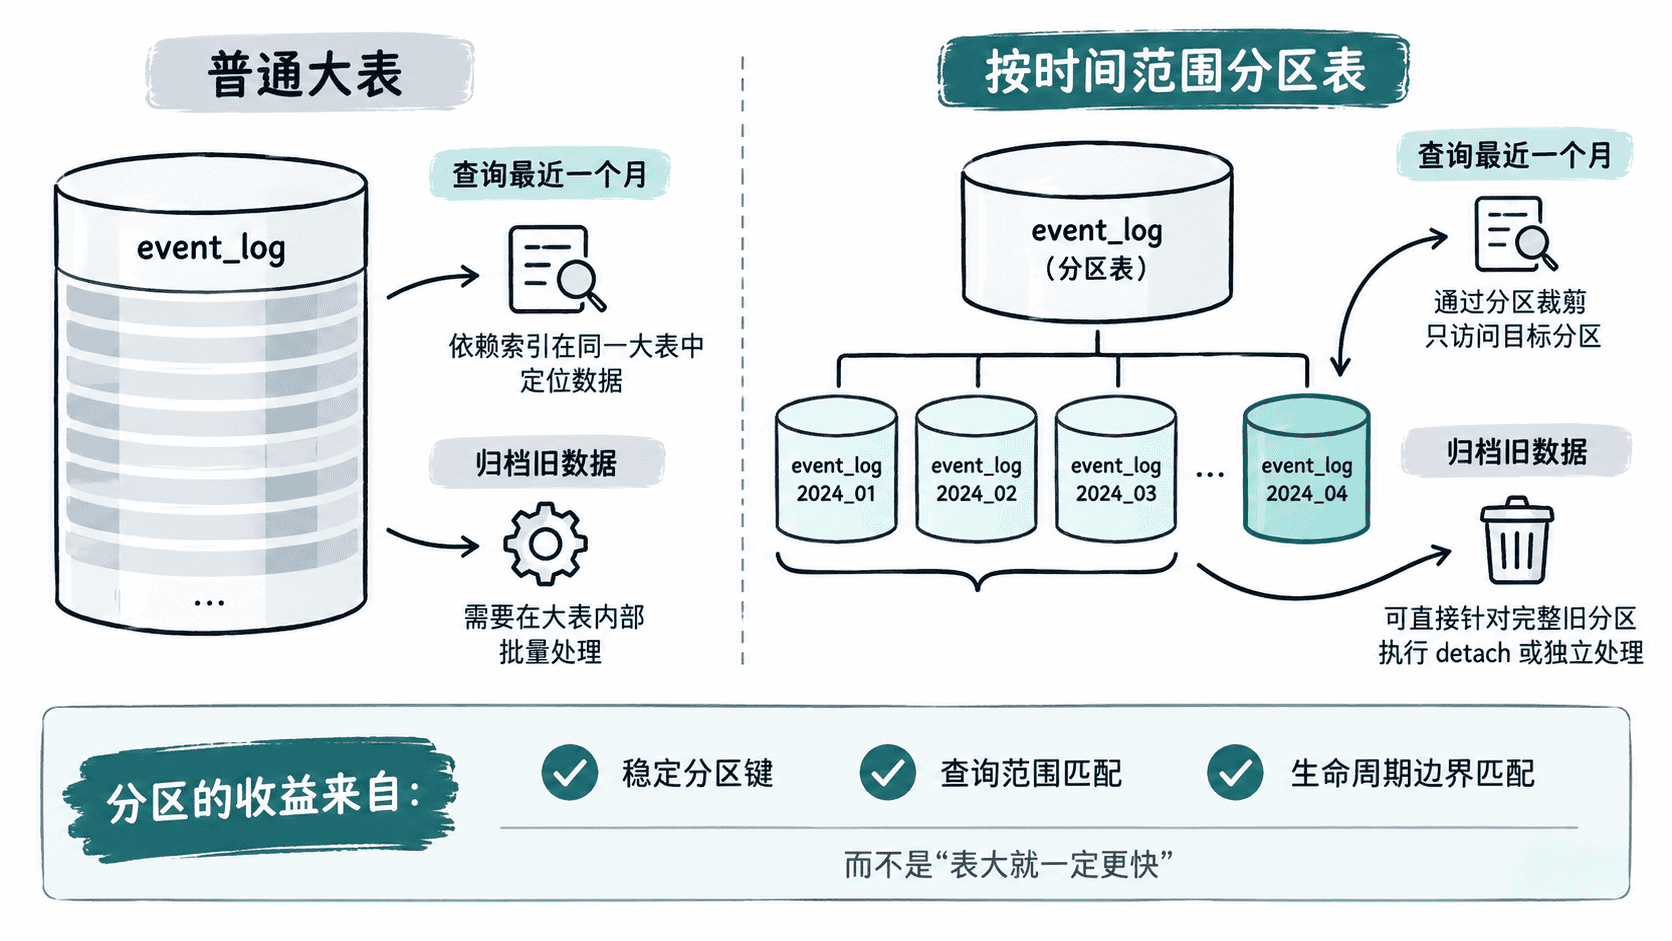
适合分区的三个信号
第一个信号是查询条件经常包含分区键。例如绝大多数查询都带有 created_at 时间范围,按月或按日分区后,规划器可以根据查询谓词与分区边界排除不可能包含目标数据的分区,只扫描相关子表。只有主要查询能够稳定使用分区键,这种裁剪收益才会持续出现;如果大量查询缺少该条件,分区反而可能让一次查询涉及许多子表。
第二个信号是生命周期边界和分区边界能够对齐。如果策略要求整月归档两年前的数据,那么月分区天然适合整块脱离、迁移或删除,而不必长期执行大批量行级删除。
第三个信号是单表维护已经成为稳定痛点,例如历史索引持续膨胀、维护窗口过长,或者需要对不同时间段独立执行归档和清理。分区让这些操作获得更小、更明确的管理单元。
建立一个最小时间分区表
下面创建一个按 created_at 做月范围分区的事件表,并准备两个相邻月份的分区。
CREATE TABLE event_log (
    id bigint NOT NULL,
    created_at timestamptz NOT NULL,
    payload jsonb NOT NULL
) PARTITION BY RANGE (created_at);

CREATE TABLE event_log_2026_01 PARTITION OF event_log
FOR VALUES FROM ('2026-01-01 00:00:00+00') TO ('2026-02-01 00:00:00+00');

CREATE TABLE event_log_2026_02 PARTITION OF event_log
FOR VALUES FROM ('2026-02-01 00:00:00+00') TO ('2026-03-01 00:00:00+00');
预期结果
CREATE TABLE
CREATE TABLE
CREATE TABLE
范围分区的上界是不包含的,因此一月分区接收从 2026-01-01 00:00:00+00 开始、但早于 2026-02-01 00:00:00+00 的记录。这种首尾相接的边界可以避免月份之间出现重叠或空洞。
验证查询是否真的发生裁剪
插入两个月的数据后,用带明确时间范围的查询查看执行计划。这里把插入和验证放在同一个主示例中,便于直接观察分区裁剪是否生效。
INSERT INTO event_log (id, created_at, payload) VALUES
    (1, '2026-01-15 08:00:00+00', '{"type":"login"}'),
    (2, '2026-02-10 09:00:00+00', '{"type":"purchase"}');

EXPLAIN
SELECT id, created_at
FROM event_log
WHERE created_at >= '2026-02-01 00:00:00+00'
  AND created_at <  '2026-03-01 00:00:00+00';
预期结果
INSERT 0 2
                         QUERY PLAN
-------------------------------------------------------------
 Seq Scan on event_log_2026_02 event_log  (cost=<VALUE>..<VALUE> rows=<VALUE> width=<VALUE>)
   Filter: ((created_at >= <VALUE>) AND (created_at < <VALUE>))
成本、估算行数以及条件的具体显示形式会随 PostgreSQL 版本、统计信息和环境变化,实际值可能不同;关键是执行计划中只出现 event_log_2026_02,而不访问一月分区。这才是按时间分区对该查询产生实际价值的证据。
不要为了表大而分区
如果查询几乎从不包含候选分区键,规划器就难以排除无关分区,查询可能仍需访问许多子表。分区数量过多还会增加规划、对象管理、监控和变更成本。
另一个常见误区是希望分区解决所有写入压力。热点数据如果集中在当前一个分区,简单的时间分区并不会把该热点自动分散到多个节点或磁盘,也不会改变 PostgreSQL 单实例的基本并发边界。
选择分区粒度时同样不能只追求更小。按天分区会比按月产生更多对象;如果每月数据规模已经容易维护,而归档策略也是整月执行,继续细分为日分区通常只会增加操作复杂度。
是否采用分区表,可以用一句话判断:当稳定分区键同时出现在主要查询条件和生命周期操作中,并且整块管理数据的收益已经超过额外复杂度时,分区才值得引入。