
PostgreSQL / 系统课时
恢复已归档历史数据
恢复已归档历史数据
历史数据被归档后,仍可能因审计、客服追溯或专项分析被再次访问。本课根据数据是否需要重新参与在线业务,选择直接只读查询、隔离恢复或受控回灌,并把结构验证、冲突检查和恢复后的生命周期边界纳入同一流程。
学习目标
- 根据访问目的选择只读访问、局部恢复或受控回灌方案
- 用独立恢复区验证数据和结构语义,再决定是否写回在线表
- 为恢复操作设置范围、冲突门禁和清理边界
先选择恢复路径
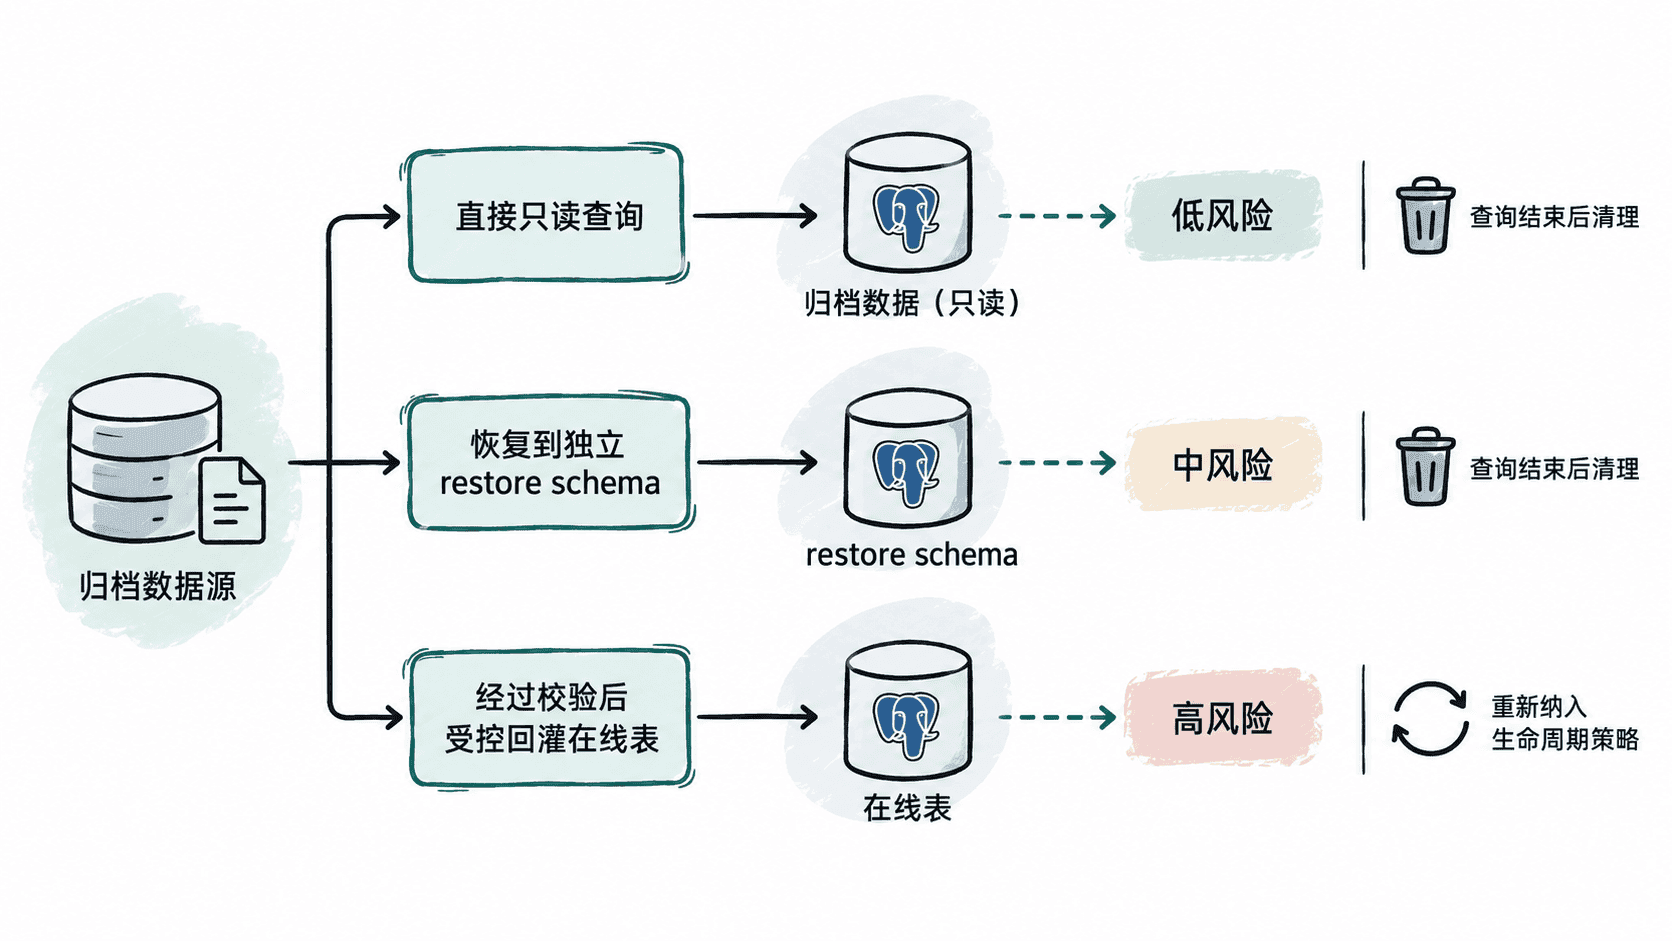
恢复方式应由“历史数据是否需要重新参与在线业务”决定,而不是一出现历史查询需求就直接回灌主表。只做审计、报表或人工核对时,优先直接查询归档表或归档库;需要和当前数据联查但不参与线上写入时,可恢复到独立只读区域;只有业务逻辑确实要求这些历史行重新进入在线状态时,才执行受控回灌。
在独立恢复区做局部恢复
下面假设在线表为 public.orders,归档表为 archive.orders_2025。示例先用 CTAS 把目标月份的数据放入独立 schema,适合临时取数和核对。需要特别注意:CREATE TABLE ... AS 只根据查询结果创建列及其数据类型,不会复制在线表的主键、唯一约束、外键、检查约束、默认值、identity、generated 属性、索引、触发器、权限等对象,因此恢复区只是数据核对容器,不能被视为在线表的完整结构副本。
CREATE SCHEMA IF NOT EXISTS restore_work;

DROP TABLE IF EXISTS restore_work.orders_restore;

CREATE TABLE restore_work.orders_restore AS
SELECT *
FROM public.orders
WITH NO DATA;

INSERT INTO restore_work.orders_restore
SELECT *
FROM archive.orders_2025
WHERE created_at >= TIMESTAMP '2025-10-01 00:00:00'
  AND created_at <  TIMESTAMP '2025-11-01 00:00:00';

SELECT count(*) AS restored_rows,
       min(created_at) AS min_created_at,
       max(created_at) AS max_created_at
FROM restore_work.orders_restore;
预期结果
CREATE SCHEMA
DROP TABLE
CREATE TABLE AS
INSERT 0 <VALUE>
 restored_rows |   min_created_at    |   max_created_at
---------------+---------------------+---------------------
 <VALUE>       | 2025-10-01 <TIME>   | 2025-10-31 <TIME>
<VALUE> 与 <TIME> 取决于实际归档数据。验证时至少核对行数、时间边界和 id 等业务标识。这里能确认的是列值是否符合预期,而不是主键、默认值或 identity 等数据库语义是否仍然存在;如果恢复任务需要验证这些行为,应根据当前在线表 DDL 显式创建恢复表及必要约束,而不是使用 CTAS。
需要回灌时先做门禁
回灌在线表前至少确认三类条件:恢复数据自身没有重复业务主键;目标主键在在线表中的冲突策略已经明确;这些历史行重新进入在线表后,不会重新触发已经失效的业务流程或立即命中下一轮归档规则。下面把重复检查、在线冲突检查和受控写回放在一个主示例中。
-- 恢复区没有主键约束,因此先按业务标识检查源数据自身重复。
SELECT id, count(*) AS duplicate_count
FROM restore_work.orders_restore
GROUP BY id
HAVING count(*) > 1
LIMIT 20;

-- 再确认当前在线表中是否已经存在同一业务主键。
SELECT r.id
FROM restore_work.orders_restore AS r
JOIN public.orders AS o USING (id)
LIMIT 20;

-- 只有前两项检查符合门禁时才执行写回。
INSERT INTO public.orders
SELECT *
FROM restore_work.orders_restore
ON CONFLICT (id) DO NOTHING;
预期结果
 id | duplicate_count
----+-----------------
(0 rows)

 id
----
(0 rows)

INSERT 0 <VALUE>
<VALUE> 是实际插入行数。ON CONFLICT (id) 依赖在线表上能够推断该冲突目标的唯一约束或唯一索引,它只能处理目标表冲突,不能替代前面对恢复数据自身重复的核对。
上述 INSERT ... SELECT * 还要求恢复表与当前在线表的可写列在数量、顺序和类型上兼容。若在线表包含 generated 列、GENERATED ALWAYS AS IDENTITY 列,或者归档期间发生过加列、删列、改类型、默认值或约束变化,应显式列出插入列,并按当前 DDL 处理这些字段。生产环境还应记录恢复批次、筛选条件、操作者、校验结果和实际影响行数。
恢复结束后重新建立边界
临时恢复区不应长期演化成第二套在线库。查询或回灌完成并确认结果已交付后,应删除临时恢复表;如果部分历史数据重新纳入在线业务,还要同步调整其保留期限、归档条件或豁免规则,避免下一轮任务马上再次归档。
DROP TABLE IF EXISTS restore_work.orders_restore;预期结果
DROP TABLE安全的恢复顺序是:先从归档源按范围取数,在隔离区域验证数据及当前结构假设,再通过重复与冲突门禁决定是否写回在线表,最后清理临时对象并重新确认生命周期策略。这样既能满足偶发历史访问,也不会因为一次恢复任务破坏冷热数据边界。