
PostgreSQL / 系统课时
验证归档数据完整性
验证归档数据完整性
归档文件成功导入并不等于数据已经可靠迁移。真正的验收需要同时核对数据量、时间与主键边界、关键业务聚合以及具体样本,确保归档前后的数据集合一致,并能在需要时重新读取和恢复。
学习目标
- 使用行数与边界值快速发现漏数、重数和范围错误
- 通过聚合校验与抽样比对提高数据完整性验证强度
- 建立可重复执行的归档验收 SQL,并据此决定是否允许删除源数据
从相同数据边界开始验证
完整性校验的前提是源端和归档端查询同一个集合。假设归档批次已经冻结为 created_at < '2025-01-01 00:00:00+00',所有源端校验 SQL 都必须继续使用这一固定边界,而不是重新计算一个新的日期条件。
首先在源表统计归档范围内的记录数和边界。
SELECT
    count(*) AS row_count,
    min(id) AS min_id,
    max(id) AS max_id,
    min(created_at) AS min_created_at,
    max(created_at) AS max_created_at
FROM orders
WHERE created_at < TIMESTAMPTZ '2025-01-01 00:00:00+00';
预期结果
 row_count | min_id | max_id |     min_created_at      |     max_created_at
-----------+--------+--------+-------------------------+-------------------------
<VALUE> | <ID> | <ID> | <TIME> | <TIME>在归档端对对应批次执行同样的统计。行数相同是最低要求;min、max 也应匹配,用来排除错误时间窗口、遗漏头尾数据以及误导入其他批次的问题。
用业务聚合发现内容偏差
第二层验证应选择稳定、容易计算且能反映业务分布的字段。例如订单归档可以比较状态分布和金额合计。不要只计算一个总金额;按低基数字段分组可以更容易定位哪个数据子集发生偏差。
SELECT
    status,
    count(*) AS row_count,
    sum(amount) AS total_amount
FROM orders
WHERE created_at < TIMESTAMPTZ '2025-01-01 00:00:00+00'
GROUP BY status
ORDER BY status;
预期结果
 status  | row_count | total_amount
---------+-----------+-------------
 <VALUE> | <VALUE>   | <VALUE>
在归档表执行同等逻辑后,应逐组比较 status、行数和金额合计。若某一状态存在差异,可以进一步把查询缩小到该状态,而不必重新扫描和人工检查整个归档批次。
对于金额、浮点数或可能经过类型转换的字段,应确认源表与归档表的数据类型和舍入规则一致。否则“聚合不同”可能来自类型转换,而不是实际漏数。
做确定性的抽样比对
随机抽样适合快速检查,但每次抽取不同记录会让验证难以重复。归档任务更适合采用确定性样本,例如主键最小值、最大值以及按照主键取模选择的固定集合。
SELECT id, customer_id, status, amount, created_at
FROM orders
WHERE created_at < TIMESTAMPTZ '2025-01-01 00:00:00+00'
  AND id % 1000 = 0
ORDER BY id
LIMIT 100;
预期结果
 id   | customer_id | status  | amount  | created_at
------+-------------+---------+---------+-------------------------
 <ID> | <ID>        | <VALUE> | <VALUE> | <TIME>
归档端执行相同条件后,结果应逐行一致。固定规则的优势是可以在故障重试、恢复演练和后续审计中重新得到同一批样本。
直接比对源端与归档端数据集
如果源数据和归档数据能够临时出现在同一个 PostgreSQL 实例中,可以利用集合差异查询精确找出不一致记录。下面假设 orders 是源表,archive_orders 是已导入的归档表。
SELECT id, customer_id, status, amount, created_at
FROM orders
WHERE created_at < TIMESTAMPTZ '2025-01-01 00:00:00+00'
EXCEPT
SELECT id, customer_id, status, amount, created_at
FROM archive_orders;
预期结果
(0 rows)还必须交换两张表再执行一次 EXCEPT,因为单向差集只能发现“源端存在但归档端不存在”的记录,不能发现归档端额外多出的记录。
SELECT id, customer_id, status, amount, created_at
FROM archive_orders
EXCEPT
SELECT id, customer_id, status, amount, created_at
FROM orders
WHERE created_at < TIMESTAMPTZ '2025-01-01 00:00:00+00';
预期结果
(0 rows)两次结果都为零行时,才表示在所选字段范围内两个集合互相包含。对于超大归档批次,直接全量 EXCEPT 可能带来较高 CPU、内存和 I/O 成本,应优先按日期分片或主键区间逐段验证。
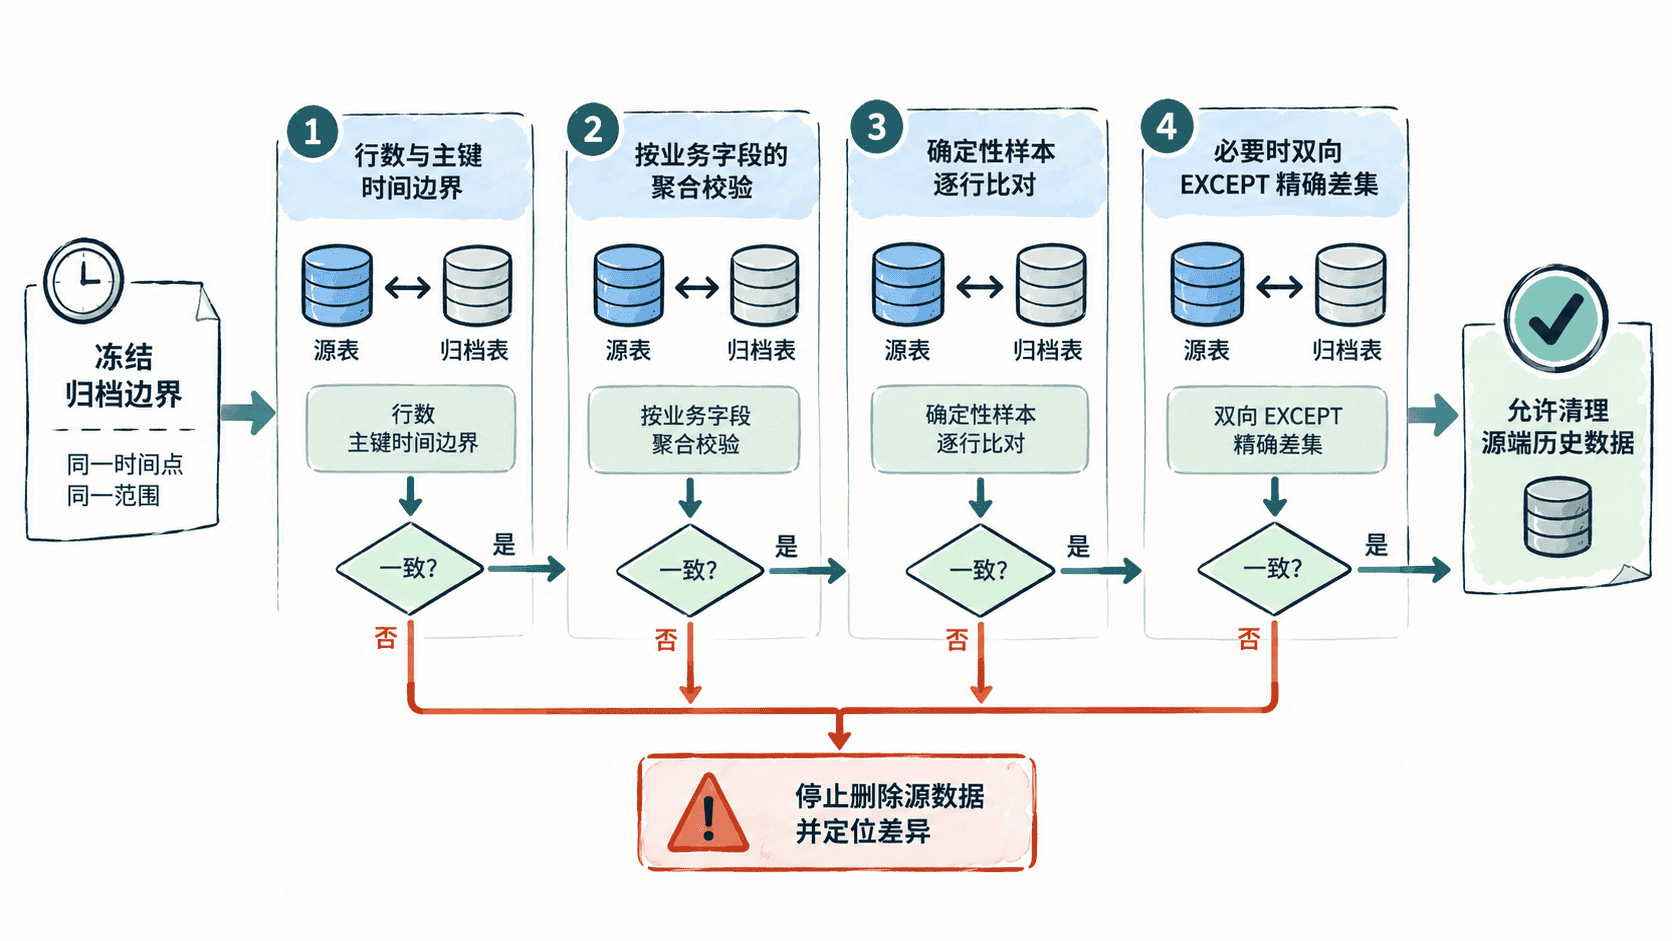
把验证结果变成删除门禁
完整性验证不应依赖人工记忆,而应形成明确的放行条件。至少需要保存本批次的固定时间边界、源端与归档端行数、边界值、关键聚合结果、抽样规则以及执行时间。只要任一层结果不同,就应暂停删除源表历史数据。
归档库还应做一次可读性验证,例如在目标端根据主键查询一条已知记录,确认数据不仅存在,而且能够被正常读取。若归档目标承担灾难恢复职责,还应定期将归档副本恢复到独立环境,再执行同一套校验 SQL。
归档完整性的核心不是追求一个看似复杂的校验值,而是建立由粗到细、可以重复执行的证据链:先确认数量和边界,再核对业务聚合和固定样本,必要时执行双向集合差异检查。只有所有门禁通过后,源端历史数据才具备安全清理条件。