
PostgreSQL / 系统课时
编排周期性归档任务
编排周期性归档任务
周期性归档不能只靠一条“大批量搬走旧数据”的 SQL。稳定方案需要为每轮作业冻结归档边界,并同时控制单批规模、允许运行的时间窗口和并发实例数,让任务能够重复执行、观察进度并在负载升高时及时停止。
学习目标
- 把归档任务拆成复用固定 cutoff 的短事务批次
- 用时间窗口和 advisory lock 限制任务对在线负载的影响
- 根据批次结果和系统负载决定继续执行、暂停或告警
每轮只冻结一次 cutoff
假设在线表为 public.events,归档表为 archive.events,策略要求保留最近 180 天数据。周期任务可以在每一轮作业启动时重新计算归档边界,但同一轮中的所有批次都应复用这一个 cutoff。这样即使一轮持续较久,归档范围也不会随着当前时间不断向前移动。
主脚本在同一个 psql 会话中先获取会话级 advisory lock,再计算一次 cutoff,并执行一个最多归档 5000 行的短事务。脚本只允许在本地时间 01:00 到 05:59 启动。
#!/usr/bin/env bash
set -euo pipefail

DB_URL="${DB_URL:?DB_URL is required}"
HOUR="$(date +%H)"

if (( 10#$HOUR < 1 || 10#$HOUR >= 6 )); then
  echo "outside archive window"
  exit 0
fi

psql "$DB_URL" -v ON_ERROR_STOP=1 <<'SQL'
SELECT pg_try_advisory_lock(741852963) AS locked \gset

\if :locked
SELECT now() - interval '180 days' AS cutoff \gset
\echo 'archive cutoff:' :cutoff

BEGIN;

WITH moved AS (
    DELETE FROM public.events
    WHERE id IN (
        SELECT id
        FROM public.events
        WHERE occurred_at < :'cutoff'::timestamptz
        ORDER BY occurred_at, id
        LIMIT 5000
        FOR UPDATE SKIP LOCKED
    )
    RETURNING *
)
INSERT INTO archive.events
SELECT *
FROM moved;

COMMIT;
SELECT pg_advisory_unlock(741852963);
\else
\echo 'archive job already running'
\endif
SQL
预期输出
archive cutoff: <TIME>
BEGIN
INSERT 0 <VALUE>
COMMIT
 pg_advisory_unlock
--------------------
 t
<TIME> 是本轮启动时冻结的 cutoff,<VALUE> 是本批实际归档行数,可能小于 5000。若已有实例持有相同 advisory lock,则输出 archive job already running,本轮不会重复执行。这里使用会话级 advisory lock;即使脚本因 ON_ERROR_STOP 提前退出,数据库连接关闭时 PostgreSQL 也会释放该会话持有的锁。
这个示例只执行一个批次。如果一个调度实例需要连续处理多批,应把 cutoff 在作业启动时计算一次并保存下来,后续批次继续传入同一个值,而不是每批重新执行 now() - interval '180 days'。
理解同库事务的原子性边界
示例中的执行顺序实际是先通过 DELETE ... RETURNING 从源表产生待归档行,再把这些行插入 archive.events。当源表和归档表位于同一个 PostgreSQL 数据库并处于同一事务时,如果目标表插入因约束冲突或其他错误失败,整个事务都会回滚,因此源表删除也不会提交。
这意味着,同库单事务场景下,“删除并返回,再插入归档表”可以依赖数据库事务保证两步原子提交,并不会留下只删除未归档的已提交状态。
短事务还能降低长时间持锁、WAL 峰值和大事务回滚成本。FOR UPDATE SKIP LOCKED 会跳过当前被其他事务锁定的候选行,使归档任务不必为了少量热点记录长期等待;这些被跳过的行可以留给后续轮次重新处理。
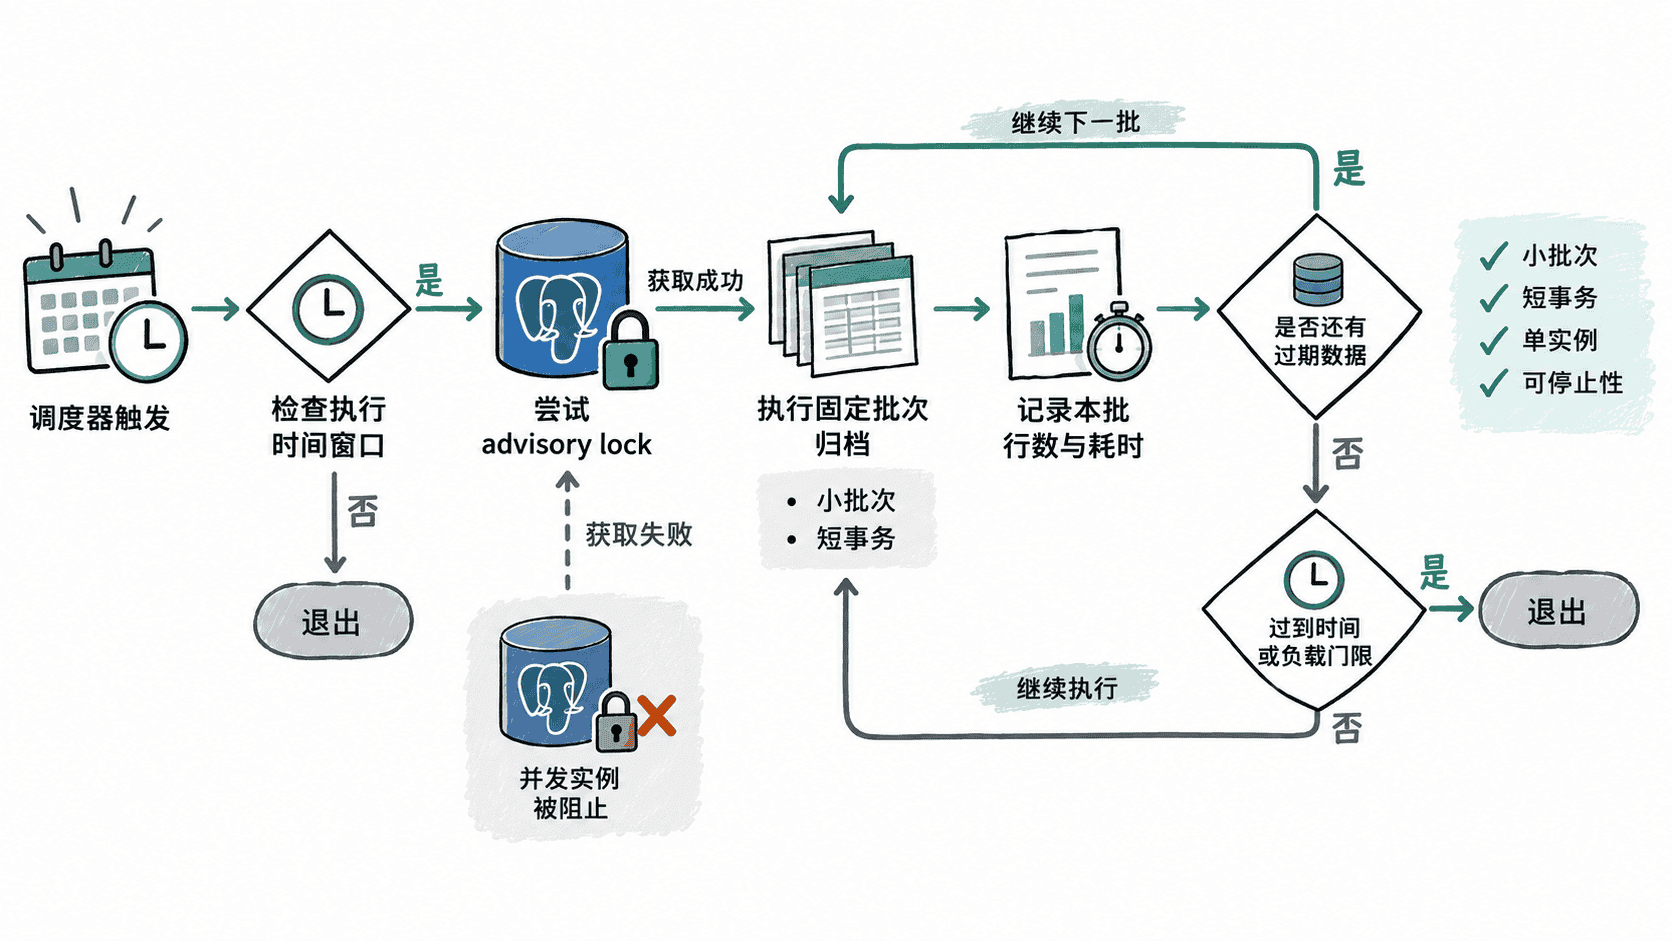
用调度器控制运行频率
调度周期不应简单设成“尽可能频繁”。应先估算每天新增的可归档数据量,再选择能够在维护窗口内逐步追平积压的频率。例如每 10 分钟执行一批、单批最多 5000 行,理论上每小时最多处理约 30000 行;实际吞吐还会受到磁盘延迟、WAL、复制延迟、索引维护以及 SKIP LOCKED 跳过行数的影响。
使用系统 cron 时,可以在每天凌晨窗口内每 10 分钟触发一次脚本。
*/10 1-5 * * * /opt/jobs/archive-events.sh >> /var/log/archive-events.log 2>&1这条配置会在每天 01:00 到 05:59 每 10 分钟启动一次脚本。advisory lock 保证前一实例尚未结束时,新实例不会并发执行。验证时应检查日志中的 cutoff、实际归档行数、批次耗时以及并发锁拒绝情况。
用结果和负载决定是否继续
归档任务至少应记录本批移动行数、执行耗时、失败原因和剩余过期数据量。连续多批都达到上限,通常说明仍有明显积压;返回行数逐渐下降到 0,则说明当前固定 cutoff 之前可处理的数据已经基本追平。被并发事务锁住而跳过的行,后续调度仍会再次成为候选。
生产环境还应设置外部停止条件。例如数据库 CPU、磁盘延迟、复制延迟或剩余磁盘空间越过门槛时,应暂停后续批次并告警。调度器决定“什么时候尝试”,本轮固定 cutoff 决定“处理到哪里”,批次 SQL 控制“每次最多处理多少”,监控门禁决定“现在是否适合继续”。
稳定的周期归档应具备短事务、每轮冻结一次 cutoff、明确执行窗口和单实例并发限制。先让任务边界稳定且可控,再根据监控数据调整批次大小或调度频率,比一次性追求最大吞吐更适合长期生命周期治理。