
单片机与物联网 / 系统课时
检查 DMA 资源冲突与共享数据竞争
检查 DMA 资源冲突与共享数据竞争
STM32F407 同时启用 ADC 采集、USART 接收和 SPI 发送时,单独测试正常,并行运行却可能丢样或卡住。排查要分开处理两件事:多个外设是否抢占同一个 DMA Stream,以及 CPU 是否在 DMA 改写数据时读取缓冲区。本篇给出可核验的分配表和半缓冲交接代码。
学习目标
- 根据 STM32F407 的 DMA 请求映射,识别同一 Stream 的分配冲突。
- 用半满和全满回调划分 DMA 与应用层的缓冲区所有权。
- 通过中断、计数器和时间预算判断数据竞争或消费滞后。
先排查 Stream 占用冲突
STM32F407 的 DMA1、DMA2 各有 8 个 Stream。Channel 是某个 Stream 的请求选择值,并非额外的并行传输通道。同一 DMA 控制器的同一 Stream 不能同时服务两路外设,即便 Channel 不同;不同 Stream 可以工作,但仍要竞争总线带宽。
以 RM0090 的 DMA 请求映射表 为依据,先整理正在使用的请求:
| 外设请求 | STM32F407 合法映射 | 本例选择 |
|---|---|---|
| ADC1 | DMA2 Stream0/4,Channel0 | DMA2 Stream0,Channel0 |
| USART2_RX | DMA1 Stream5,Channel4 | DMA1 Stream5,Channel4 |
| SPI3_TX | DMA1 Stream5/7,Channel0 | DMA1 Stream7,Channel0 |
错误配置是让 SPI3_TX 占用 DMA1 Stream5 Channel0,同时让 USART2_RX 占用 DMA1 Stream5 Channel4。两个 Channel 数值不同,仍然争用 DMA1 Stream5。把 SPI3 发送改到 DMA1 Stream7 Channel0 即可消除这项硬冲突;提高 DMA Priority 无法解决。
在 STM32CubeMX 的各外设 DMA Settings 中检查 Stream、Channel、Direction 和 Mode。建议 ADC1 使用 Circular、外设和内存宽度均为 Half Word;USART2_RX 连续接收使用 Circular;SPI3_TX 按次发送使用 Normal。确认对应 DMA Stream 中断在 NVIC 中启用,并检查生成的 stm32f4xx_hal_msp.c 是否与表格一致。
给 DMA 和 CPU 明确缓冲区所有权
假设 TIM2 每秒触发 ADC1 转换 1000 次,DMA 循环接收 64 个 uint16_t 采样值。前 32 点在约 32 ms 内填满,产生 Half Transfer(HT);后 32 点再用约 32 ms 填满,产生 Transfer Complete(TC)。HT 时 DMA 开始写后半区,CPU 才能复制前半区;TC 时相反。
应用不直接遍历正在循环写入的 adc_dma_buf。回调将已完成的 32 点复制到独立的 app_buf,设置就绪标志;主循环读取 app_buf 时暂时屏蔽中断,复制到局部数组后立即释放。若上一个快照尚未消费,新块记为丢弃,不覆盖旧快照。
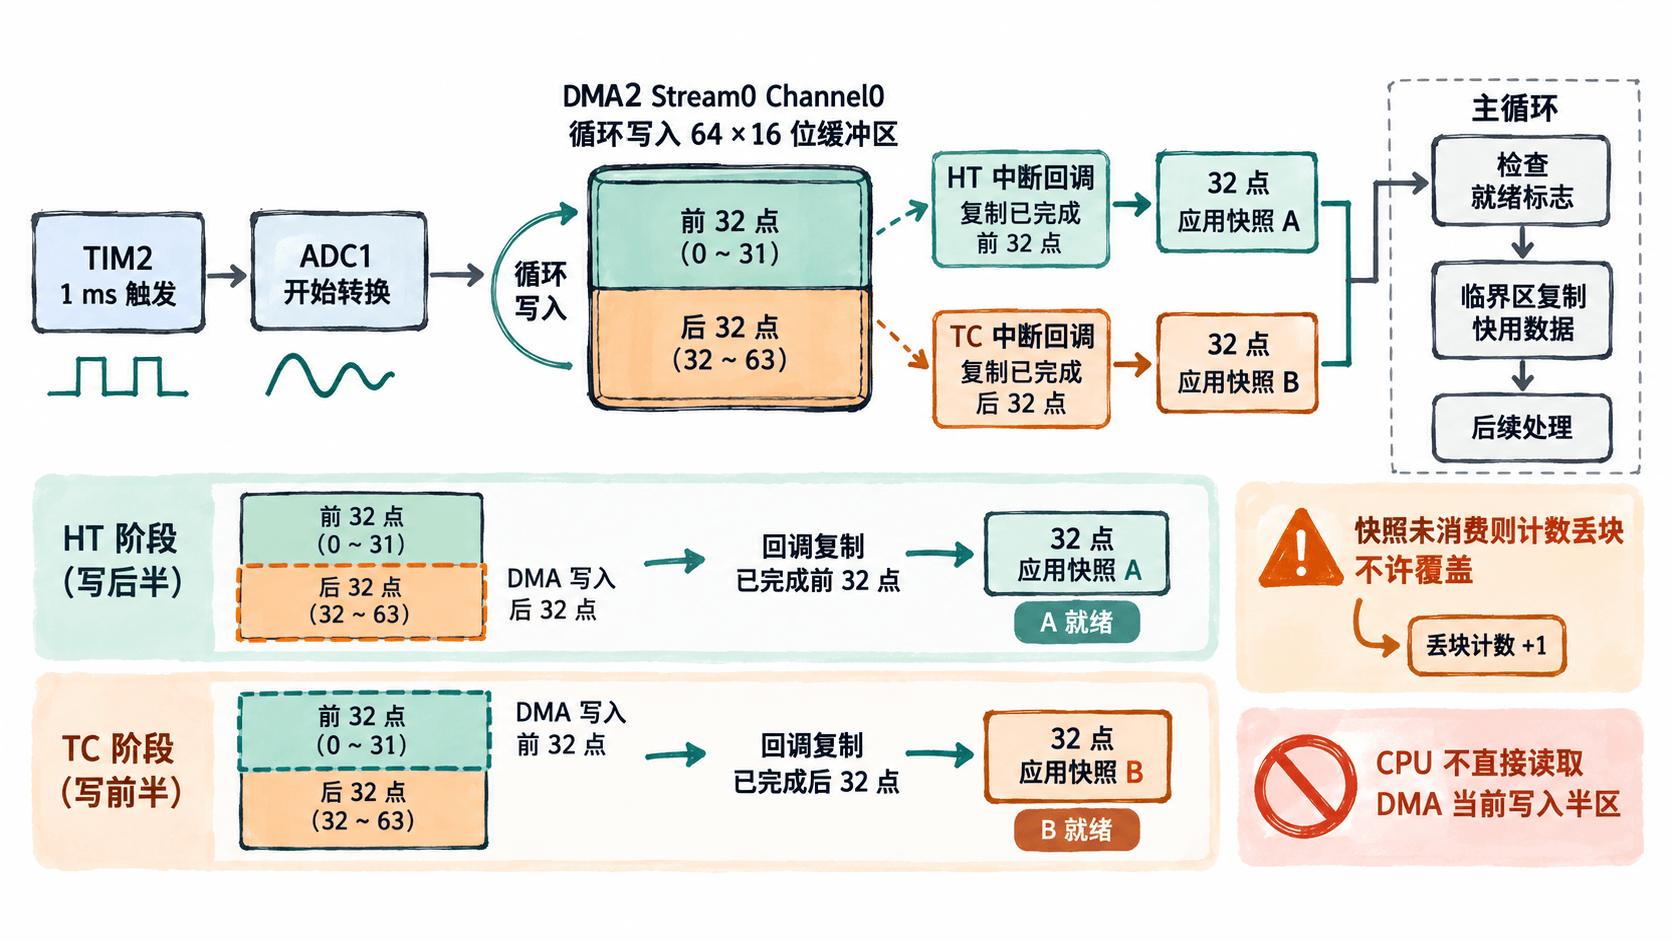
用 HAL 回调完成半缓冲交接
片段示例:适用于 STM32CubeF4 HAL 工程,依赖 CubeMX 生成的 hadc1、htim2、DMA2 Stream0 IRQ 和 Error_Handler()。设置 ADC1 为 TIM2 TRGO 上升沿触发,关闭 ADC 连续转换,开启 DMA 连续请求;DMA 使用 Circular、外设与内存半字宽度。若 TIM2 输入时钟为 84 MHz,设 Prescaler=83、Counter Period=999、Trigger Output=Update Event,产生 1 kHz 触发。把代码放在 main.c 用户代码区域,并在 MX_DMA_Init()、MX_ADC1_Init()、MX_TIM2_Init() 等初始化完成后调用一次 Sampling_Start(),在 while (1) 中反复调用 Sampling_Poll()。
#include "main.h"
#include <string.h>

#define ADC_DMA_N 64U
#define ADC_HALF_N (ADC_DMA_N / 2U)

extern ADC_HandleTypeDef hadc1;
extern TIM_HandleTypeDef htim2;

static uint16_t adc_dma_buf[ADC_DMA_N];
static uint16_t app_buf[ADC_HALF_N];
static volatile uint8_t app_ready = 0U;
static volatile uint32_t dropped_blocks = 0U;
static volatile uint32_t processed_blocks = 0U;
static volatile uint32_t last_sum = 0U;

static void PublishHalf(uint32_t start)
{
    // 应用快照尚未取走时,宁可计数丢块也不覆盖。
    if (app_ready != 0U) {
        dropped_blocks++;
        return;
    }
    memcpy(app_buf, &adc_dma_buf[start], sizeof(app_buf));
    app_ready = 1U;
}

void HAL_ADC_ConvHalfCpltCallback(ADC_HandleTypeDef *hadc)
{
    if (hadc->Instance == ADC1) PublishHalf(0U);
}

void HAL_ADC_ConvCpltCallback(ADC_HandleTypeDef *hadc)
{
    if (hadc->Instance == ADC1) PublishHalf(ADC_HALF_N);
}

void Sampling_Start(void)
{
    // 先启动 ADC DMA,再允许 TIM2 产生周期触发。
    if (HAL_ADC_Start_DMA(&hadc1, (uint32_t *)adc_dma_buf,
                          ADC_DMA_N) != HAL_OK) Error_Handler();
    if (HAL_TIM_Base_Start(&htim2) != HAL_OK) Error_Handler();
}

void Sampling_Poll(void)
{
    uint16_t local[ADC_HALF_N];
    uint8_t got = 0U;
    uint32_t old_mask = __get_PRIMASK();

    // 只有 ISR 修改 app_buf;短临界区保护整个快照。
    __disable_irq();
    if (app_ready != 0U) {
        memcpy(local, app_buf, sizeof(local));
        app_ready = 0U;
        got = 1U;
    }
    __set_PRIMASK(old_mask);

    if (got != 0U) {
        uint32_t sum = 0U;
        for (uint32_t i = 0; i < ADC_HALF_N; ++i) sum += local[i];
        last_sum = sum;
        processed_blocks++;
    }
}
预期结果:TIM2 为 1 kHz 时,processed_blocks 每秒约增加 31~32,主循环足够快时 dropped_blocks 维持 0;last_sum 随 ADC 引脚电压变化,不存在固定数值。这里以 32 点求和模拟应用处理;实际发送前应将数据复制到有独立生命周期的发送队列。
验证并定位异常
- 在调试器中分别查看
hadc1.DMA_Handle->Instance、huart2.hdmarx->Instance和hspi3.hdmatx->Instance(后两者需已初始化并关联 DMA),预期依次是DMA2_Stream0、DMA1_Stream5和DMA1_Stream7。再查看三者Init.Channel是否对应 0、4、0。 - 检查
adc_dma_buf的地址位于普通 SRAM,确认DMA2_Stream0_IRQHandler调用了HAL_DMA_IRQHandler();分别在 HT、TC 回调下断点,确认每 32 次转换交替触发。 - 让主循环持续运行约 10 秒,1 kHz 采样时预期处理约 312~313 块,
dropped_blocks为 0。再人为给主循环增加超过 32 ms 的阻塞,观察丢块计数是否上升;恢复非阻塞处理后应停止持续增长。 - 若仅在 SPI 和 USART 同时工作时异常,先核对 Stream 是否重复,其次检查 DMA Transfer Error、ADC Overrun 标志与中断延迟;没有重复分配也可能因高优先级中断过长、总线竞争或处理速度不足而丢数据。
本例每半区只有 64 字节,短时间屏蔽中断用于复制应用快照通常可接受;采样频率升高或数据块变大时,应改为多槽队列或交换缓冲区所有权,避免长临界区。不要把栈上的 local 直接交给异步 UART/SPI DMA 后立即返回:发送 DMA 尚未完成时,栈内存可能已被复用,必须让发送缓冲一直有效到对应的发送完成回调。