
单片机与物联网 / 系统课时
用 DMA 循环缓存连续采样数据
用 DMA 循环缓存连续采样数据
把 ADC 结果交给循环 DMA 后,CPU 不必逐次读取转换寄存器。这里以 STM32F407 的单通道 10 kS/s 采样为例,建立 256 点环形缓存,利用半传输和传输完成事件交替处理两个 128 点数据块,并检查处理超时是否造成覆盖。
学习目标
- 配置定时器触发 ADC、DMA 循环传输和半字对齐。
- 区分半传输与传输完成时可安全处理的缓冲区。
- 通过计数器和输入电压验证更新顺序,识别处理滞后。
配置固定采样率与循环传输
示例适用于 STM32F407、STM32CubeF4 HAL 和 STM32CubeIDE 生成的工程,假设系统时钟 168 MHz、APB1 分频为 4,此时 TIM3 时钟为 84 MHz。将 PA1 配为模拟输入 ADC1_IN1,测试时接入共地、位于 0~3.3 V 范围内的稳定电压。
在 .ioc 的 Pinout & Configuration 中完成以下设置:
| 外设 | 关键配置 |
|---|---|
| ADC1 | 12 位、ADC 时钟预分频 PCLK2/4、右对齐、单通道 Rank 1、采样时间 84 cycles、扫描关闭、连续转换关闭 |
| ADC1 触发 | TIM3 TRGO、上升沿;DMA Continuous Requests = Enabled |
| TIM3 | Internal Clock、Prescaler 83、Counter Period 99、Trigger Output (TRGO) = Update Event |
| ADC1 DMA | DMA2 Stream0 / Channel0、Peripheral to Memory、Circular、内存地址递增、两端 Half Word(16 位) |
| 中断 | 在 DMA 的 NVIC 设置中使能 DMA2 Stream0 中断,保留 HAL 生成的 IRQ 处理入口 |
TIM3 更新频率为 84 MHz ÷ (83 + 1) ÷ (99 + 1) = 10,000 Hz。每次触发产生一个 12 位转换值,DMA 写入一个 uint16_t;缓存 256 点占 512 字节。先核对生成代码中 MX_DMA_Init() 在 MX_ADC1_Init() 之前执行,DMA 句柄已关联 ADC,且 DMA2_Stream0_IRQHandler() 调用 HAL_DMA_IRQHandler()。
识别半传输与完成事件
DMA 从索引 0 顺序写到 255,采用 Circular 模式后自动回到索引 0。写完 0~127 时触发 HT(Half Transfer),此时 DMA 转向后半区,CPU 可以处理前半区;写完 128~255 时触发 TC(Transfer Complete),DMA 回到前半区,CPU 可以处理后半区。
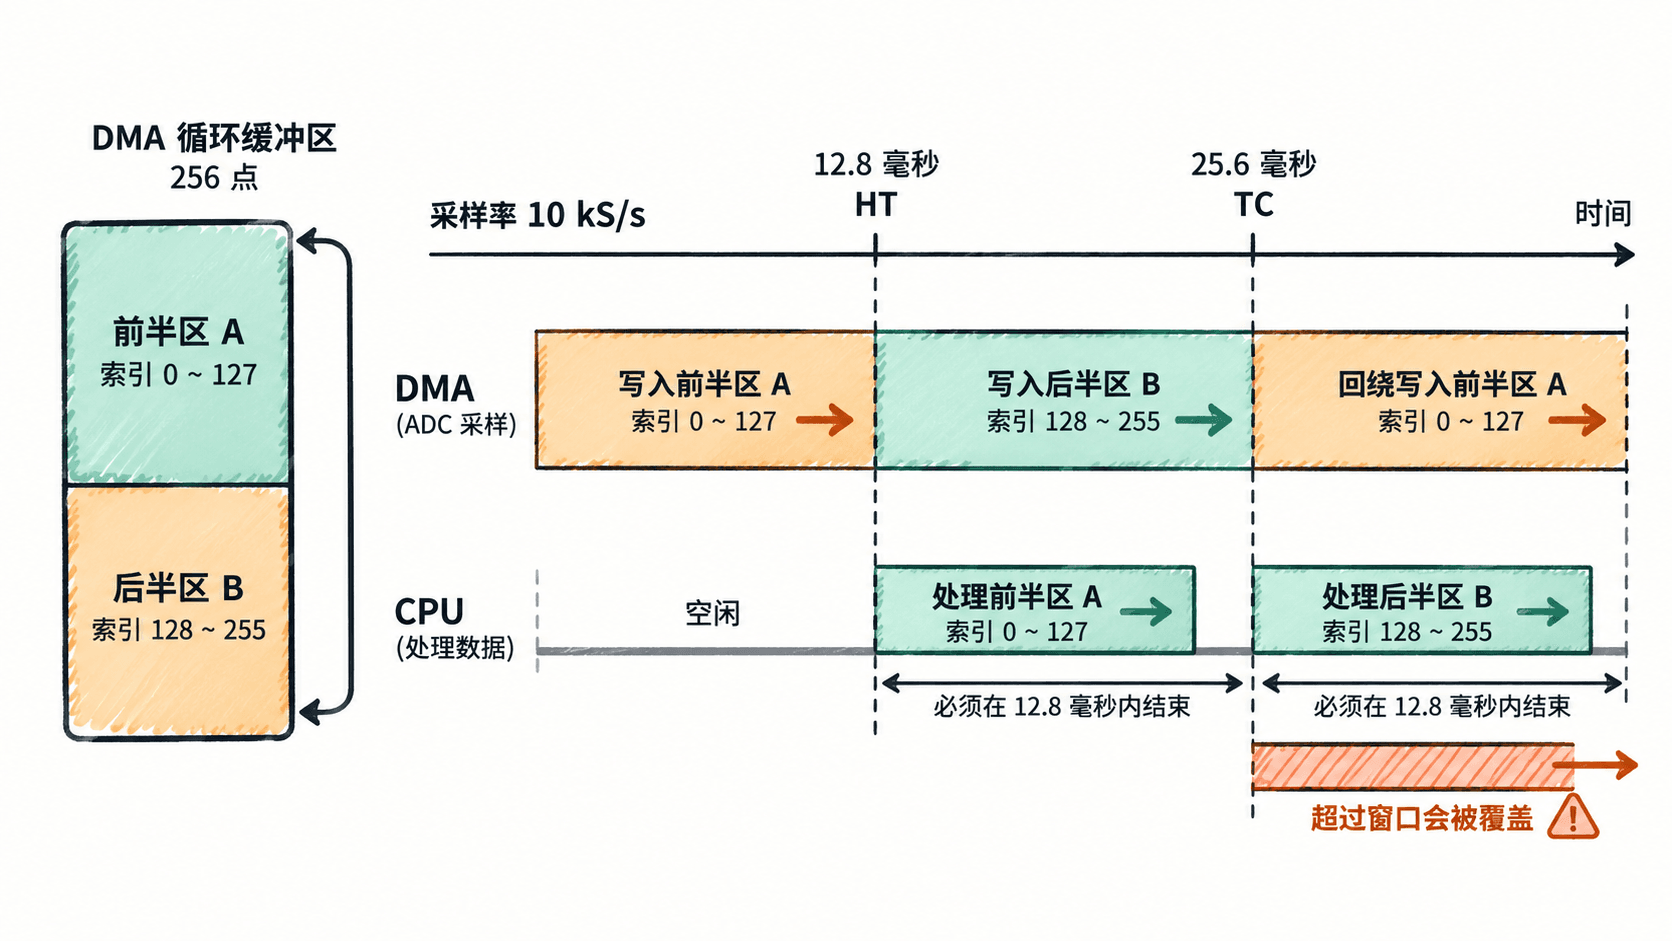
每个半区含 128 点,填满耗时 128 ÷ 10,000 = 12.8 ms。这也是主循环处理一次数据块的大致时间预算;DMA 不会因为 CPU 尚未读完而暂停。这里是单个循环缓存分两半,不需要启用 DMA 的独立双缓冲模式。
在回调中登记事件,由主循环处理
**片段示例:**以下代码放在 CubeIDE 生成的 main.c 的 USER CODE BEGIN 0 区域,依赖该工程已有的 hadc1、htim3 和 Error_Handler()。回调只记录完成次数;主循环只计算非写入半区的平均 ADC 码值。开始前和读取后都检查 DMA 剩余计数,避免把已被回绕覆盖的数据作为有效结果。
#define HALF_SAMPLES 128U

static volatile uint16_t adc_ring[2U * HALF_SAMPLES];
static volatile uint32_t ready_seq[2];
static uint32_t handled_seq[2];
static volatile uint16_t block_mean[2];
static volatile uint32_t processed_blocks;
static volatile uint32_t missed_blocks;
static volatile uint32_t adc_error;

void HAL_ADC_ConvHalfCpltCallback(ADC_HandleTypeDef *hadc)
{
    if (hadc->Instance == ADC1) {
        ready_seq[0]++;  // 前128点已经写完
    }
}

void HAL_ADC_ConvCpltCallback(ADC_HandleTypeDef *hadc)
{
    if (hadc->Instance == ADC1) {
        ready_seq[1]++;  // 后128点已经写完
    }
}

void HAL_ADC_ErrorCallback(ADC_HandleTypeDef *hadc)
{
    if (hadc->Instance == ADC1) {
        adc_error = hadc->ErrorCode;
    }
}

static uint8_t DmaWritingHalf(uint32_t half)
{
    uint32_t left = __HAL_DMA_GET_COUNTER(hadc1.DMA_Handle);
    return (half == 0U) ? (left > HALF_SAMPLES)
                        : (left <= HALF_SAMPLES);
}

void AdcStream_Start(void)
{
    // 先启用ADC与DMA,后开放TIM3触发
    if (HAL_ADC_Start_DMA(&hadc1, (uint32_t *)(void *)adc_ring,
                          2U * HALF_SAMPLES) != HAL_OK ||
        HAL_TIM_Base_Start(&htim3) != HAL_OK) {
        Error_Handler();
    }
}

void AdcStream_Task(void)
{
    for (uint32_t half = 0; half < 2U; half++) {
        uint32_t seq = ready_seq[half];
        uint32_t previous = handled_seq[half];
        if (seq == previous) {
            continue;
        }

        handled_seq[half] = seq;
        if (seq - previous > 1U) {
            missed_blocks += seq - previous - 1U;
        }
        if (DmaWritingHalf(half)) {
            missed_blocks++;
            continue;  // 处理太晚,DMA已经回到该半区
        }

        uint32_t sum = 0U;
        for (uint32_t i = 0; i < HALF_SAMPLES; i++) {
            sum += adc_ring[half * HALF_SAMPLES + i];
        }

        // 计算期间若发生回绕,丢弃这块结果
        if (DmaWritingHalf(half) || ready_seq[half] != seq) {
            missed_blocks++;
            continue;
        }
        block_mean[half] = (uint16_t)(sum / HALF_SAMPLES);
        processed_blocks++;
    }
}预期结果(完成以下接入并运行后):ready_seq[0] 和 ready_seq[1] 轮流递增,processed_blocks 持续增加;本片段不生成串口日志。
在 main() 完成所有 MX_*_Init() 调用后,于 USER CODE BEGIN 2 执行一次 AdcStream_Start();在 while (1) 的 USER CODE BEGIN 3 内持续调用 AdcStream_Task()。HAL_ADC_Start_DMA() 的长度 256 指 DMA 传输次数,不是字节数;DMA 两端必须配置为 Half Word。不要在 HT/TC 回调中打印串口、调用 HAL_Delay() 或执行整块滤波。
用固定电压验证顺序与漏块
- 给 PA1 输入约 1.65 V,模拟地与开发板共地。假设实测
VDDA ≈ 3.30 V,12 位 ADC 理论码值约为 2048;读数允许随参考电压和噪声略微波动。 - 在 CubeIDE Debug → Live Expressions 中观察
ready_seq[0]、ready_seq[1]、block_mean[0]、block_mean[1]、processed_blocks、missed_blocks、adc_error。 - 保持程序运行约 1 秒。预期结果:两个
ready_seq轮流增长,各增加约 78;processed_blocks增加约 156,两个block_mean均接近 2048;正常轻负载时missed_blocks = 0、adc_error = 0。 - 仅为故障注入,在主循环增加
HAL_Delay(30)再测。预期结果:ready_seq仍增长,missed_blocks开始增加,说明事件到达不等于数据仍可读。恢复原主循环后应停止新增漏块。
若缓存值变化但事件计数始终不增,检查 DMA2_Stream0_IRQn 是否启用,以及生成的 IRQ 函数是否调用 HAL_DMA_IRQHandler(&hdma_adc1);若事件只出现一次,检查 DMA Circular 和 ADC DMA Continuous Requests。若出现漏块,先缩短主循环计算或降低采样率,再考虑加大每个半区的容量。
只消费刚完成且尚未被 DMA 重新写入的半区,才能把连续采样转换成可信的数据块;如果处理时间持续超过 12.8 ms,应降低处理负载或调整缓存、采样率。