
单片机与物联网 / 系统课时
用 DMA 传输连续采样缓存
用 DMA 传输连续采样缓存
SPI 连续读取传感器时,阻塞式收发会让 CPU 等待每个字节移位。本篇用 STM32F407 的 SPI2 与 DMA1 读取 LIS3DH 六字节三轴缓存,完成片选管理、忙状态保护和缓冲区交接,并用周期计数比较两种方式的调用开销。
学习目标
- 为 SPI2 配置全双工 DMA 并读取一帧连续寄存器数据。
- 在回调与主循环间正确管理片选、忙状态和接收缓冲。
- 用调试器验证采样结果并比较 CPU 阻塞与 DMA 启动开销。
核对 SPI 和 DMA 资源
以 STM32F407、外接四线 SPI 的 LIS3DH 为例,供电采用 3.3 V,MCU 与传感器必须共地。SPI2 引脚 PB13(SCK)、PB14(MISO)、PB15(MOSI)分别连接 SPC、SDO、SDI;PB12 作为软件控制的低有效 CS。不要把 LIS3DH 的 SDO 接到 MOSI。
SPI 配为主机、全双工、8 位、MSB 优先、CPOL=1、CPHA=1(模式 3)、软件 NSS。示例保留复位后 HSI 16 MHz 时钟,SPI2 预分频 16,SCK 约 1 MHz,低于 LIS3DH 的 10 MHz 上限。使用 STM32CubeF4 HAL 工程,启用 GPIO、SPI、DMA 驱动。
| DMA 方向 | STM32F407 资源 | 数据流 |
|---|---|---|
| SPI2 接收 | DMA1 Stream3 / Channel 0 | SPI2 DR → 内存 RX |
| SPI2 发送 | DMA1 Stream4 / Channel 0 | 内存 TX → SPI2 DR |
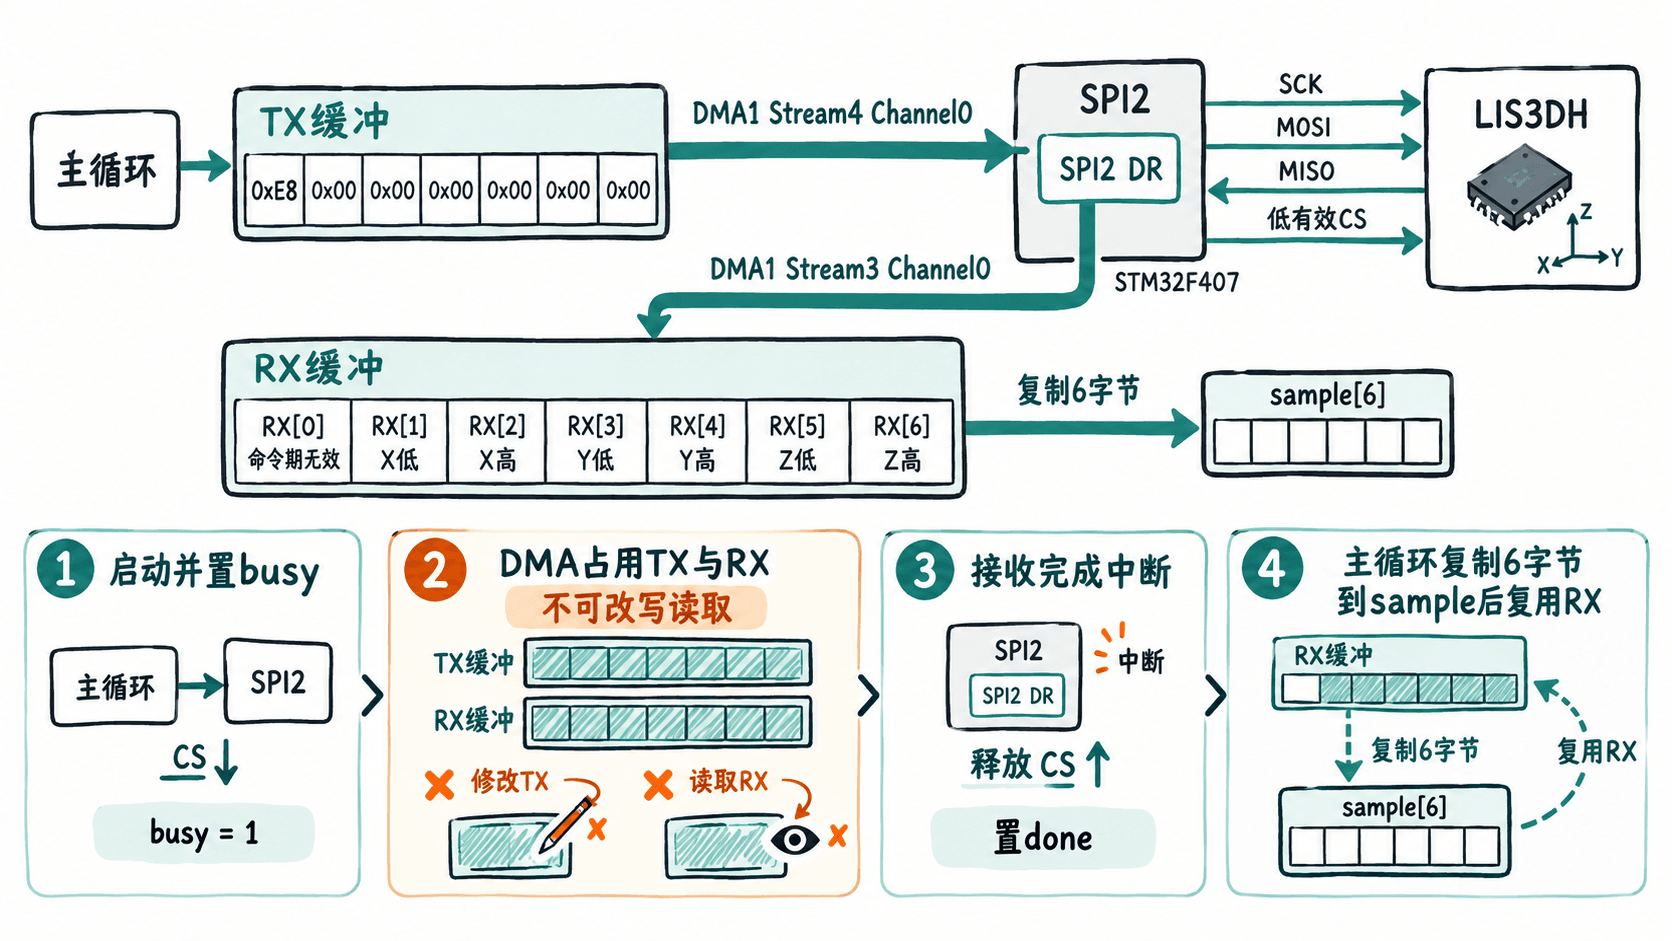
SPI 主机读数据仍要发送时钟,因此应使用 HAL_SPI_TransmitReceive_DMA 同时配置 TX 和 RX,而不是只配置接收流。这里选择 DMA Normal 模式;每 20 ms 重新发起一次七字节事务,而非让 CS 一直保持低电平。
理清双向传输与缓存交接
LIS3DH 的 X 轴低字节寄存器地址为 0x28。一次连续读的命令字节是 0xE8(0x28 | 0x80 读标志 | 0x40 地址递增标志),之后发送六个填充字节产生时钟。rx[0] 对应命令阶段,应丢弃;rx[1] 至 rx[6] 依次为 X、Y、Z 的低/高字节。
这组命令位定义可核对 LIS3DH 数据手册。
DMA 启动后,TX 数组不能改写,RX 数组不能提前读取。接收完成中断进入 HAL 回调后,才抬高 CS 并标记完成;主循环先复制完整六字节,再允许下一次 DMA 重用 RX。这样避免新旧两帧混在同一缓存。
实现非阻塞采样程序
下面是面向 STM32CubeF4 HAL 的完整 main.c 示例。它自行初始化 GPIO、SPI2、DMA 和中断,适用于带启动文件及 HAL 驱动的 STM32F407 工程;不要再让其他源文件重复定义三个同名 IRQ 函数。传感器上电后先读 WHO_AM_I=0x33,再把 CTRL_REG1 写为 0x57,以 100 Hz 输出开启三轴数据。调试时在 fatal 处设断点定位初始化或接线失败。
#include "stm32f4xx_hal.h"

SPI_HandleTypeDef hspi2;
DMA_HandleTypeDef hdma_rx, hdma_tx;

static uint8_t tx[7] = {0xE8, 0, 0, 0, 0, 0, 0};
static uint8_t rx[7];
volatile uint8_t sample[6];
volatile uint8_t who_am_i = 0;
volatile uint8_t dma_busy = 0, dma_done = 0;
volatile uint32_t frames = 0, errors = 0, last_error = 0;
volatile uint32_t poll_cycles = 0, dma_launch_cycles = 0;

static void fatal(void) { while (1) {} }

static void cs(GPIO_PinState state) {
    HAL_GPIO_WritePin(GPIOB, GPIO_PIN_12, state);
}

static void init_dma(DMA_HandleTypeDef *h,
                     DMA_Stream_TypeDef *stream, uint32_t direction) {
    h->Instance = stream;
    h->Init.Channel = DMA_CHANNEL_0;
    h->Init.Direction = direction;
    h->Init.PeriphInc = DMA_PINC_DISABLE;
    h->Init.MemInc = DMA_MINC_ENABLE;
    h->Init.PeriphDataAlignment = DMA_PDATAALIGN_BYTE;
    h->Init.MemDataAlignment = DMA_MDATAALIGN_BYTE;
    h->Init.Mode = DMA_NORMAL;
    h->Init.Priority = DMA_PRIORITY_HIGH;
    h->Init.FIFOMode = DMA_FIFOMODE_DISABLE;
    if (HAL_DMA_Init(h) != HAL_OK) fatal();
}

static void init_spi2(void) {
    __HAL_RCC_GPIOB_CLK_ENABLE();
    __HAL_RCC_DMA1_CLK_ENABLE();
    __HAL_RCC_SPI2_CLK_ENABLE();

    // PB12 为软件片选;PB13/14/15 分别是 SCK/MISO/MOSI。
    cs(GPIO_PIN_SET);
    GPIO_InitTypeDef gpio = {0};
    gpio.Pin = GPIO_PIN_12;
    gpio.Mode = GPIO_MODE_OUTPUT_PP;
    gpio.Pull = GPIO_NOPULL;
    gpio.Speed = GPIO_SPEED_FREQ_HIGH;
    HAL_GPIO_Init(GPIOB, &gpio);

    gpio.Pin = GPIO_PIN_13 | GPIO_PIN_14 | GPIO_PIN_15;
    gpio.Mode = GPIO_MODE_AF_PP;
    gpio.Alternate = GPIO_AF5_SPI2;
    HAL_GPIO_Init(GPIOB, &gpio);

    hspi2.Instance = SPI2;
    hspi2.Init.Mode = SPI_MODE_MASTER;
    hspi2.Init.Direction = SPI_DIRECTION_2LINES;
    hspi2.Init.DataSize = SPI_DATASIZE_8BIT;
    hspi2.Init.CLKPolarity = SPI_POLARITY_HIGH;
    hspi2.Init.CLKPhase = SPI_PHASE_2EDGE;
    hspi2.Init.NSS = SPI_NSS_SOFT;
    hspi2.Init.BaudRatePrescaler = SPI_BAUDRATEPRESCALER_16;
    hspi2.Init.FirstBit = SPI_FIRSTBIT_MSB;
    hspi2.Init.TIMode = SPI_TIMODE_DISABLE;
    hspi2.Init.CRCCalculation = SPI_CRCCALCULATION_DISABLE;
    hspi2.Init.CRCPolynomial = 7;
    if (HAL_SPI_Init(&hspi2) != HAL_OK) fatal();

    // SPI2 在 STM32F407 上使用 DMA1 Stream3 RX、Stream4 TX。
    init_dma(&hdma_rx, DMA1_Stream3, DMA_PERIPH_TO_MEMORY);
    init_dma(&hdma_tx, DMA1_Stream4, DMA_MEMORY_TO_PERIPH);
    __HAL_LINKDMA(&hspi2, hdmarx, hdma_rx);
    __HAL_LINKDMA(&hspi2, hdmatx, hdma_tx);

    HAL_NVIC_SetPriority(DMA1_Stream3_IRQn, 5, 0);
    HAL_NVIC_EnableIRQ(DMA1_Stream3_IRQn);
    HAL_NVIC_SetPriority(DMA1_Stream4_IRQn, 5, 0);
    HAL_NVIC_EnableIRQ(DMA1_Stream4_IRQn);
    HAL_NVIC_SetPriority(SPI2_IRQn, 5, 0);
    HAL_NVIC_EnableIRQ(SPI2_IRQn);
}

void DMA1_Stream3_IRQHandler(void) { HAL_DMA_IRQHandler(&hdma_rx); }
void DMA1_Stream4_IRQHandler(void) { HAL_DMA_IRQHandler(&hdma_tx); }
void SPI2_IRQHandler(void) { HAL_SPI_IRQHandler(&hspi2); }

void HAL_SPI_TxRxCpltCallback(SPI_HandleTypeDef *h) {
    if (h->Instance != SPI2) return;
    cs(GPIO_PIN_SET);              // 只有整帧完成才释放片选
    dma_done = 1;
    dma_busy = 0;
}

void HAL_SPI_ErrorCallback(SPI_HandleTypeDef *h) {
    if (h->Instance != SPI2) return;
    last_error = HAL_SPI_GetError(h);
    cs(GPIO_PIN_SET);
    ++errors;
    dma_busy = 0;
}

int main(void) {
    HAL_Init();                    // 采用复位默认 HSI 16 MHz
    init_spi2();

    uint8_t id_tx[2] = {0x8F, 0}, id_rx[2] = {0};
    cs(GPIO_PIN_RESET);
    HAL_StatusTypeDef st = HAL_SPI_TransmitReceive(
        &hspi2, id_tx, id_rx, 2, 100);
    cs(GPIO_PIN_SET);
    if (st != HAL_OK || id_rx[1] != 0x33) fatal();
    who_am_i = id_rx[1];

    uint8_t cfg[2] = {0x20, 0x57}; // 100 Hz,开启 XYZ 轴
    cs(GPIO_PIN_RESET);
    st = HAL_SPI_Transmit(&hspi2, cfg, 2, 100);
    cs(GPIO_PIN_SET);
    if (st != HAL_OK) fatal();

    // DWT 计数用于对比阻塞调用与 DMA 启动的 CPU 周期。
    CoreDebug->DEMCR |= CoreDebug_DEMCR_TRCENA_Msk;
    DWT->CYCCNT = 0;
    DWT->CTRL |= DWT_CTRL_CYCCNTENA_Msk;

    cs(GPIO_PIN_RESET);
    uint32_t t0 = DWT->CYCCNT;
    st = HAL_SPI_TransmitReceive(&hspi2, tx, rx, 7, 100);
    poll_cycles = DWT->CYCCNT - t0;
    cs(GPIO_PIN_SET);
    if (st != HAL_OK) fatal();

    uint32_t last_start = HAL_GetTick();
    for (;;) {
        // 先消费完成帧,再允许复用 rx,避免 DMA 改写正在读取的数据。
        if (dma_done) {
            for (unsigned i = 0; i < 6; ++i) sample[i] = rx[i + 1];
            dma_done = 0;
            ++frames;
        }

        uint32_t now = HAL_GetTick();
        if (dma_busy && (uint32_t)(now - last_start) > 5U) {
            (void)HAL_SPI_Abort(&hspi2); // 超过合理总线时长时复位事务
            cs(GPIO_PIN_SET);
            dma_busy = 0;
            ++errors;
        }
        if (!dma_busy && !dma_done &&
            HAL_SPI_GetState(&hspi2) == HAL_SPI_STATE_READY &&
            (uint32_t)(now - last_start) >= 20U) {
            last_start = now;
            dma_busy = 1;
            cs(GPIO_PIN_RESET);
            t0 = DWT->CYCCNT;
            st = HAL_SPI_TransmitReceive_DMA(&hspi2, tx, rx, 7);
            dma_launch_cycles = DWT->CYCCNT - t0;
            if (st != HAL_OK) {
                (void)HAL_SPI_Abort(&hspi2);
                cs(GPIO_PIN_SET);
                dma_busy = 0;
                last_error = HAL_SPI_GetError(&hspi2);
                ++errors;
            }
        }
        // 数据处理可以在这里扩展;空闲时等待下一次中断。
        __WFI();
    }
}
预期结果(使用 STM32CubeIDE 调试器 Watch 查看变量,不是串口打印;加速度原始字节与现场姿态有关):
who_am_i = 0x33
frames:每完成一帧增加 1,正常情况下约 50 帧/秒
errors = 0
dma_busy:传输期间为 1,完成后为 0
sample[0..5]:持续刷新为三个轴的低、高字节
验证时序与 CPU 开销
先用逻辑分析仪观察 PB12 与 PB13:每 20 ms 左右出现一次低有效 CS,片选低期间应有 56 个 SCK 周期。若 who_am_i 不为 0x33 而停在 fatal,优先核对电源、模式 3、PB14/PB15 是否接反,再检查片选。
CPU 开销对比使用 Cortex-M4 的 DWT 周期计数。代码里的 poll_cycles 测阻塞 HAL_SPI_TransmitReceive 从调用到返回的周期;dma_launch_cycles 测 DMA 启动函数返回所需周期。两者在相同 SCK 和七字节长度下测量,便于比较调用期间 CPU 被占用的时间。HSI 为 16 MHz 时,计数除以 16 即近似微秒数;例如 1200 周期等于 75 µs,这只是换算示例而非实测结果。
| 测量项目 | 轮询阻塞 | DMA |
|---|---|---|
| 7 字节、1 MHz 的理论总线时间 | 约 56 µs | 约 56 µs |
| 主调用返回条件 | 整帧发送接收完毕 | DMA 传输已启动 |
| CPU 在传输中 | 停留在等待路径 | 可执行其他任务 |
| 调试器读取 | poll_cycles |
dma_launch_cycles |
这两个计数不是完整的 CPU 总开销对比:DMA 还要计算 IRQ、HAL 收尾回调以及六字节复制的开销。可额外用 DWT 测中断路径,比较总 CPU 周期;小到七字节的事务未必值得 DMA,64~256 字节突发块通常更适合做效率对比。
定位忙状态与采样异常
遇到 HAL_BUSY 时不要通过循环反复调用 DMA API 来“重试”:先检查 dma_busy、HAL_SPI_GetState 和 DMA1 Stream3/4 的中断是否真正进入。始终保持每次事务只由主循环发起,完成回调负责释放 CS;示例用 5 ms 超时并调用 HAL_SPI_Abort 停止事务,确认状态恢复后再启动下一帧。
errors 增加时查看 last_error 与 DMA 配置;帧计数增长但数据异常时,确认 rx[0] 已跳过以及六个字节的次序。本例传感器输出 100 Hz、主机仅每 20 ms 读取一次,因此实际获取约 50 帧/秒,可能跳过中间样本。若需要不漏掉每次更新,应改用 LIS3DH 的数据就绪中断或 FIFO,并配合双缓冲或队列明确处理速度不足时的丢帧策略。STM32F407 没有需要额外维护的 D-cache;移植到带数据缓存的 MCU 时,还需处理 DMA 缓冲的缓存一致性。