
容器与云原生 / 系统课时
识别资源碎片与装箱问题
识别资源碎片与装箱问题
集群剩余 CPU、内存总量看起来足够,并不代表新的 Pod 一定能被调度。本课从节点级剩余容量出发识别资源碎片,区分整体容量不足与装箱失败,并据此选择扩容、调整资源请求或改善工作负载分布。
学习目标
- 根据 Pod 的资源请求判断单节点是否具备可调度容量
- 区分集群总资源不足与资源碎片导致的调度失败
- 根据碎片形态选择扩容、调整请求或重新装箱的治理方向
为什么总量够仍然调度失败
调度器放置 Pod 时,需要找到一台能够独立满足其资源请求和其他调度约束的节点。对于 CPU、内存等资源,判断依据主要是节点的可分配容量与已经承诺给现有 Pod 的 requests,而不是把整个集群的剩余资源汇总后统一分配。
假设三台候选节点分别还能承接 2 CPU、2 CPU、3 CPU,总剩余量为 7 CPU。此时一个请求 4 CPU 的 Pod 仍无法放入任何节点,因为最大的单节点剩余容量只有 3 CPU。这就是典型的资源碎片或装箱问题。
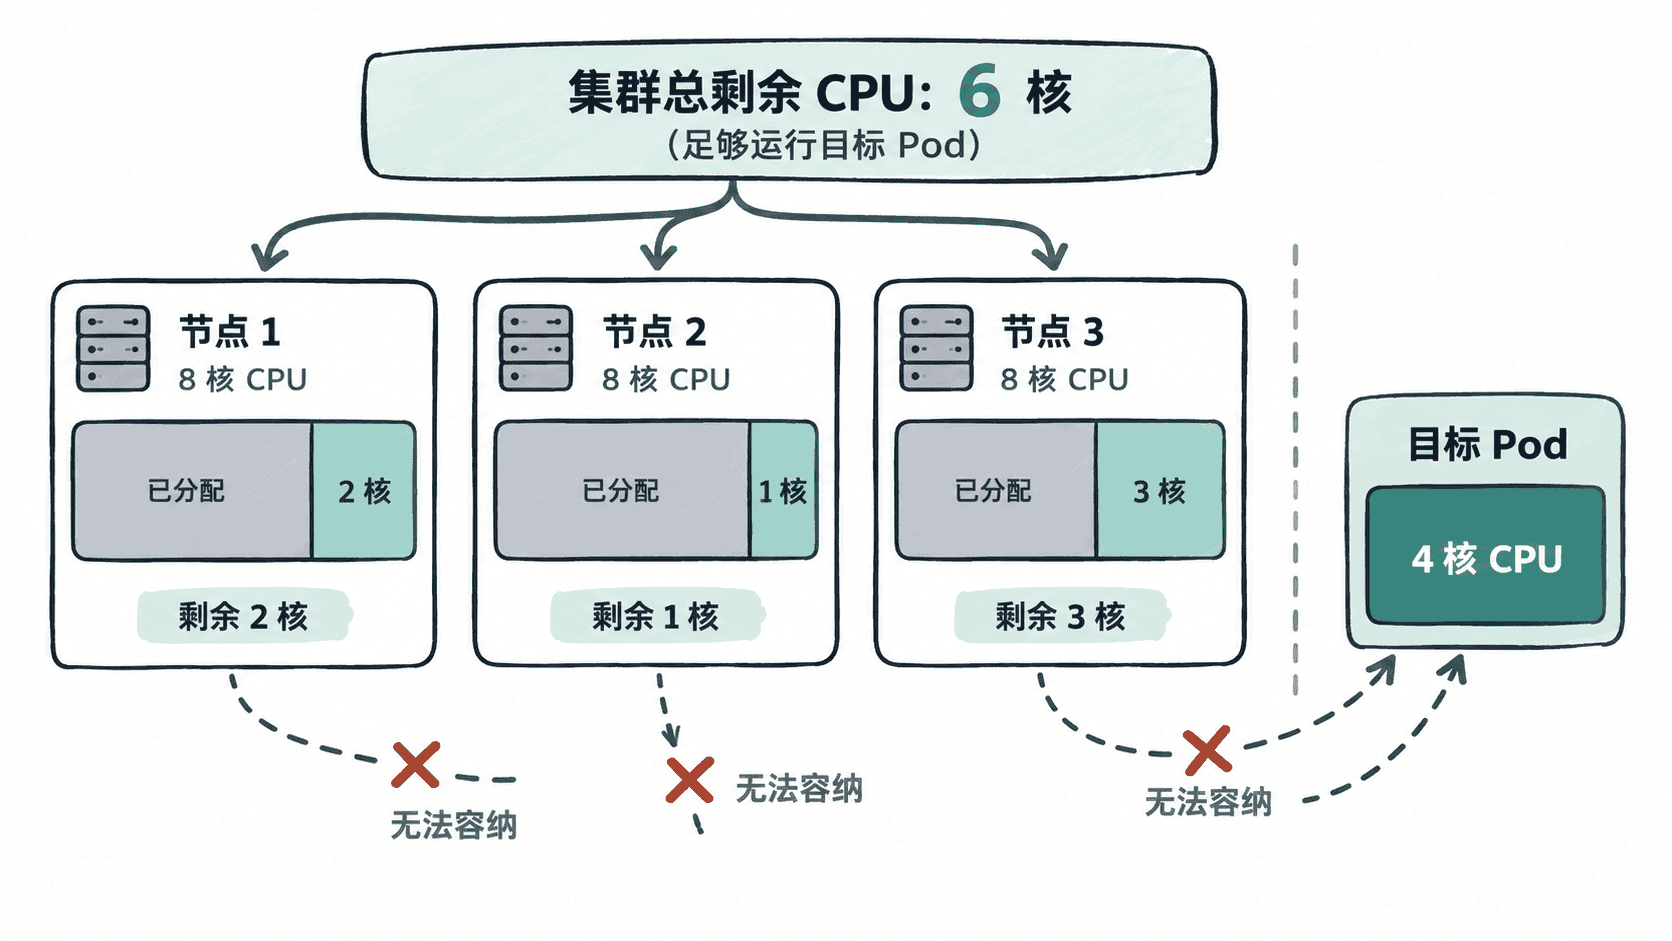
CPU 和内存还必须在同一台节点上同时满足。例如一台节点 CPU 足够但内存不足,另一台节点内存足够但 CPU 不足,也不能合并两台节点的剩余容量来承载一个 Pod。
从 Pending Pod 找到容量约束
先查看 Pending Pod 的调度事件,确认资源不足是否真的是主要过滤原因。
kubectl describe pod <POD> -n <NAMESPACE>预期输出中可能出现类似事件,节点数量和具体原因以实际集群为准:
Events:
  Type     Reason            Age    From               Message
  ----     ------            ----   ----               -------
  Warning  FailedScheduling  <TIME> default-scheduler  0/<VALUE> nodes are available: <VALUE> Insufficient cpu.
Insufficient cpu 表示候选节点按资源请求核算后,没有足够 CPU 接纳该 Pod;如果事件显示 Insufficient memory,则应改为检查内存。若同时出现污点、亲和性或节点选择器等原因,还需要先判断哪些节点真正属于候选节点集合。
接着查看具体节点的可分配资源和已承诺 requests:
kubectl describe node <NODE>预期结果会包含类似信息,实际单位和数值可能不同:
Allocatable:
  cpu:                <VALUE>
  memory:             <VALUE>

Allocated resources:
  Resource           Requests
  --------           --------
  cpu                <VALUE>m (<VALUE>%)
  memory             <VALUE>Mi (<VALUE>%)
分析时应重点比较 Allocatable 与 Requests。即使监控显示 CPU 实际利用率很低,只要已有 Pod 声明的 requests 已占用了大部分可调度容量,新 Pod 仍可能无法调度到该节点。
区分容量不足与资源碎片
判断时不要只看集群汇总值,而要依次回答两个问题:候选节点的剩余请求容量总和是否足够,以及是否至少存在一台节点能够同时完整容纳目标 Pod 的所有资源请求。
例如目标 Pod 请求 3000m CPU,四台候选节点分别只剩 1000m、1500m、1800m、2000m。总剩余达到 6300m,但最大单节点剩余只有 2000m,因此属于资源碎片。如果这些节点的剩余 CPU 总和本身也低于 3000m,则首先是整体容量不足。
选择治理方向
如果大 Pod 的 requests 代表稳定且真实的资源需求,不应仅为了让它调度成功而随意降低请求。更可靠的做法是增加能够容纳这类 Pod 的节点规格,或规划独立节点池,为大规格工作负载保留足够的单节点容量。
如果 requests 长期明显高于实际使用量,可以结合历史监控重新评估并适度下调。这样能够释放被过度预留的调度容量,但应同时考虑业务峰值、启动阶段和突发流量,避免把调度问题转化为运行期资源不足。
如果大量大小不同的 Pod 形成不规则剩余空间,可以通过滚动发布、受控重调度、调整副本布局或节点池扩缩容逐步改善装箱。Kubernetes 调度器不会为了给新 Pod 腾出连续容量而主动迁移所有已运行 Pod,因此资源碎片通常需要容量规划与工作负载布局共同治理。
最终判断标准不是“整个集群还剩多少资源”,而是“在满足其他调度约束的节点中,是否至少有一台能一次容纳该 Pod 的全部 requests”。抓住这一点,就能避免把资源碎片误判成单纯的集群总容量不足。