
容器与云原生 / 系统课时
设计专用节点池放置策略
设计专用节点池放置策略
专用节点池要同时回答两个问题:专用工作负载应该被放到哪里,以及普通 Pod 是否有资格进入。本课用节点标签、硬节点亲和性、污点与容忍组合出 GPU 专用节点池,并通过 GPU 扩展资源和实际调度结果验证边界。
学习目标
- 区分节点标签、节点亲和性、污点与容忍各自解决的问题
- 为 GPU、系统组件或关键业务设计“限制进入 + 明确选址”的专用节点池
- 通过节点资源与 Pod 放置结果验证专用节点池策略
专用节点池需要两道约束
给 GPU 节点添加 workload.example.com/pool=gpu 标签,只是在节点上提供可匹配属性;普通 Pod 如果没有节点选择约束,仍可能被调度到这类节点。标签本身并不会拒绝其他工作负载。
反过来,只添加 NoSchedule 污点也不够。容忍表示 Pod 允许进入带该污点的节点,但不会把 Pod 吸引过去;没有 nodeSelector 或节点亲和性时,带容忍的 Pod 仍可能落到普通节点。
因此,专用节点池通常把“选址”和“准入”分开:节点标签配合节点亲和性确定专用 Pod 应该去哪,污点配合容忍阻止无资格的 Pod 误入。对于 GPU 池,还要声明 nvidia.com/gpu 扩展资源,确保候选节点真的具备 GPU 配额。
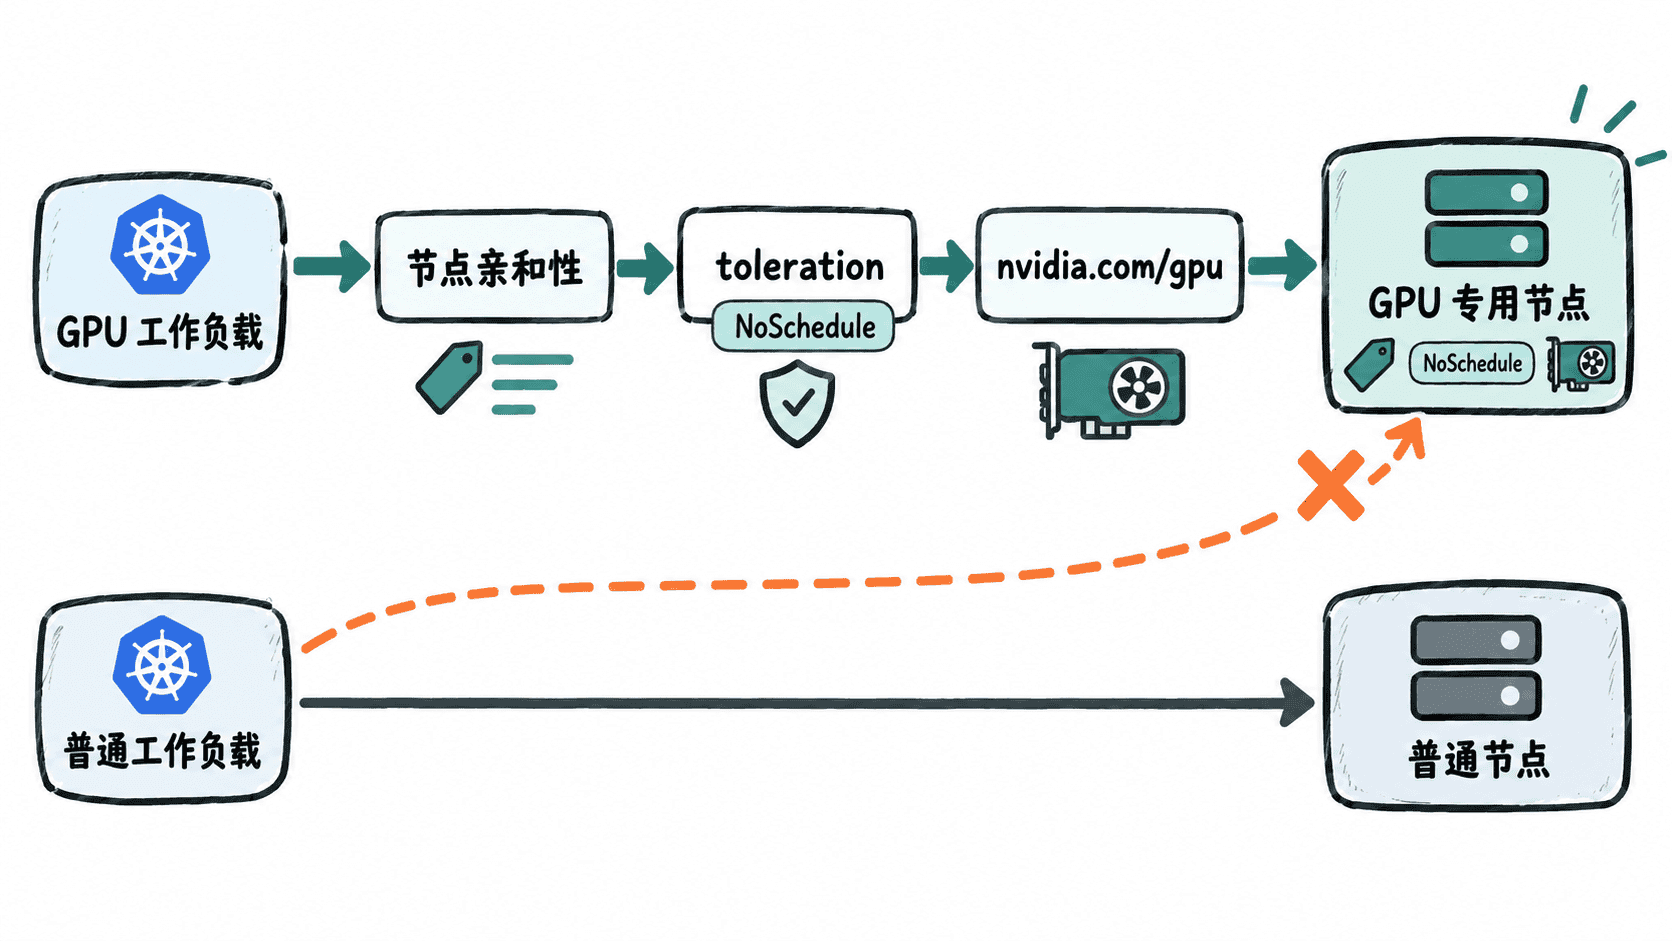
为 GPU 节点建立双重隔离
假设集群中已有 worker-gpu-01,并且 NVIDIA 设备插件已经把 GPU 作为扩展资源上报。先确认节点确实存在可分配 GPU,再添加专用标签和 NoSchedule 污点。
kubectl get node worker-gpu-01 -o jsonpath='GPU={.status.allocatable.nvidia\.com/gpu}{"\n"}'
kubectl label node worker-gpu-01 workload.example.com/pool=gpu --overwrite
kubectl taint node worker-gpu-01 workload.example.com/pool=gpu:NoSchedule --overwrite
kubectl get node worker-gpu-01 --show-labels
kubectl describe node worker-gpu-01
预期结果(关键片段)
GPU=<VALUE>
node/worker-gpu-01 labeled
node/worker-gpu-01 tainted
NAME            STATUS   ROLES    AGE      VERSION   LABELS
worker-gpu-01   Ready    <none>   <TIME>   <VALUE>   ...,workload.example.com/pool=gpu
...
Taints: workload.example.com/pool=gpu:NoSchedule
...<VALUE>、<TIME> 及系统标签会随环境变化,其中第一行的 GPU 值应为正整数。若为空或为 0,应先修复 GPU 节点或设备插件,不能把后续 Pending 误判为亲和性配置错误。
下面用一个文件同时定义专用 Pod 和普通 Pod。gpu-worker 使用硬节点亲和性锁定 GPU 池、用 toleration 通过污点,并显式请求 nvidia.com/gpu;regular-worker 不带任何专用池配置,用来验证普通工作负载不会误入。
apiVersion: v1
kind: Pod
metadata:
  name: gpu-worker
spec:
  affinity:
    nodeAffinity:
      requiredDuringSchedulingIgnoredDuringExecution:
        nodeSelectorTerms:
          - matchExpressions:
              - key: workload.example.com/pool
                operator: In
                values:
                  - gpu
  tolerations:
    - key: workload.example.com/pool
      operator: Equal
      value: gpu
      effect: NoSchedule
  containers:
    - name: worker
      image: nginx:1.27
      resources:
        requests:
          nvidia.com/gpu: "1"
        limits:
          nvidia.com/gpu: "1"
---
apiVersion: v1
kind: Pod
metadata:
  name: regular-worker
spec:
  containers:
    - name: app
      image: nginx:1.27
这里的 nginx 只用于验证调度边界;它虽然请求了 GPU,但不会执行 GPU 计算。真实业务镜像仍需包含与节点驱动和运行时匹配的 GPU 用户态依赖。配置的生效方式通过下一步的 Pod 节点位置和调度事件验证。
选择合适的约束强度
GPU、合规工作负载或核心基础设施通常需要硬节点亲和性加 NoSchedule 污点:前者防止专用 Pod 退化到普通节点,后者防止普通 Pod 误入专用节点。两者解决的是不同方向的问题,不能互相替代。
如果只是希望“尽量靠近”某类节点,可以使用 preferredDuringSchedulingIgnoredDuringExecution 表达偏好,但它不是隔离边界。资源紧张或其他调度评分更高时,Pod 仍可能被放到别处。
系统组件还要检查现有 toleration。部分 DaemonSet 或平台组件带有较宽泛的容忍规则,因此不能只看到节点存在污点就断定已经完全隔离;应以实际 Pod 模板和调度结果为准。
验证放置与隔离边界
保存上面的配置为 dedicated-pool-demo.yaml,一次应用并查看两个 Pod 的放置结果。
kubectl apply -f dedicated-pool-demo.yaml
kubectl get pod gpu-worker regular-worker -o wide
预期结果
pod/gpu-worker created
pod/regular-worker created
NAME             READY     STATUS    RESTARTS   AGE      IP       NODE
gpu-worker       <VALUE>   Running   0          <TIME>   <IP>     worker-gpu-01
regular-worker   <VALUE>   Running   0          <TIME>   <IP>     <VALUE>
gpu-worker 的名称必须与 metadata.name 完全一致,并且 NODE 应为满足标签、污点容忍和 GPU 资源三项条件的节点。regular-worker 的 NODE 不应是带 workload.example.com/pool=gpu:NoSchedule 污点的 GPU 节点;若集群没有其他可用节点,它保持 Pending 反而说明隔离边界生效。
如果 gpu-worker 为 Pending,应检查它的调度事件,重点区分“没有匹配亲和性的节点”“存在未容忍污点”和“Insufficient nvidia.com/gpu”。专用节点池的可靠性来自三个条件同时成立:硬性选址限定去向,污点与容忍控制准入,扩展资源保证节点具备实际能力。