
容器与云原生 / 系统课时
设置调度策略变更门禁
设置调度策略变更门禁
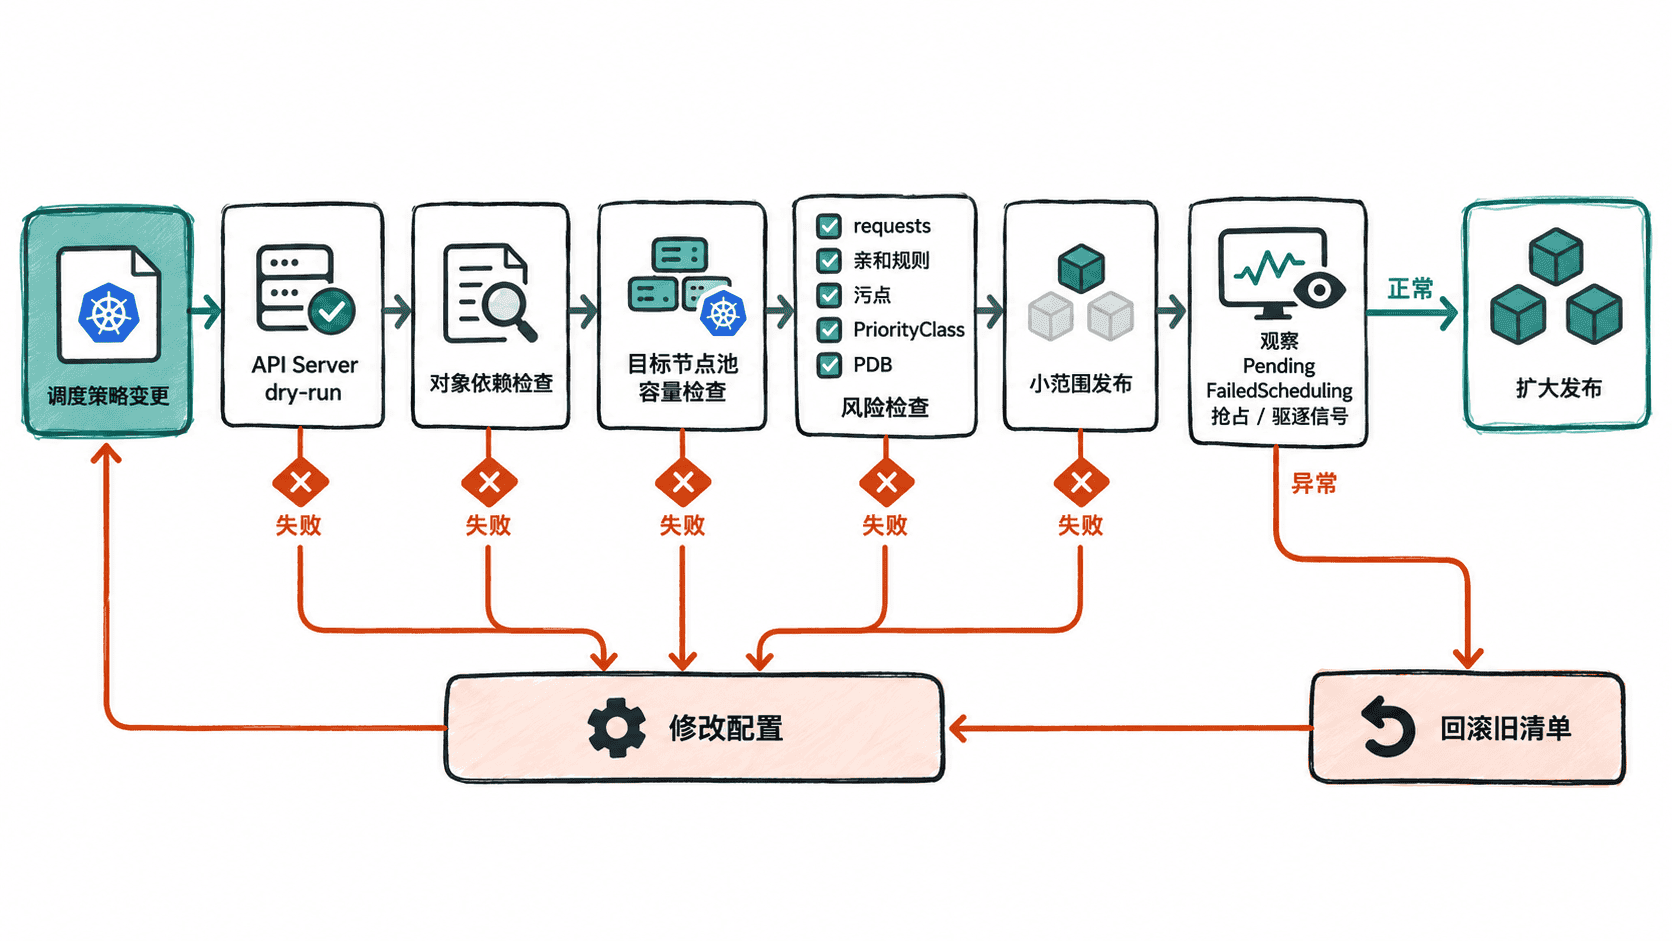
requests、亲和规则、污点、PriorityClass 和 PDB 都会改变 Pod 能否被放置以及故障时能否迁移。调度策略变更必须在发布前验证语义和容量,在发布后检查实际效果,并预先准备能够快速恢复旧策略的回滚路径。
学习目标
- 为常见调度策略变更建立发布前验证和容量检查
- 识别 requests、亲和性、污点、PriorityClass 与 PDB 的组合风险
- 使用服务端校验、差异检查和小范围发布建立可回滚门禁
先验证对象是否能够被 API Server 接受
第一道门禁是语法与 API 语义校验。不要等到正式发布才发现字段路径、枚举值或对象引用错误。对准备上线的清单执行服务端 dry-run,可以让 API Server 完成准入和 schema 校验,但不会真正创建资源。
kubectl apply --server-side --dry-run=server -f workload.yaml预期输出
deployment.apps/<ID> serverside-applied (server dry run)资源名称会随实际清单变化。如果对象引用了不存在的 PriorityClass 等外部对象,仅靠通用 schema 校验未必能覆盖全部运行期关系,因此下一步仍要做依赖与容量检查。
对五类高风险变化逐项设门禁
不同调度字段造成的风险不同,不能用“YAML 能 apply”作为统一放行条件。
- requests:检查单 Pod 请求量、扩容后的总请求量,以及目标节点池单节点是否存在足够连续容量。总剩余资源充足,不代表存在任意一个节点能容纳该 Pod。
- 亲和与反亲和:检查 required 条件是否会把候选节点筛成零,并确认 topologyKey 对应标签真实存在于目标节点上。
- 污点与容忍:新增
NoSchedule前检查现有工作负载是否具备 toleration;新增NoExecute时还要评估已经运行的 Pod 是否会被驱逐。 - PriorityClass:提高优先级前检查是否可能触发抢占,并限制高优先级工作负载的使用范围,避免普通业务普遍升级优先级后失去区分度。
- PDB:验证
minAvailable或maxUnavailable是否与副本数和维护策略匹配。PDB 主要约束支持 Eviction API 的自愿驱逐,并不能保证 Pod 永远不会消失。
在变更前检查真实节点条件
对 required nodeAffinity、nodeSelector、污点和资源 requests 的修改,应在发布前直接检查目标节点。下面的命令能快速看到标签、污点和可分配资源,是判断候选节点是否真实存在的基础证据。
kubectl get nodes --show-labels
kubectl describe nodes
预期输出
NAME     STATUS   ROLES    AGE       VERSION   LABELS
node-a   Ready    <none>   <VALUE>   <VALUE>   <VALUE>

Name:               node-a
Taints:             <VALUE>
Allocatable:
  cpu:              <VALUE>
  memory:           <VALUE>
实际标签、污点和资源值取决于集群。检查时不要只确认“有这种节点”,还应确认满足全部硬约束的节点数量足以承担副本数,并为节点故障、滚动升级和扩容留出余量。
用小范围发布验证调度结果
通过静态检查后,仍应在测试环境或受控的小范围工作负载中观察真实调度。发布后重点检查 Pod 是否被绑定、是否出现 FailedScheduling,以及是否出现非预期抢占或驱逐。
kubectl get pods -n <NAMESPACE> -o wide
kubectl get events -n <NAMESPACE> --sort-by=.lastTimestamp
预期输出
NAME        READY   STATUS    NODE
<POD>       1/1     Running   node-a

LAST SEEN   TYPE     REASON      OBJECT      MESSAGE
<TIME>      Normal   Scheduled   pod/<POD>   Successfully assigned <NAMESPACE>/<POD> to node-a
如果出现 FailedScheduling、Preempted、Evicted 或大量副本长时间 Pending,应停止扩大发布并定位原因。只有观察窗口内调度结果符合预期,才允许将策略推广到剩余工作负载。
让回滚成为发布条件而不是事故后的补救
门禁的最后一项是确认旧配置可以恢复。调度策略通常保存在声明式清单或版本控制中,因此变更前必须保留已验证的上一版本,并确认回滚不会依赖已经删除的 PriorityClass、节点标签或其他外部条件。
对于污点这类直接修改 Node 的操作,还应记录反向命令。例如新增污点后,需要能够准确删除同一个 key 和 effect:
kubectl taint nodes node-a workload.example.com/dedicated=batch:NoSchedule-预期输出
node/node-a untainted完整门禁应形成固定顺序:先校验对象,再检查依赖与容量,随后进行小范围真实调度验证,观察 Pending、抢占和驱逐信号,最后才扩大发布。任何一步无法证明安全或无法可靠回滚,都不应进入下一阶段。