
容器与云原生 / 系统课时
认识 Pod 放置决策链路
认识 Pod 放置决策链路
创建 Pod 并不意味着它立刻属于某台 Node。本课沿着 API Server、Scheduler、绑定和 Kubelet 的协作链路,建立从“待调度 Pod”到“节点开始运行 Pod”的完整心智模型,并区分调度决策与实际启动容器的职责边界。
学习目标
- 说清 Pod 从创建到绑定 Node 的关键组件与状态变化
- 区分 Scheduler 的放置决策、Binding 与 Kubelet 启动职责
- 能从 Pod 状态判断问题发生在调度前、调度中还是节点执行阶段
Pod 创建后为什么还没有节点
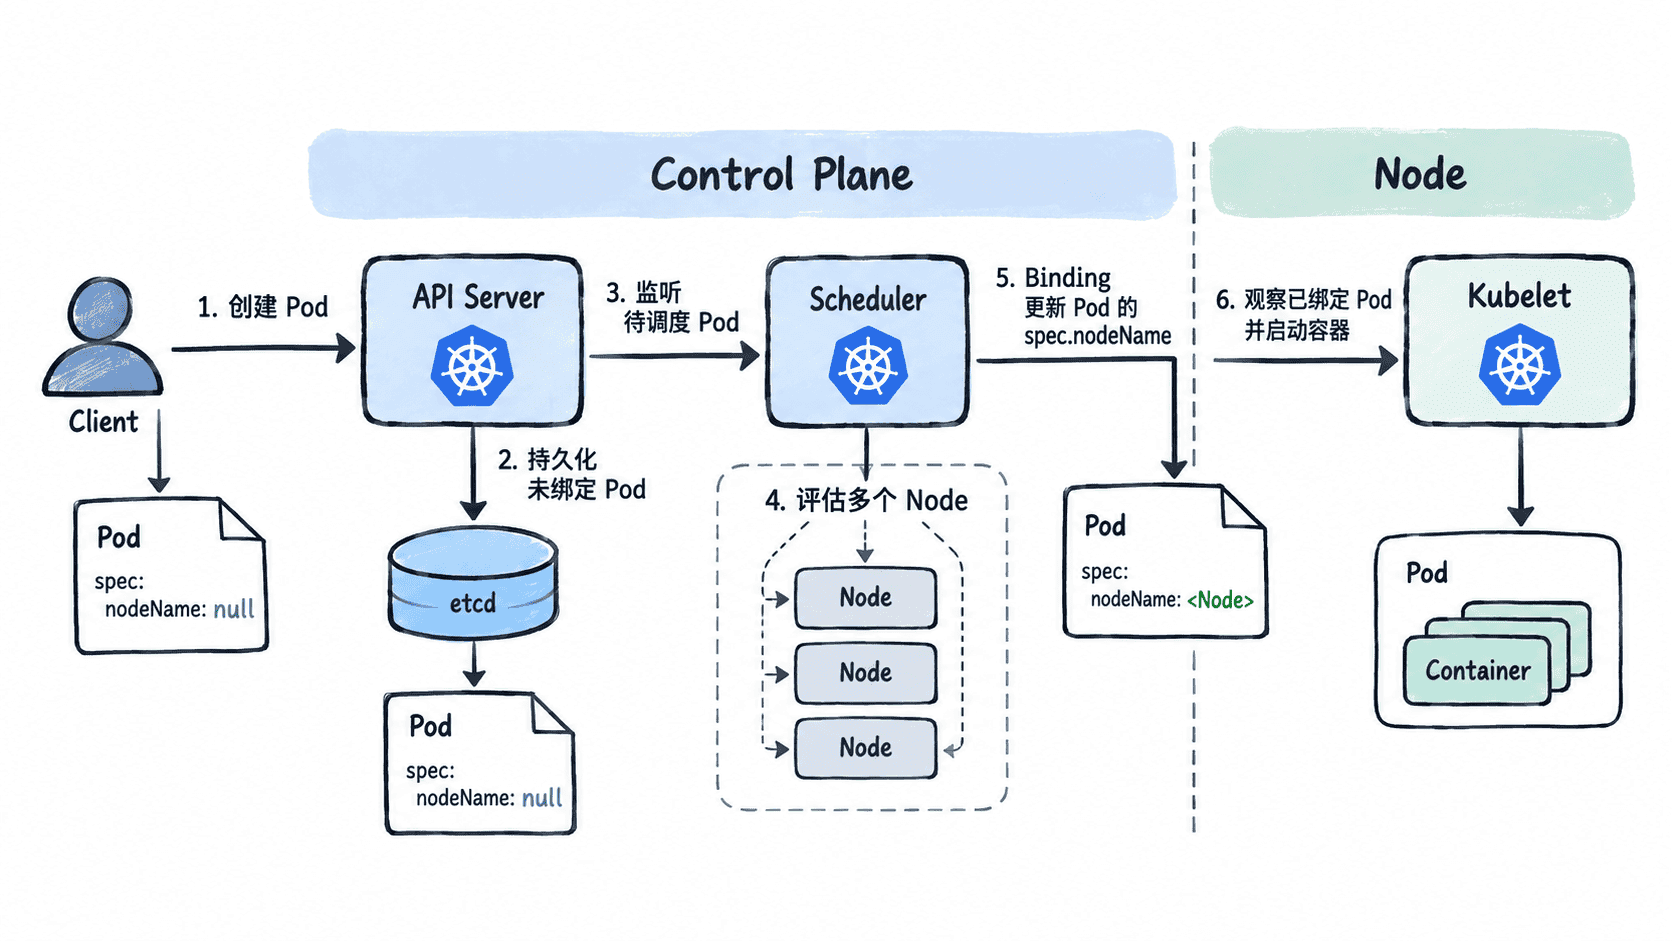
客户端向 API Server 创建 Pod 后,Pod 对象首先被持久化到集群状态中。如果 Pod 没有预先指定 spec.nodeName,它最初没有归属节点,Scheduler 会关注这类尚未绑定的 Pod,并尝试为其寻找可接受的 Node。
此时常见现象是 Pod 处于 Pending。但 Pending 不是“Scheduler 一定出了故障”的同义词:它既可能表示 Pod 尚未完成调度,也可能表示已经绑定 Node、但镜像拉取或容器准备工作尚未完成。因此判断放置问题时,不能只看 Phase,还要结合 spec.nodeName、Condition 和事件。
Scheduler 决定放哪里
Scheduler 的核心职责不是启动 Pod,而是为一个待调度 Pod 选择合适的 Node。它读取 Pod 的资源请求、节点属性和调度约束,再结合当前集群状态完成候选节点筛选与优先级比较。
调度决策会受到资源可用量、NodeSelector、节点亲和性、Pod 亲和与反亲和、污点与容忍、拓扑分布约束等条件影响。有些约束属于硬条件,不满足就不能选择该 Node;另一些属于偏好,只影响多个可行 Node 之间的排序。
Scheduler 选出目标 Node 后,会执行绑定,使 Pod 与 Node 的关系写回 API。最关键的结果是 Pod 的 spec.nodeName 被设置。到这里,“放在哪里”的控制平面决策才算完成。
Kubelet 让绑定结果变成运行实例
每台 Node 上的 Kubelet 会持续观察分配给本节点的 Pod。发现新的已绑定 Pod 后,它根据 PodSpec 准备卷、网络、Secret 或 ConfigMap 等依赖,并通过容器运行时创建容器。
因此 Scheduler 和 Kubelet 的职责边界很明确:Scheduler 回答“这个 Pod 应该去哪个 Node”,Kubelet 回答“已经分给我的 Pod 如何真正运行起来”。Scheduler 不负责拉取镜像,也不会直接启动容器;Kubelet 同样不会替 Scheduler 在整个集群中挑选最佳 Node。
如果一个 Pod 没有 spec.nodeName,优先调查调度条件与 Scheduler 事件;如果已经有 spec.nodeName,则应进一步检查目标 Node、Kubelet、镜像拉取、卷挂载和容器启动等节点侧问题。
用对象状态判断链路停在哪里
排查放置问题时,可以先用几个对象信号缩小范围。spec.nodeName 为空,说明尚未完成绑定;PodScheduled Condition 为 False 时,通常可以从其 Reason、Message 和事件中看到不可调度原因;已经绑定 Node 后出现 ImagePullBackOff、ContainerCreating 等状态,则已不是节点选择本身的问题。
可以直接检查 Pod 的节点绑定字段、调度 Condition 和近期事件:
kubectl get pod <POD_NAME> -n <NAMESPACE> -o jsonpath='{.spec.nodeName}{"\n"}{.status.conditions[?(@.type=="PodScheduled")].status}{"\n"}'
kubectl describe pod <POD_NAME> -n <NAMESPACE>
预期结果
<NODE_NAME 或空行>
True 或 False

Name:           <POD_NAME>
Namespace:      <NAMESPACE>
...
Events:
  ...
实际输出会因 Pod 当前阶段和集群状态而不同;<POD_NAME>、<NAMESPACE> 和 <NODE_NAME> 需要替换或结合实际值判断。若 spec.nodeName 为空且 PodScheduled=False,重点查看 FailedScheduling 等事件;若已经绑定 Node,则继续沿节点侧启动链路排查。
调度是持续控制过程,而不是一次性脚本。某次尝试找不到可行 Node 时,Pod 可以继续等待;随着节点资源释放、集群扩容或约束条件改变,Scheduler 后续可能再次尝试并成功完成放置。理解这条链路后,看到一个未运行的 Pod 时,应先判断它处在创建、等待调度、节点绑定还是节点执行阶段,再把问题交给对应组件和证据。