
容器与云原生 / 系统课时
分析抢占后的调度窗口
分析抢占后的调度窗口
抢占决定完成并不等于高优先级 Pod 已经绑定节点。牺牲者需要终止,节点资源需要重新释放,而调度状态在这段时间仍会变化。本课聚焦这个容易被忽略的窗口,解释 nominatedNodeName、终止宽限期以及并发调度变化为什么会让抢占出现延迟甚至失效。
学习目标
- 理解被提名节点与真正绑定节点的区别
- 说明牺牲者终止宽限期为何会延迟高优先级 Pod 调度
- 判断哪些集群变化会使一次抢占结果失效或被重新计算
被提名节点不是已经完成绑定
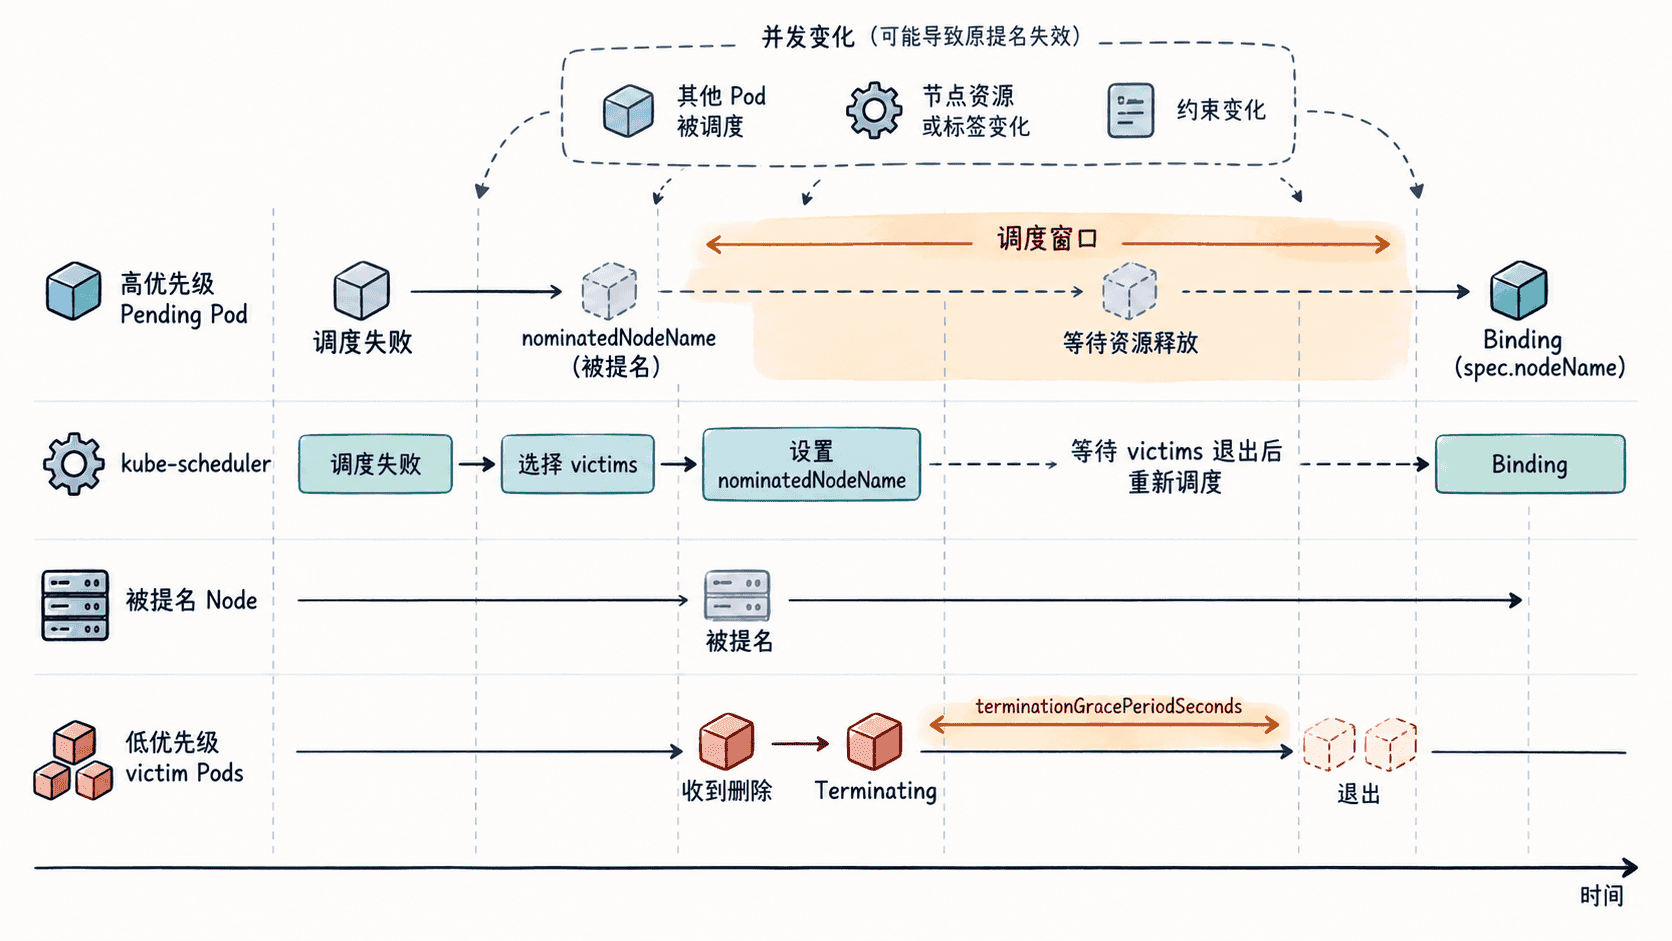
Scheduler 找到可行的抢占方案后,会删除选中的低优先级 victims,并可能通过 Pod 状态中的 nominatedNodeName 表示当前预期让高优先级 Pod 落到哪个节点。
这个字段只是调度过程中的提示信息,不是绑定承诺。真正决定 Pod 已经被放置的是绑定结果,例如最终写入的 spec.nodeName。在 victims 尚未退出、资源尚未真正可用之前,高优先级 Pod 仍可能保持 Pending。
终止宽限期会形成真实等待窗口
被抢占 Pod 被删除后通常不会瞬间消失。Kubelet 会按照 Pod 的终止流程处理它,例如执行 preStop、向容器发送终止信号并等待 terminationGracePeriodSeconds。在这些 Pod 真正退出前,高优先级 Pod 所需的资源未必已经全部释放。
假设一个节点只需再释放 4 CPU 就能容纳抢占者,而 victims 的终止宽限期为 30 秒,那么抢占者可能在这段时间继续 Pending。若业务 Pod 设置了较长的优雅退出时间,抢占到重新调度之间的延迟会更加明显。
等待期间集群并不是静止的
抢占后的窗口内,Scheduler 仍在处理其他 Pod,节点状态也会持续变化。因此一次计算得到的候选节点并不保证稍后仍然可行。
例如,其他更高优先级 Pod 可能竞争同一个节点;节点可能增加污点、变为不可调度或发生资源变化;新的 Pod 可能改变 PodAffinity 或 PodAntiAffinity 的拓扑条件。即使原先 victims 全部退出,待调度 Pod 也可能需要重新执行过滤和评分,而不是机械地落到之前的提名节点。
反过来,抢占者也可能在另一个节点上突然获得更好的可行机会。例如其他节点上的 Pod 正常结束释放资源,Scheduler 可以在那里直接完成调度,此时原来的提名就不再重要。
为什么提名可能失效
nominatedNodeName 应当理解为“当前抢占计算认为值得等待的节点”,而不是资源预留。它不能阻止其他调度状态变化,也不能替代下一轮调度检查。
因此排查抢占延迟时,不能只看到一个 nominated node 就断言 Scheduler 卡住了。应结合 victims 是否仍在 Terminating、节点当前 allocatable 与 requests、污点和标签、亲和性规则以及最新调度事件一起判断。
如果 victims 已全部退出,但高优先级 Pod 依旧无法在提名节点通过 Filter,Scheduler 会继续寻找新的调度机会。原先的抢占计算只是基于当时集群快照做出的决策,条件变化后需要重新评估。
排查时按时间顺序还原事件
分析“已经发生抢占但 Pod 迟迟不运行”时,最有效的方法是还原时间线:先确认何时选择 victims,再看 victims 是否进入 Terminating、何时真正退出,随后检查抢占者是否仍指向原节点以及最新 FailedScheduling 原因。
如果等待时间与 victims 的终止宽限期基本一致,通常是正常的资源释放过程;如果 victims 已退出而 Pod 仍然 Pending,就应重新检查节点约束与并发变化,而不是继续把问题归因于终止过程。
抢占最终提供的不是一个锁定席位,而是一次创造调度机会的尝试。理解这个时间窗口,才能正确区分正常等待、提名失效以及新的调度条件变化。