
容器与云原生 / 系统课时
处理 NoExecute 驱逐
处理 NoExecute 驱逐
NoExecute 既影响新 Pod 能否进入节点,也会作用于已经绑定到节点的 Pod。本课通过一个延迟驱逐实验说明立即驱逐、限时容忍与持续容忍的差异,并把用户自定义污点与节点异常自动污点的产生者和排障证据分开。
学习目标
- 判断
NoExecute污点对新 Pod 与已有 Pod 的影响 - 使用
tolerationSeconds控制 Pod 对指定污点的容忍时长 - 区分用户自定义
NoExecute污点与节点异常自动污点,并据此解释驱逐时间
NoExecute 同时影响调度和存量 Pod
节点存在 NoExecute 污点时,新 Pod 若没有匹配的 toleration,调度器不会把它调度到该节点;已经绑定到该节点的 Pod 若不能容忍该污点,则会进入基于污点的驱逐流程。
匹配关系有三种典型结果:没有匹配 toleration 时驱逐;有匹配 toleration 且未设置 tolerationSeconds 时持续容忍;设置 tolerationSeconds 时只在指定秒数内容忍,超时后开始驱逐。tolerationSeconds 只对 NoExecute 有意义。
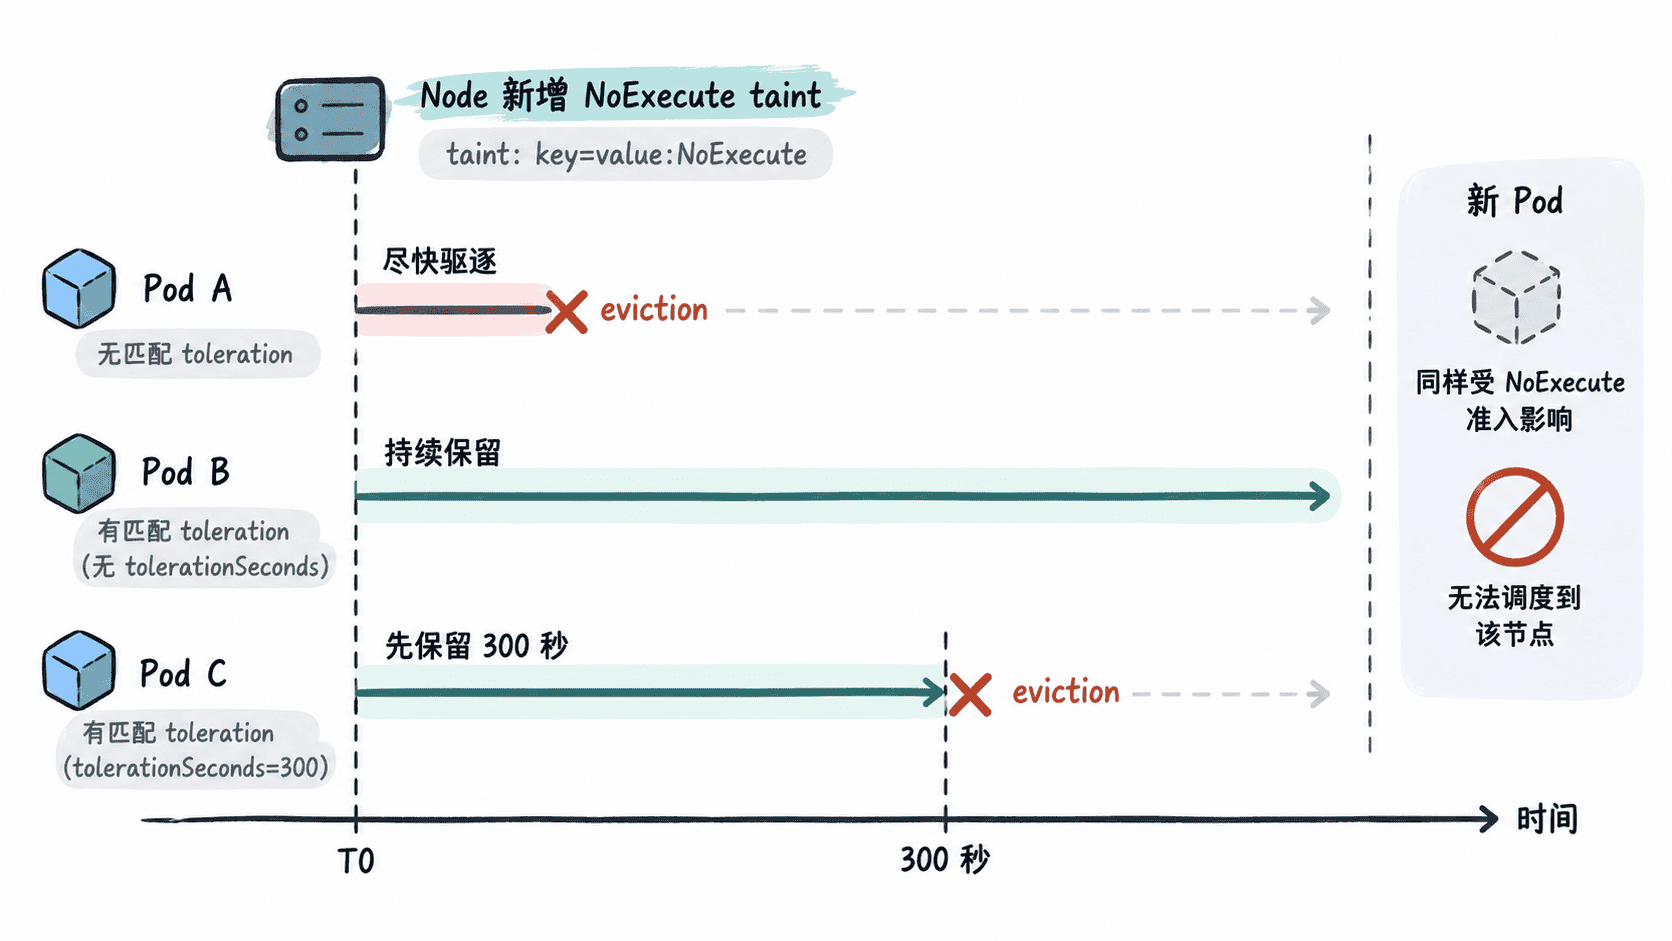
复现延迟驱逐
下面创建一个带自定义 NoExecute toleration 的 Pod,并把容忍时间设置为 60 秒。实验应在测试集群进行,因为给节点添加 NoExecute 污点可能影响同节点上的其他 Pod。
apiVersion: v1
kind: Pod
metadata:
  name: noexecute-demo
spec:
  containers:
    - name: web
      image: nginx:1.27
  tolerations:
    - key: maintenance.example.com/drain
      operator: Equal
      value: planned
      effect: NoExecute
      tolerationSeconds: 60
这是配置文件,本身不会产生控制台输出。保存为 noexecute-demo.yaml 后应用,并记录 Pod 所在节点。
kubectl apply -f noexecute-demo.yaml
kubectl get pod noexecute-demo -o wide
预期输出
pod/noexecute-demo created
NAME             READY   STATUS    RESTARTS   AGE      IP     NODE       NOMINATED NODE   READINESS GATES
noexecute-demo   1/1     Running   0          <TIME>   <IP>   <NODE>     <none>           <none>
实际 AGE、IP 和节点名会不同。取得 <NODE> 后,为该节点增加与 Pod toleration 完全匹配的自定义 NoExecute 污点,并持续观察 Pod。
kubectl taint node <NODE> maintenance.example.com/drain=planned:NoExecute
kubectl get pod noexecute-demo -w
预期结果
node/<NODE> tainted
NAME             READY   STATUS        RESTARTS   AGE
noexecute-demo   1/1     Running       0          <TIME>
noexecute-demo   1/1     Terminating   0          <TIME>
Pod 通常会先保持 Running,在该污点持续存在约 60 秒后才开始终止。60 秒表示 Pod 仍可容忍污点的时间,不包含进入终止后的退出耗时;真正删除还可能受到 Pod 终止宽限期等因素影响。
实验结束后删除污点,避免继续影响节点上的工作负载。
kubectl taint node <NODE> maintenance.example.com/drain:NoExecute-预期输出
node/<NODE> untainted区分自定义污点与节点异常自动污点
两类 NoExecute 污点的产生者不同,排障证据也不同。自定义污点通常由管理员、运维脚本或平台控制器显式写入 Node;node.kubernetes.io/not-ready 与 node.kubernetes.io/unreachable 则由 node controller 根据 Node 的 Ready=False 或 Ready=Unknown 状态自动维护。
| 类别 | 典型污点 | 产生者 | 优先核对的证据 |
|---|---|---|---|
| 用户自定义 | maintenance.example.com/drain=planned:NoExecute |
管理员、脚本或平台控制器 | Kubernetes 审计日志、自动化任务日志、变更记录 |
| 节点异常自动污点 | node.kubernetes.io/not-ready:NoExecute、node.kubernetes.io/unreachable:NoExecute |
node controller | Node Ready Condition、lastTransitionTime、当前 taint、控制面日志 |
现代 Kubernetes 中,“添加节点异常污点”和“执行基于污点的 Pod 驱逐”也不是同一个职责:node controller 维护这类内置节点异常污点;自 Kubernetes 1.29 起,驱逐执行逻辑移入 kube-controller-manager 中独立的 taint eviction controller。
普通 Pod 默认还会获得针对 node.kubernetes.io/not-ready 与 node.kubernetes.io/unreachable 的 300 秒 NoExecute toleration,除非 Pod 或控制器已经显式设置这两类 toleration。这个默认行为只针对这些内置节点异常污点,不能套用到前面的自定义污点。
下面用同一组命令核对 Node Condition、taint 和 Pod toleration。若目标节点当前是不可达状态,三类证据应能互相印证。
kubectl get node <NODE> -o jsonpath='{range .status.conditions[?(@.type=="Ready")]}Ready={.status} reason={.reason} transition={.lastTransitionTime}{"\n"}{end}'
kubectl get node <NODE> -o jsonpath='{range .spec.taints[*]}key={.key} value={.value} effect={.effect}{"\n"}{end}'
kubectl get pod <POD> -o jsonpath='{range .spec.tolerations[?(@.key=="node.kubernetes.io/unreachable")]}key={.key} operator={.operator} effect={.effect} seconds={.tolerationSeconds}{"\n"}{end}'
预期结果
Ready=Unknown reason=<VALUE> transition=<TIME>
key=node.kubernetes.io/unreachable value= effect=NoExecute
key=node.kubernetes.io/unreachable operator=Exists effect=NoExecute seconds=300
reason 和时间会随现场变化;若 Pod 显式覆盖了该 toleration,operator 或 seconds 也可能不同。看到自定义键时应追查谁修改了 Node;看到 not-ready 或 unreachable 时则应先解释对应的 Ready 状态变化,再检查节点心跳、网络和控制面记录。
驱逐时间不是单一计时器
tolerationSeconds 决定的是匹配 NoExecute 污点持续存在时,Pod 还能保持绑定多久。它不等价于业务恢复时间,也不保证 Pod 会在某个精确秒数从 API 中消失;节点状态传播、控制器处理和 Pod 自身终止过程都会影响最终观察到的时间。
判断一次 NoExecute 驱逐是否符合预期,应依次核对污点来源、Node Condition、污点出现时间、Pod toleration 的匹配关系与容忍秒数,再结合终止过程解释最终耗时。