
容器与云原生 / 系统课时
避免不可满足的节点约束
避免不可满足的节点约束
节点约束写得越多并不代表放置越安全。标签漂移、多个硬规则求交集以及维护期间先删标签后改工作负载,都可能让 Pod 长期停在 Pending。本课建立一套从事件到约束集合的排查方法,并给出不会瞬间清空候选节点的变更顺序。
学习目标
- 从 Pod 事件识别不可满足的节点选择与亲和性约束
- 判断标签漂移、规则冲突和过度约束如何把候选节点缩减为零
- 采用先扩后收的方式安全修改节点标签与调度规则
Pending 的本质是候选节点被筛空
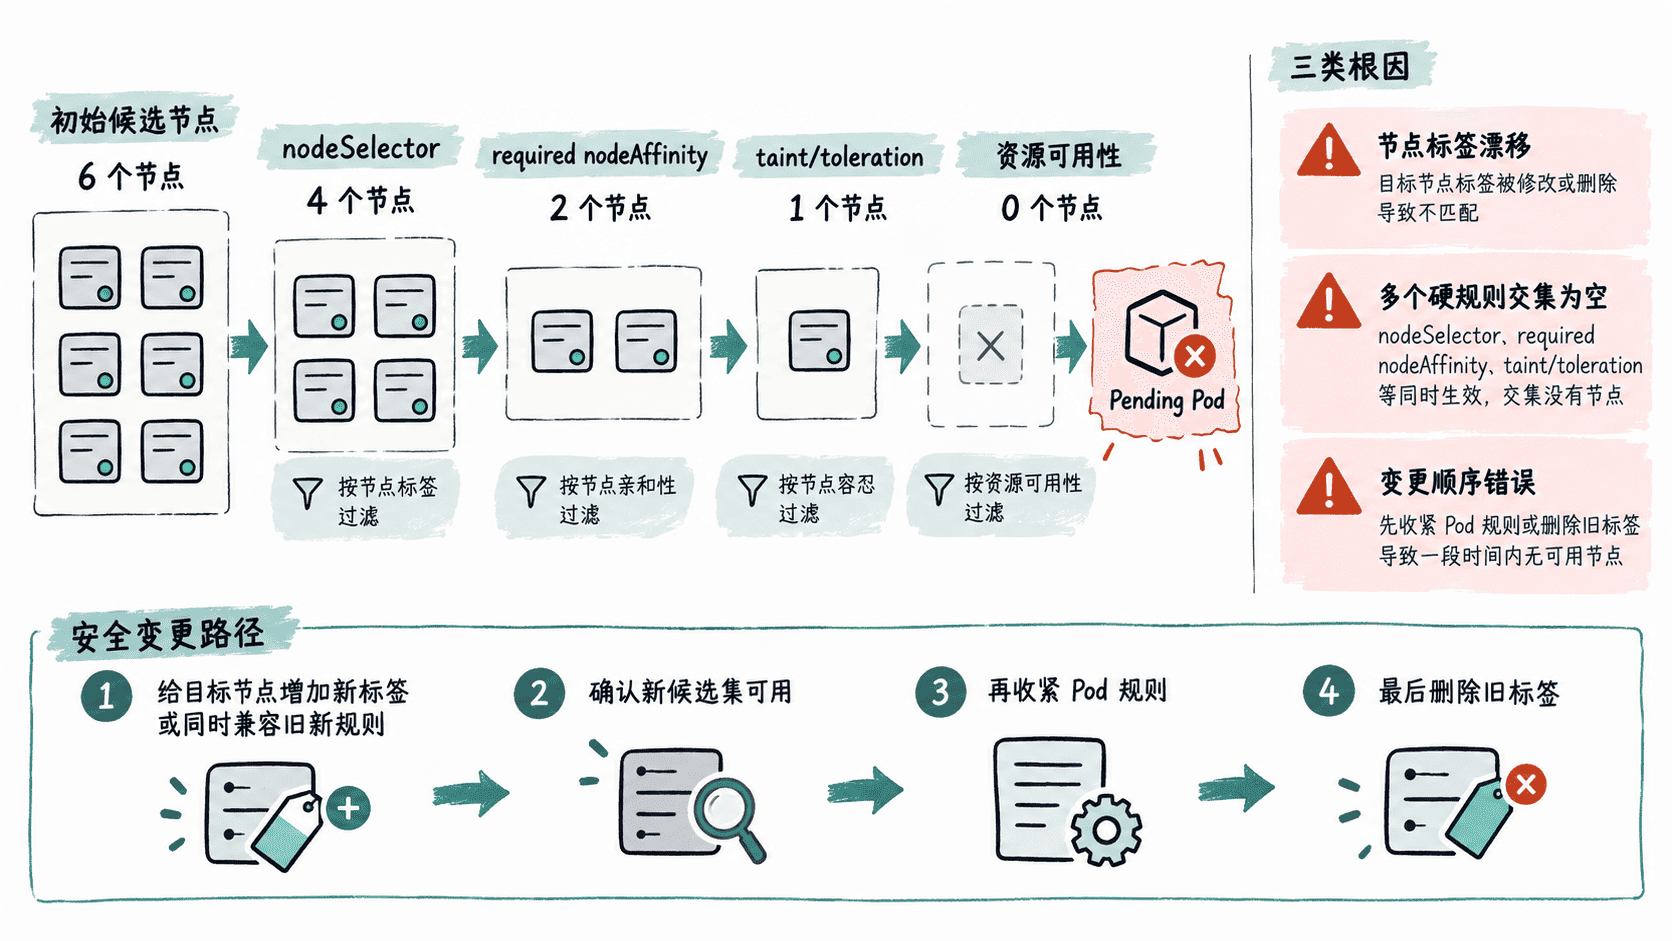
调度器会逐步过滤不满足条件的节点。假设一个 Pod 同时要求节点位于 zone-a、属于 high-performance 节点池,并具有 disk=nvme。这些硬约束不是三选一,而是共同成立;只要集群中没有节点同时满足全部条件,Pod 就无法调度。
同一 nodeSelectorTerm 内不同 matchExpressions 之间是 AND 关系,而 nodeSelectorTerms 数组中的多个 term 之间是 OR 关系。再叠加 nodeSelector、资源请求、污点等过滤条件后,最终候选集还会继续缩小。
先从调度事件判断是哪类过滤失败
遇到长期 Pending 时,先不要立即放宽规则。先查看 Pod 条件和最近事件,确认失败发生在调度阶段,而不是镜像拉取或容器启动阶段。
kubectl get pod placement-demo -o wide
kubectl describe pod placement-demo
预期结果
NAME             READY   STATUS    RESTARTS   AGE      IP       NODE
placement-demo   0/1     Pending   0          <TIME>   <none>   <none>
...
Events:
  Type     Reason            Age      From               Message
  ----     ------            ----     ----               -------
  Warning  FailedScheduling  <TIME>   default-scheduler  0/<VALUE> nodes are available: <VALUE> node(s) didn't match Pod's node affinity/selector.
事件中的节点数量和具体原因会随集群状态变化,因此用 <VALUE> 表示动态值。didn't match Pod's node affinity/selector 明确说明问题在节点选择约束;如果事件显示 Insufficient cpu 或 untolerated taint,则应转向资源或污点条件,而不是修改标签表达式。
对照 Pod 规则与真实节点标签
一个典型的过度约束 Pod 可能同时使用 nodeSelector 和 required 节点亲和性。下面是片段示例,依赖它位于某个 Pod 的 spec 中:
nodeSelector:
  workload.example.com/tier: high-performance

affinity:
  nodeAffinity:
    requiredDuringSchedulingIgnoredDuringExecution:
      nodeSelectorTerms:
        - matchExpressions:
            - key: topology.kubernetes.io/zone
              operator: In
              values:
                - zone-a
            - key: workload.example.com/disk
              operator: In
              values:
                - nvme
这意味着候选节点必须同时满足 tier=high-performance、zone=zone-a 和 disk=nvme。验证时应直接检查当前节点标签,而不是依赖旧文档或节点池命名约定。
kubectl get nodes -L workload.example.com/tier,topology.kubernetes.io/zone,workload.example.com/disk预期结果
NAME        STATUS   ROLES    AGE      VERSION   TIER               ZONE     DISK
worker-01   Ready    <none>   <TIME>   <VALUE>   high-performance   zone-a   <none>
worker-02   Ready    <none>   <TIME>   <VALUE>   high-performance   zone-b   nvme
worker-03   Ready    <none>   <TIME>   <VALUE>   <none>             zone-a   nvme
这个结果中每个节点都只满足部分条件,因此三条规则的交集为空。真实节点名、版本和时间会不同,但分析方法相同:逐列寻找是否至少存在一行同时满足所有硬约束。
警惕标签漂移和规则冲突
标签漂移常发生在节点池重建、自动伸缩或基础设施脚本升级后。例如旧节点使用 workload.example.com/tier=high-performance,新节点改成 workload.example.com/tier=performance,而 Deployment 仍引用旧值。节点本身全部健康,但工作负载会因为硬约束再也找不到候选节点。
另一类问题是两个独立团队分别增加了看起来合理的规则。平台团队限定可用区,应用团队限定节点池,安全策略又增加额外污点;单独验证时每项都有匹配节点,组合后却可能没有任何节点通过全部过滤条件。
用先扩后收避免变更期间归零
假设要把节点标签从 tier=high-performance 迁移到 tier=performance。危险做法是先删除所有旧标签,再更新工作负载;这会制造一个没有任何节点满足旧规则的窗口,新建或重建的 Pod 会立即 Pending。
更安全的过程是先让目标节点同时拥有新旧标签,确认新标签覆盖了足够节点,再修改工作负载规则,最后删除旧标签。
kubectl label node worker-01 workload.example.com/tier=performance
kubectl get nodes -l workload.example.com/tier=performance
预期结果
node/worker-01 labeled
NAME        STATUS   ROLES    AGE      VERSION
worker-01   Ready    <none>   <TIME>   <VALUE>
确认新标签已经存在后,再发布引用新值的工作负载,并观察新 Pod 能成功调度。只有当所有受影响工作负载都完成迁移,才移除旧标签。
kubectl label node worker-01 workload.example.com/tier-预期结果
node/worker-01 unlabeled这里末尾的 - 表示删除该标签。执行前必须确认没有仍依赖旧标签值的工作负载,否则会重新制造不可满足约束。
变更后验证新旧副本都能调度
仅看到 Deployment 配置更新成功还不够。调度约束的问题通常在新副本创建时才暴露,因此应检查工作负载状态和 Pod 事件。
kubectl rollout status deployment/<VALUE>
kubectl get pods -o wide
kubectl get events --sort-by=.lastTimestamp
预期结果
deployment "<VALUE>" successfully rolled out
NAME        READY   STATUS    RESTARTS   AGE      IP     NODE
<VALUE>     1/1     Running   0          <TIME>   <IP>   <VALUE>
...<VALUE>、<TIME> 和 <IP> 都取决于实际环境。验收重点是新创建的 Pod 能获得节点,并且最近事件中没有持续出现 FailedScheduling。如果只是现存 Pod 仍在运行,不能证明新的调度约束可满足,因为 requiredDuringSchedulingIgnoredDuringExecution 主要在调度时进行节点选择。
避免长期 Pending 的关键不是减少所有约束,而是让每一条硬约束都对应可验证的节点事实,并在变更时始终保留至少一个满足完整条件的候选集合。先扩展可接受范围、验证新路径,再删除旧路径,能够显著降低标签迁移和规则调整导致的调度中断。