
容器与云原生 / 系统课时
配置拓扑分布约束
配置拓扑分布约束
topologySpreadConstraints 用来控制同一组 Pod 在节点、可用区等拓扑域中的分布。配置时要先明确“统计哪些 Pod”“按什么 Node 标签划分域”“允许多大偏差”,再决定约束无法满足时阻止调度还是尽量靠拢。本课用一个 6 副本 Deployment 完成配置与验证。
学习目标
- 能为 Deployment 配置基于可用区的
topologySpreadConstraints - 能解释
labelSelector、topologyKey、maxSkew与whenUnsatisfiable的作用 - 能用
kubectl核对 Pod 所在节点与可用区分布
先确认拓扑标签
拓扑域来自 Node 标签。同一个 topologyKey 下,相同标签值属于同一域。下面假设实验集群有 node-a、node-b、node-c 三个可调度节点,并把它们分别标记为三个 zone。生产环境通常由云厂商或集群组件维护 topology.kubernetes.io/zone,不要随意覆盖已有标签。
kubectl label node node-a topology.kubernetes.io/zone=zone-a --overwrite >/dev/null
kubectl label node node-b topology.kubernetes.io/zone=zone-b --overwrite >/dev/null
kubectl label node node-c topology.kubernetes.io/zone=zone-c --overwrite >/dev/null
kubectl get nodes -L topology.kubernetes.io/zone
预期输出
NAME     STATUS   ROLES    AGE      VERSION   ZONE
node-a   Ready    <none>   <TIME>   <VALUE>   zone-a
node-b   Ready    <none>   <TIME>   <VALUE>   zone-b
node-c   Ready    <none>   <TIME>   <VALUE>   zone-c
实际 AGE、VERSION 和节点角色可能不同;关键是参与实验的节点为 Ready,且 ZONE 列具有预期值。这里应使用 -L topology.kubernetes.io/zone,不能把标签键误拼进参数。
配置按可用区均衡分布
将下面内容保存为 spread-demo.yaml。labelSelector 统计同一命名空间中带 app=spread-demo 的 Pod;topologyKey 按 Node 的 zone 标签分桶;maxSkew: 1 配合 DoNotSchedule 表示新 Pod 只能放到不会让目标域相对全局最小值超过 1 的位置,否则保持 Pending。
apiVersion: apps/v1
kind: Deployment
metadata:
  name: spread-demo
spec:
  replicas: 6
  selector:
    matchLabels:
      app: spread-demo
  template:
    metadata:
      labels:
        app: spread-demo
    spec:
      topologySpreadConstraints:
        - maxSkew: 1
          topologyKey: topology.kubernetes.io/zone
          whenUnsatisfiable: DoNotSchedule
          labelSelector:
            matchLabels:
              app: spread-demo
      containers:
        - name: pause
          image: registry.k8s.io/pause:3.10
这里的“域”不是所有可能的 zone 名称,而是调度器当前能够从 Node 上识别并纳入约束计算的拓扑域。缺少 topology.kubernetes.io/zone 的节点会被该约束跳过,节点上的匹配 Pod 也不会参与该约束的计数,新 Pod 也不会因为这个约束被调度到这类节点。
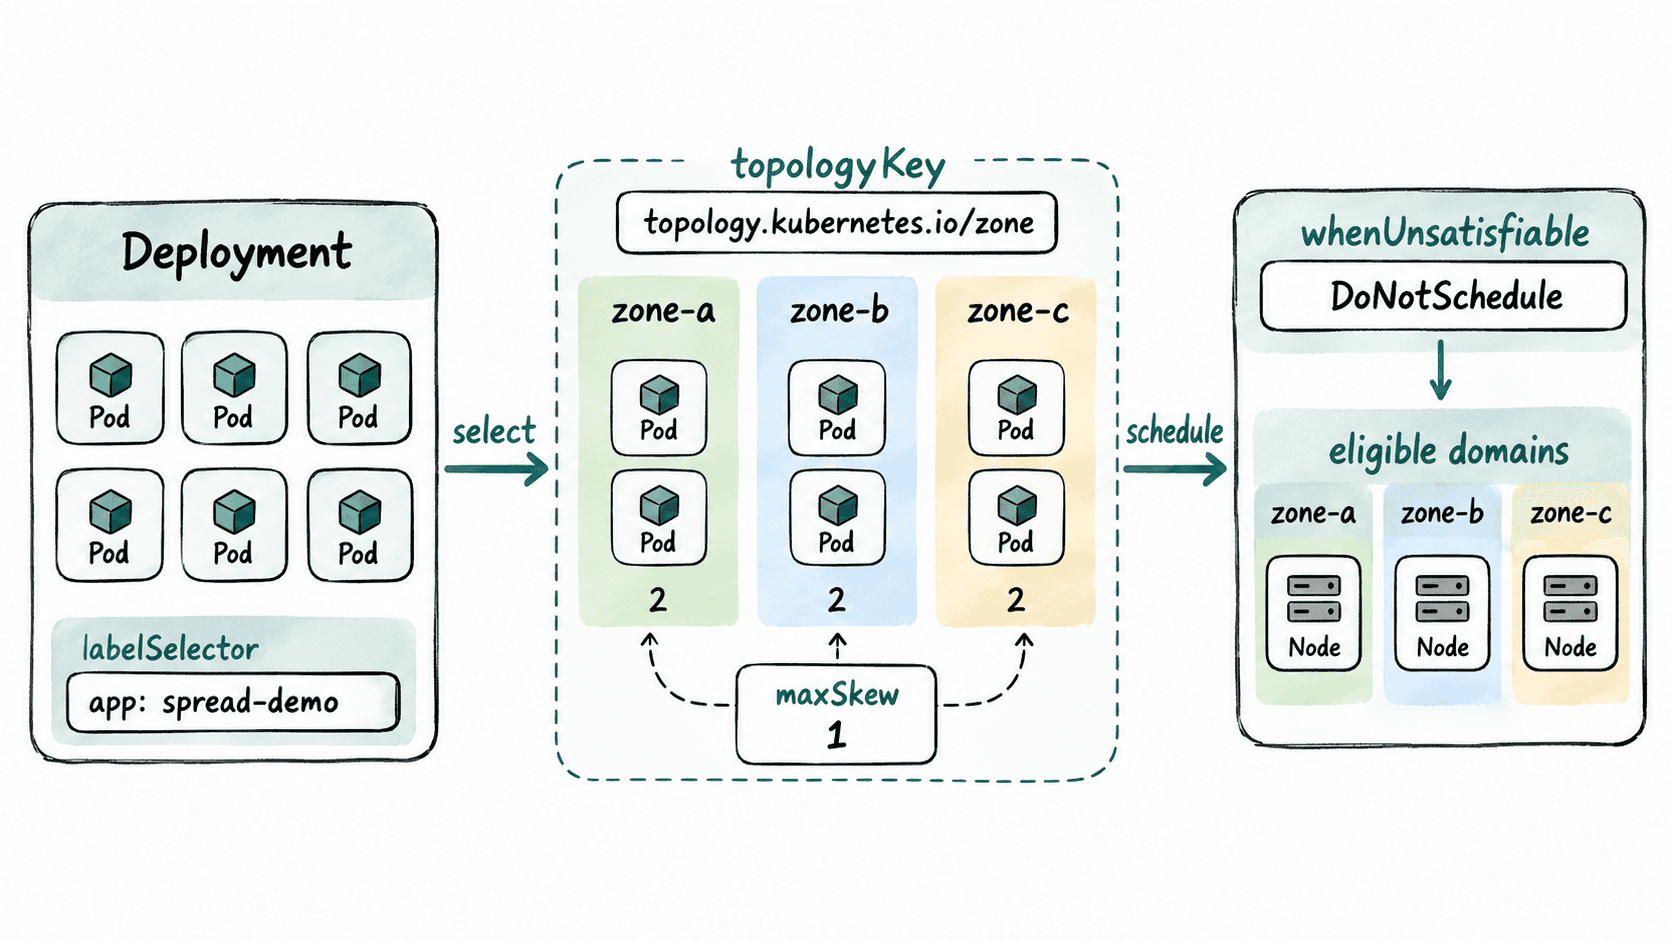
理解 eligible domains 与默认行为
eligible domains 与“当前还能真正落 Pod 的节点集合”不是同一个概念。拓扑分布会结合 nodeAffinityPolicy、nodeTaintsPolicy 等规则确定可参与计算的域;之后节点是否被 cordon、资源是否充足,以及其他硬性调度条件,还会继续缩小可行节点集合。若没有任何节点既满足这些条件又满足硬性 spread 约束,Pod 会保持 Pending,而不是为了凑副本数主动破坏 maxSkew。
这个示例已经显式设置 .spec.topologySpreadConstraints,因此不要再假设调度器的集群级默认 PodTopologySpread 约束会额外叠加到它上面。只有 Pod 自己没有声明该字段时,调度配置中的默认约束才可能生效;如果在数组中显式写了多条 spread 约束,则这些约束需要同时满足。
在三个 zone 都可参与计算、每个 zone 都有可调度且资源充足的节点、没有其他硬约束冲突、也没有额外同标签 Pod 干扰计数的前提下,6 个副本全部成功调度后应形成 2/2/2。只要这些前提有一项不成立,就不能仅凭副本数推断最终分布;硬约束更可能让部分 Pod Pending,而不是保证得到另一个均匀比例。
应用并验证实际分布
应用配置后,先从 Pod 的 spec.nodeName 看它落在哪个节点,再从 Node 标签确认 zone。不要查询 Pod 的 metadata.labels.topology.kubernetes.io/zone 来判断可用区,因为这个拓扑标签属于 Node,并不会自动复制到 Pod。
kubectl apply -f spread-demo.yaml
kubectl rollout status deployment/spread-demo
kubectl get pods -l app=spread-demo -o wide
kubectl get nodes -L topology.kubernetes.io/zone
预期输出
deployment.apps/spread-demo created
deployment "spread-demo" successfully rolled out
NAME                           READY   STATUS    RESTARTS   AGE      IP       NODE     NOMINATED NODE   READINESS GATES
spread-demo-<ID>               1/1     Running   0          <TIME>   <IP>     node-a   <none>           <none>
spread-demo-<ID>               1/1     Running   0          <TIME>   <IP>     node-b   <none>           <none>
spread-demo-<ID>               1/1     Running   0          <TIME>   <IP>     node-c   <none>           <none>
...
NAME     STATUS   ROLES    AGE      VERSION   ZONE
node-a   Ready    <none>   <TIME>   <VALUE>   zone-a
node-b   Ready    <none>   <TIME>   <VALUE>   zone-b
node-c   Ready    <none>   <TIME>   <VALUE>   zone-c
实际 Pod 名称、IP、节点顺序和版本会不同。核对时把 kubectl get pods -o wide 的 NODE 列与 Node 的 ZONE 列对应起来,并统计全部 6 个 Pod;若 rollout status 一直等待,应优先检查 Pending Pod 的调度事件、缺失的 topologyKey、节点不可调度状态、资源不足以及其他硬性约束。
配置时最容易出错的地方
labelSelector 必须与真正要统计的 Pod 标签一致,否则调度器会统计另一组 Pod,甚至一个都统计不到。多个显式 topologySpreadConstraints 会共同限制候选节点,例如同时按 zone 和 hostname 分散时,两条硬约束的交集可能为空。
拓扑分布只影响新的调度决策,不会因为现有分布后来变差就主动搬迁正在运行的 Pod。节点、zone 或副本变化后,只有控制器重建、驱逐等动作产生新的调度机会时,这些约束才会再次参与放置决策。