
容器与云原生 / 系统课时
搭建可复现的调度实验环境
搭建可复现的调度实验环境
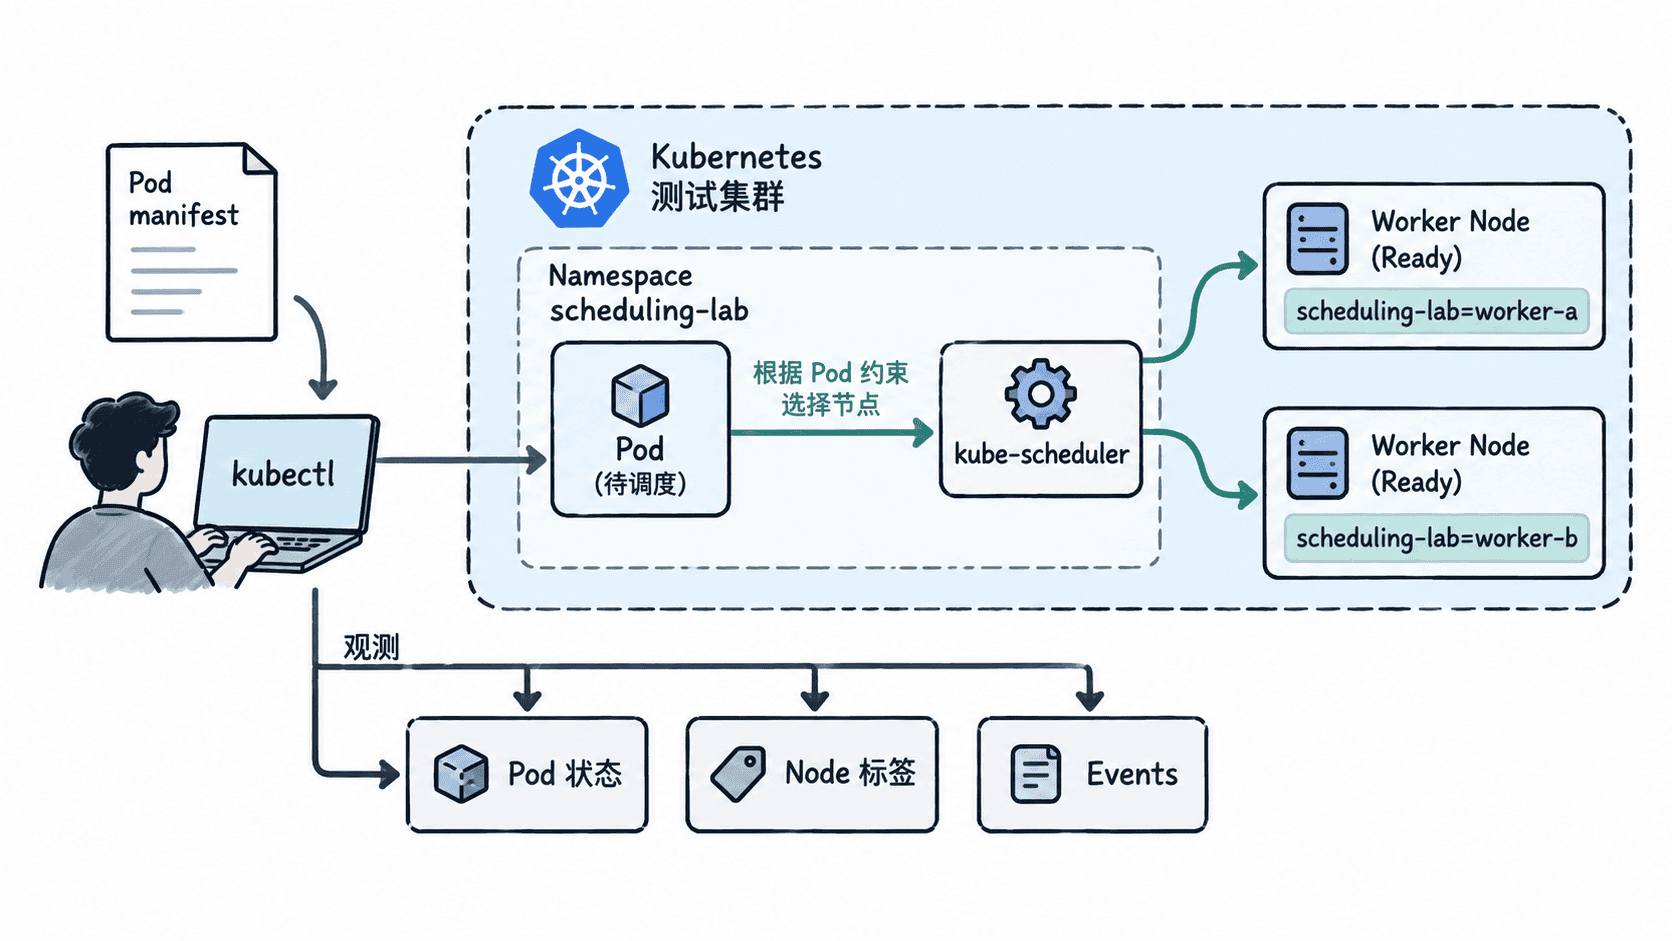
后续调度实验需要一个能够反复创建、观察和清理工作负载的多节点集群。本课建立统一实验基线:确认至少两个可调度节点,给节点添加稳定标签,创建独立 Namespace 和测试 Pod,并准备常用状态与事件命令。
学习目标
- 检查实验集群是否具备多节点调度条件
- 为节点建立可重复使用的标签并部署最小测试工作负载
- 使用统一命令观察 Pod、Node、调度结果和事件
检查集群与节点基线
实验环境应至少包含两个处于 Ready 状态且可承载测试 Pod 的节点。可以使用本地多节点 Kubernetes 集群,也可以使用专用测试集群;不要直接在生产节点修改标签、污点或资源压力来制造实验条件。
kubectl cluster-info
kubectl get nodes -o wide
kubectl get nodes -o custom-columns='NAME:.metadata.name,READY:.status.conditions[?(@.type=="Ready")].status,UNSCHEDULABLE:.spec.unschedulable'
预期输出
Kubernetes control plane is running at <URL>
NAME       READY   UNSCHEDULABLE
<NODE_A>   True    <VALUE>
<NODE_B>   True    <VALUE>
节点名称和控制面地址取决于实际环境。用于后续实验的节点应为 READY=True,并确认其 UNSCHEDULABLE 状态不会阻止普通 Pod 调度。
建立稳定的节点标签
不要依赖随机节点名编写调度实验。为两个目标节点分别添加实验标签,后续可以通过 nodeSelector 或节点亲和性精确制造“可调度”和“不可调度”场景。将 <NODE_A> 与 <NODE_B> 替换为上一步得到的真实节点名。
kubectl label node <NODE_A> scheduling-lab=worker-a --overwrite
kubectl label node <NODE_B> scheduling-lab=worker-b --overwrite
kubectl get nodes -L scheduling-lab
预期输出
NAME       STATUS   ROLES    AGE       VERSION   SCHEDULING-LAB
<NODE_A>   Ready    <VALUE>  <VALUE>   <VALUE>   worker-a
<NODE_B> Ready <VALUE> <VALUE> <VALUE> worker-bAGE、VERSION 和角色等动态值会因集群而异,关键是 SCHEDULING-LAB 列分别显示 worker-a 与 worker-b。
创建隔离的测试工作负载
使用独立 Namespace 避免实验资源与其他应用混杂。下面的 Pod 显式选择 worker-a,同时设置很小的资源请求,便于验证基础调度链路。配置文件属于完整可应用示例。
apiVersion: v1
kind: Namespace
metadata:
  name: scheduling-lab
---
apiVersion: v1
kind: Pod
metadata:
  name: baseline-pod
  namespace: scheduling-lab
spec:
  nodeSelector:
    scheduling-lab: worker-a
  containers:
    - name: app
      image: registry.k8s.io/pause:3.10
      resources:
        requests:
          cpu: 10m
          memory: 16Mi
        limits:
          cpu: 50m
          memory: 32Mi
将配置保存为 <PATH>/baseline.yaml 后执行:
kubectl apply -f <PATH>/baseline.yaml
kubectl wait --for=condition=Ready pod/baseline-pod -n scheduling-lab --timeout=60s
kubectl get pod baseline-pod -n scheduling-lab -o wide
预期输出
namespace/scheduling-lab created
pod/baseline-pod created
pod/baseline-pod condition met
NAME           READY   STATUS    RESTARTS   AGE       IP     NODE
baseline-pod   1/1     Running   0          <VALUE>   <IP>   <NODE_A>
如果 Namespace 已存在,kubectl apply 会显示 unchanged 或 configured,这也是正常结果。最终应确认 Pod 为 Running,且 NODE 对应带有 scheduling-lab=worker-a 标签的节点。
准备统一的观测命令
调度实验不要只依赖 kubectl get pod 的一行状态。describe 可以看到节点选择条件和事件,Node 查询用于确认容量、污点与标签,事件列表则帮助确定调度器为什么接受或拒绝某个 Pod。
kubectl describe pod baseline-pod -n scheduling-lab
kubectl get events -n scheduling-lab --sort-by=.lastTimestamp
kubectl get nodes --show-labels
kubectl describe node <NODE_A>
预期结果
Name:         baseline-pod
Namespace:    scheduling-lab
Node:         <NODE_A>/<IP>
Status:       Running
Events:
  Type    Reason     Message
  Normal  Scheduled  Successfully assigned scheduling-lab/baseline-pod to <NODE_A>
事件时间、IP 和附加事件会随集群实现变化。后续实验中应优先保留 Scheduled、FailedScheduling、Preempted 或节点压力相关事件作为证据,而不是只根据最终状态猜测原因。
验证环境能够制造调度失败
实验基线不仅要能成功调度,还要能安全构造失败条件。创建一个选择不存在标签值的 Pod,可以验证调度器事件是否可正常观察,而且不会给节点制造真实资源压力。
kubectl run unschedulable-pod -n scheduling-lab --image=registry.k8s.io/pause:3.10 --overrides='{"spec":{"nodeSelector":{"scheduling-lab":"missing-worker"}}}'
kubectl get pod unschedulable-pod -n scheduling-lab
kubectl describe pod unschedulable-pod -n scheduling-lab
预期输出
NAME                READY   STATUS    RESTARTS   AGE
unschedulable-pod   0/1     Pending   0          <VALUE>
Events:
  Type     Reason            Message
  Warning  FailedScheduling  0/<VALUE> nodes are available: <REASON>
出现 Pending 和 FailedScheduling 说明实验环境已经同时具备成功调度与失败观测能力。具体 <REASON> 由调度器版本和集群中其他节点条件共同决定。
完成实验后,可以删除整个 Namespace,并按需清除节点标签,避免测试条件长期残留。
kubectl delete namespace scheduling-lab
kubectl label node <NODE_A> scheduling-lab-
kubectl label node <NODE_B> scheduling-lab-
预期输出
namespace "scheduling-lab" deleted
node/<NODE_A> unlabeled
node/<NODE_B> unlabeled
至此,后续实验可以统一使用两个已知节点、固定节点标签、独立 Namespace 和同一组观测命令构造调度约束、资源不足、优先级与驱逐场景,并在每次实验后恢复到可重复的基线状态。