
容器与云原生 / 系统课时
设计升级与缩容中断预算
设计升级与缩容中断预算
节点升级和集群缩容都会主动迁移或终止 Pod。安全窗口不能只看 PDB,而要同时计算可中断副本、替代 Pod 就绪速度、Pod 终止时间和剩余节点容量。本课给出一套可执行的预算方法,用于判断一次维护能否继续推进。
学习目标
- 根据副本数与 PDB 计算一次允许中断的 Pod 数量
- 把终止宽限期、启动就绪时间和容量余量纳入维护窗口
- 在节点升级或缩容前用命令验证中断预算是否满足
从可中断副本开始计算
假设一个 Deployment 有 6 个健康副本,并设置 minAvailable: 5,在所有副本均健康时,主动驱逐最多只能同时让 1 个副本不可用。可以把当前允许的主动中断近似理解为:
如果使用 maxUnavailable,则约束直接描述允许不可用的数量或比例。PDB 针对的是受支持的主动驱逐场景,它不是副本控制器,也不会自动增加容量,更不能保证节点突然故障时始终保住指定数量的 Pod。
下面为标签 app: checkout 的工作负载设置 PDB,要求至少保留 5 个可用副本。
apiVersion: policy/v1
kind: PodDisruptionBudget
metadata:
  name: checkout-pdb
spec:
  minAvailable: 5
  selector:
    matchLabels:
      app: checkout
这是配置文件。应用后通过 kubectl get pdb 查看当前允许驱逐数量。
kubectl apply -f checkout-pdb.yaml
kubectl get pdb checkout-pdb
预期输出
poddisruptionbudget.policy/checkout-pdb created
NAME           MIN AVAILABLE   MAX UNAVAILABLE   ALLOWED DISRUPTIONS   AGE
checkout-pdb   5               N/A               1                     <TIME>
这里假设 6 个目标 Pod 均满足可用条件,因此 ALLOWED DISRUPTIONS 为 1。若已有副本未就绪,该值可能降为 0,维护就不应继续批量驱逐。
把时间预算和容量预算放在一起
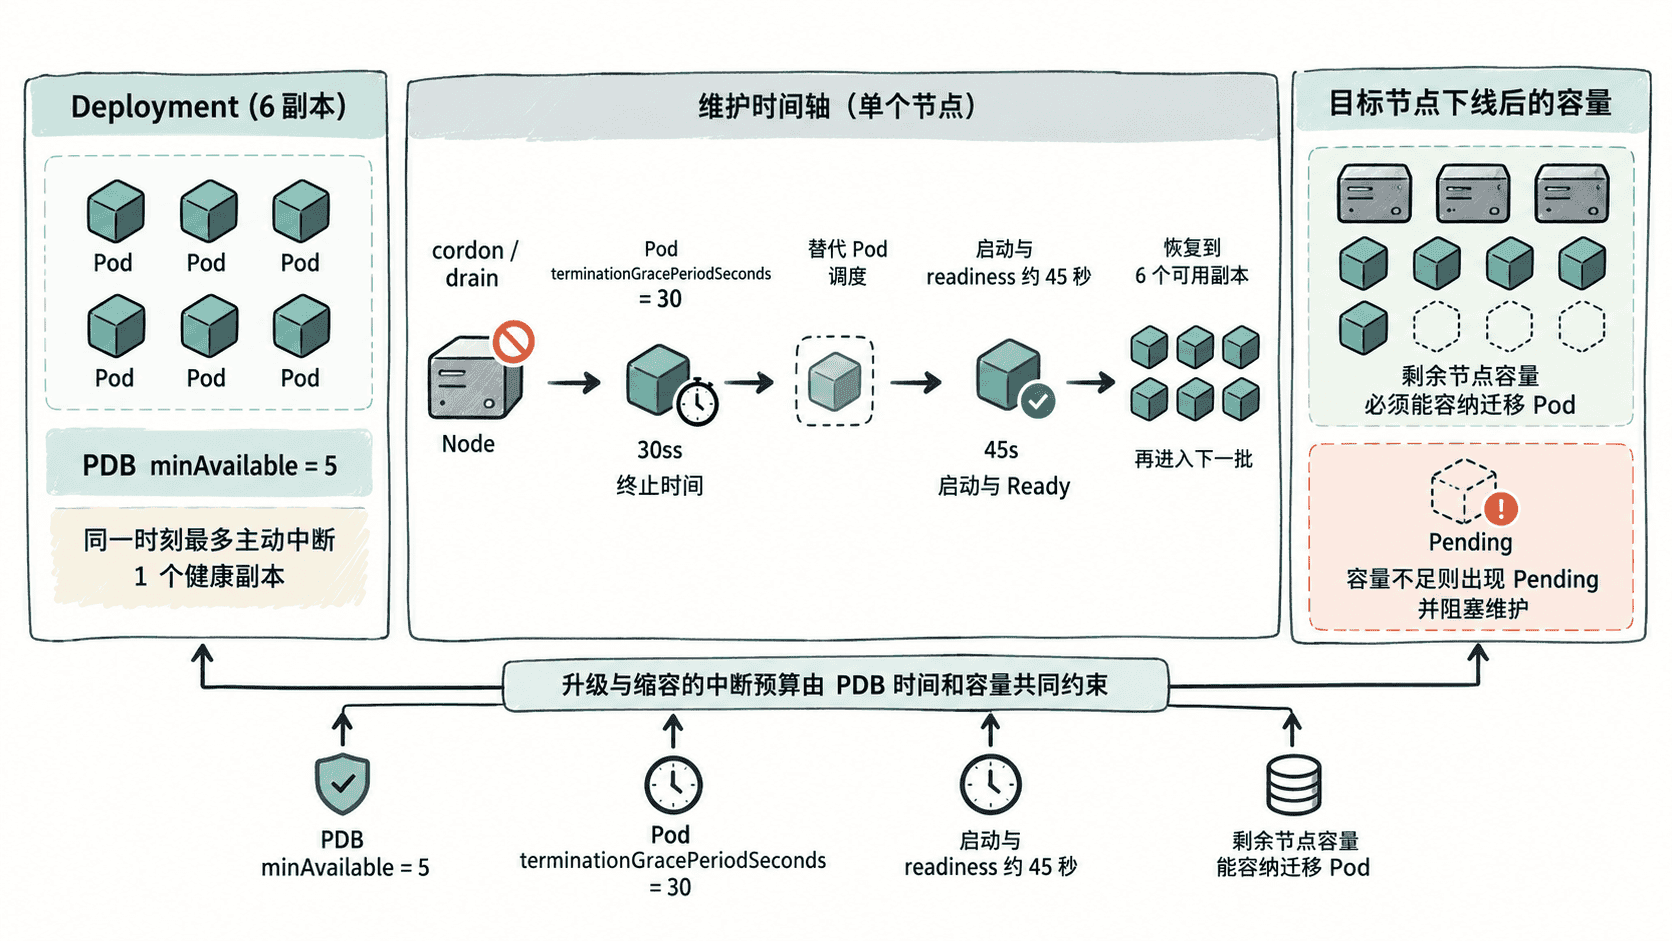
PDB 只回答“现在最多允许主动中断多少个”,并不回答替代 Pod 多久能恢复。维护节奏还要考虑 Pod 的 terminationGracePeriodSeconds、应用启动时间、就绪探针通过时间和调度等待时间。
例如单个 Pod 最长允许 30 秒优雅终止,新副本从创建到 Ready 通常需要 45 秒,那么每批节点操作后至少要等待新的可用副本补回来,再开始下一批。若新 Pod 因资源不足处于 Pending,即使 PDB 最初允许一次驱逐,维护也可能很快停住。
升级前检查实际预算
维护前先检查工作负载健康度、PDB 和节点容量,而不是直接执行 drain。以下命令可以建立最小检查面。
kubectl get deploy checkout
kubectl get pdb checkout-pdb
kubectl get pods -l app=checkout -o wide
kubectl top nodes
预期结果
NAME       READY   UP-TO-DATE   AVAILABLE   AGE
checkout   6/6     6            6           <TIME>

NAME           MIN AVAILABLE   MAX UNAVAILABLE   ALLOWED DISRUPTIONS   AGE
checkout-pdb   5               N/A               1                     <TIME>
kubectl top nodes 的具体 CPU、内存数值会因集群而异,而且它展示的是运行时使用量,不等价于调度器按 requests 计算的可调度余量。因此容量判断还应结合节点 Allocatable 与现有 Pod requests,确认目标节点上的 Pod 能在其他节点重新调度。
可以检查节点的可分配资源:
kubectl describe node <NODE>预期结果
Allocatable:
  cpu:                <VALUE>
  memory:             <VALUE>
Allocated resources:
  Resource           Requests
  cpu                <VALUE>
  memory             <VALUE>
实际字段和值取决于节点和 Kubernetes 配置。核心不是追求固定百分比,而是确认迁移后的每个 Pod 都存在满足 requests、节点亲和性、污点容忍和拓扑约束的候选节点。
节点升级按批次推进
对节点执行计划维护时,通常先禁止新的普通 Pod 调度到目标节点,再发起驱逐。下面展示最小操作链路,其中 <NODE> 必须替换为实际维护节点。
kubectl cordon <NODE>
kubectl drain <NODE> --ignore-daemonsets
预期结果
node/<NODE> cordoned
node/<NODE> drained
实际 drain 输出会列出被驱逐或跳过的 Pod。若 PDB 当前不允许更多主动中断,drain 可能持续等待或报告无法完成驱逐;这时应恢复工作负载健康度或调整维护批次,而不是把阻塞简单视为命令失败。
一批节点处理完成后,应确认替代副本重新 Ready、ALLOWED DISRUPTIONS 恢复到计划值,再推进下一批。升级完成并确认节点可重新承载工作负载后,可以解除不可调度状态。
kubectl uncordon <NODE>预期输出
node/<NODE> uncordoned缩容还要验证迁移后的稳态容量
升级通常意味着节点稍后会回来,而缩容意味着容量永久减少。因此缩容的门槛更高:不仅要证明当前能够完成一次 drain,还要证明节点删除后,集群在业务正常峰值下仍能持续承载全部 requests,并保留故障余量。
一个实用检查顺序是先确认 PDB 允许本批中断,再确认剩余节点能接住目标节点上的 Pod,然后执行 cordon 和 drain,最后观察所有替代副本恢复 Ready。只有当缩容后的资源、拓扑和故障冗余仍满足要求时,才真正删除节点或缩减节点池。
升级与缩容的安全窗口因此不是一个单独数字:PDB 决定并发中断上限,终止与启动过程决定每批需要等待多久,调度容量决定替代副本能否出现,而缩容后的余量决定操作完成后系统是否仍有容错空间。四项条件同时满足,维护窗口才真正成立。