
容器与云原生 / 系统课时
分析内存压力驱逐顺序
分析内存压力驱逐顺序
节点进入 MemoryPressure 后,判断谁更容易被驱逐不能只看 QoS。应先在当前紧缺的内存维度判断实际使用是否超过 request,再比较 Pod Priority,最后比较相对 request 的超额程度,并用节点状态、资源指标和 Pod 事件还原现场。
学习目标
- 解释 kubelet 在内存压力下选择驱逐对象的三个排序维度
- 结合 memory request、实际使用量和 Priority 判断相对驱逐风险
- 使用 kubectl 收集节点压力、Pod 配置、实时使用量和驱逐事件证据
按紧缺资源理解排序
当 memory.available 满足配置的驱逐阈值后,kubelet 会先尝试回收节点级资源;仍无法解除压力时,才开始选择 Pod 驱逐。对内存压力而言,QoSClass 不是独立排序键,判断顺序应落到当前紧缺资源,也就是内存。
排序可以按三个维度理解:
- 先判断 Pod 的内存使用量是否超过其 memory request。超过 request 的 Pod 排在未超过 request 的 Pod 之前。
- 在同一组内比较 Pod Priority。Priority 越低,越容易先被驱逐。
- Priority 相同时,再比较内存使用量相对 request 的超额程度;超额越明显,驱逐风险越高。
BestEffort 需要单独理解。它没有 memory request,基线等价于 0,因此只要正在使用正的内存,就会满足“usage 超过 request”。不要把它理解成“request 为 0,所以没有内存压力”,也不要自行用 0 作分母计算比例;它只是没有 request 基线,随后仍要继续比较 Priority 等排序条件。
Guaranteed Pod 的 memory request 与 limit 相等,正常情况下更难进入“使用超过 request”的组,但这并不等于绝不会被驱逐。当系统进程占用超过预留、节点必须继续回收资源,而前面的对象已经不足以解除压力时,kubelet 仍可能继续选择剩余 Pod。
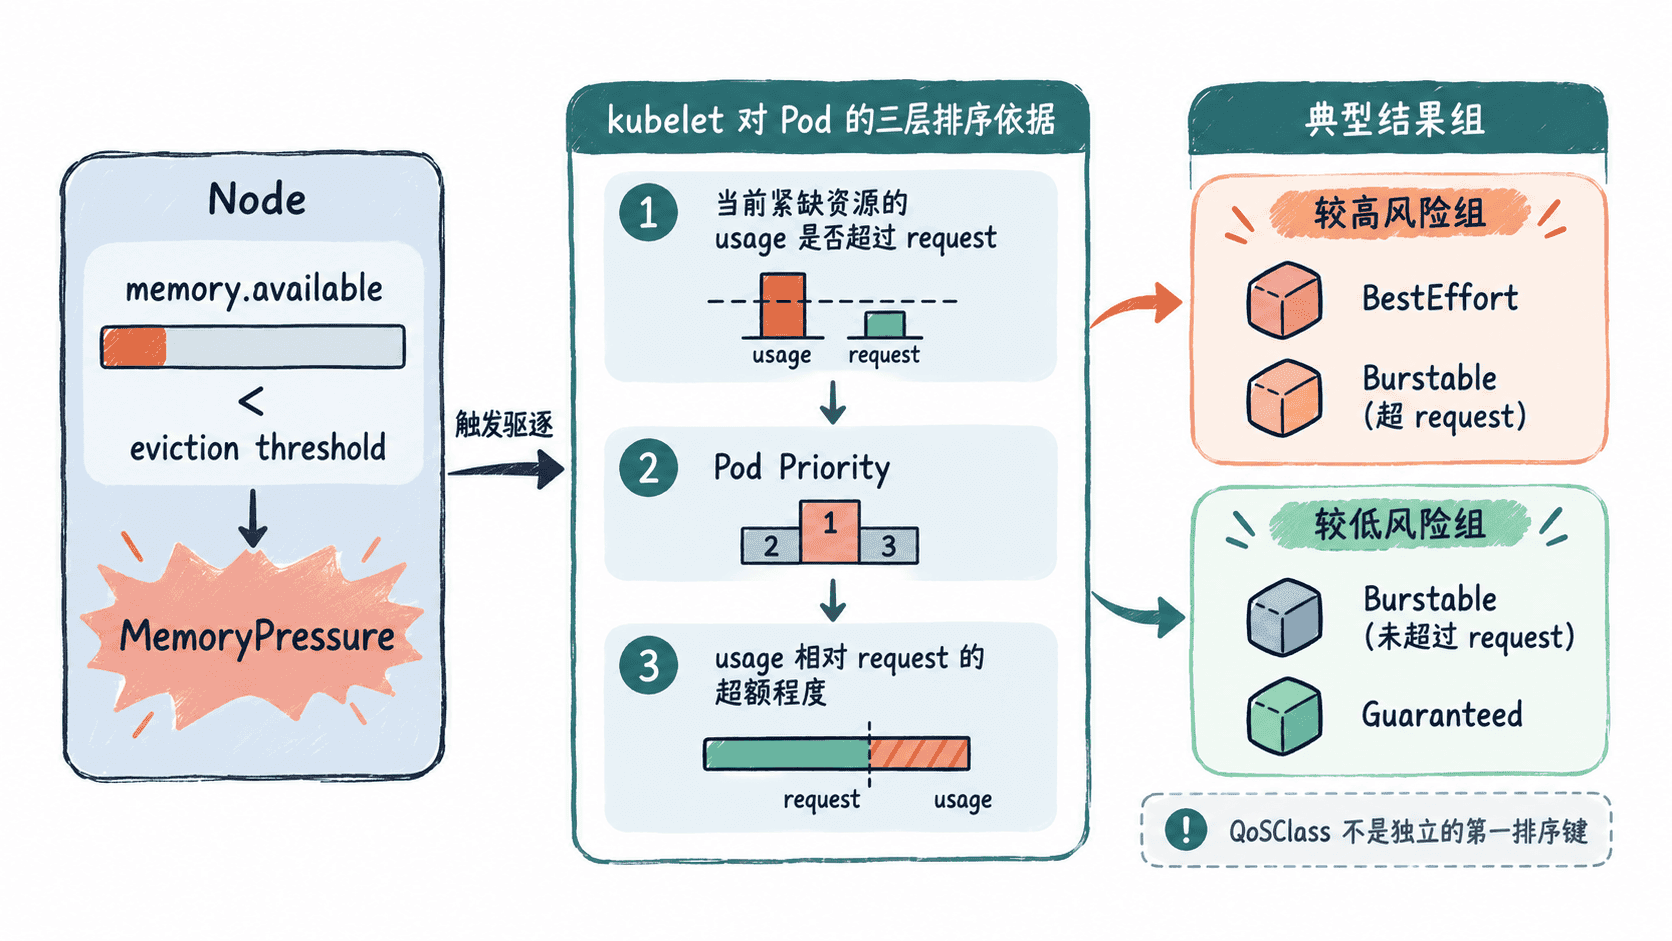
用一组 Pod 判断相对风险
假设同一节点当前紧缺资源是内存,并且故障时刻的观测值如下:
| Pod | QoS | memory request | 当前使用 | Priority |
|---|---|---|---|---|
| api-a | Burstable | 500Mi | 900Mi | 100 |
| api-b | Burstable | 500Mi | 400Mi | 0 |
| batch | BestEffort | 0 | 300Mi | 0 |
| core | Guaranteed | 700Mi | 650Mi | 1000 |
先看第一层:api-a 的 900Mi 大于 500Mi,batch 的 300Mi 大于 0,因此两者都进入“usage 超过 request”这一组;api-b 和 core 没有超过 request,只有前一组不足以解除压力时才会继续被考虑。
再看第二层:batch 的 Priority 为 0,低于 api-a 的 100,所以在这组数据保持不变时,batch 的相对驱逐顺序会早于 api-a。这也说明,不能因为 api-b 的 Priority 同样是 0,就跳过第一层直接认定它会先于 api-a 被驱逐:是否超过当前紧缺资源的 request,是 Priority 之前的判断。
第三层只在前两层仍无法区分时发挥作用。例如两个 Pod 都超过 memory request 且 Priority 相同,才继续比较它们相对 request 的超额程度。真实驱逐可能在回收足够内存后立即停止,因此“排序靠后”不代表一定会被驱逐。
收集同一时点的证据
先确认节点是否处于 MemoryPressure,再读取该节点 Pod 的 QoS、Priority 和 memory request;若 Metrics Server 可用,再补充当前内存使用量。<ID> 与 <VALUE> 是动态值,实际结果会因节点、Pod 和采样时刻不同。
NODE="<ID>"

kubectl get node "$NODE" -o custom-columns='NAME:.metadata.name,MEMORY_PRESSURE:.status.conditions[?(@.type=="MemoryPressure")].status'
kubectl get pods -A --field-selector spec.nodeName="$NODE" -o custom-columns='NAMESPACE:.metadata.namespace,NAME:.metadata.name,QOS:.status.qosClass,PRIORITY:.spec.priority,MEMORY_REQUESTS:.spec.containers[*].resources.requests.memory'
kubectl top pod -A --field-selector spec.nodeName="$NODE"
预期输出示例:
NAME    MEMORY_PRESSURE
<ID>    True

NAMESPACE   NAME    QOS          PRIORITY   MEMORY_REQUESTS
default     api-a   Burstable    100        500Mi
default     batch   BestEffort   0          <none>

NAMESPACE   NAME    CPU(cores)   MEMORY(bytes)
default     api-a   <VALUE>      <VALUE>
default     batch   <VALUE>      <VALUE>
MEMORY_REQUESTS 展示的是各容器声明值;多容器 Pod 分析时应按 Pod 的有效 memory request 口径汇总后再与 Pod 使用量比较。kubectl top 只提供当前采样,不代表压力发生瞬间的精确历史,所以复盘线上故障时还应结合监控曲线和事件时间。
从 Pod 状态确认是否发生驱逐
节点压力驱逐与容器级 OOM 不是同一件事。前者是 kubelet 为恢复节点资源主动终止 Pod;后者是内存耗尽过快时由 Linux OOM killer 先杀死容器。定位具体 Pod 后,先检查 Pod 状态,再查看描述信息和事件。
POD="<ID>"
NAMESPACE="<ID>"

kubectl get pod "$POD" -n "$NAMESPACE" -o custom-columns='NAME:.metadata.name,PHASE:.status.phase,REASON:.status.reason'
kubectl describe pod "$POD" -n "$NAMESPACE"
预期结果:
NAME   PHASE    REASON
<ID>   Failed   Evicted

Name:       <ID>
Namespace:  <ID>
Status:     Failed
Reason:     Evicted
Message:    <MESSAGE>
Events:
<TIME> <EVENT> <MESSAGE><TIME>、<EVENT> 和 <MESSAGE> 会随 Kubernetes 版本、触发信号与现场状态变化,不要依赖某个固定事件字符串。若容器终止原因显示 OOMKilled,则应沿容器 OOM 路径分析,而不是把它直接归类为 kubelet 的 Pod eviction。
降低被驱逐风险
最有效的改进不是单纯追求 Guaranteed,而是让 memory request 接近工作负载正常且可持续的占用,并为关键工作负载设置合理 Priority。request 长期偏低既会让调度低估资源需求,也更容易使 Pod 在内存压力时进入“usage 超过 request”的优先比较组。
同时应为 kubelet、容器运行时和系统守护进程预留合理内存,并持续观察峰值与趋势。Guaranteed 和高 Priority 都只是降低相对风险;当节点为了维持自身稳定必须继续释放资源时,剩余 Pod 仍可能被驱逐。