
容器与云原生 / 系统课时
理解 Pod 资源请求聚合
理解 Pod 资源请求聚合
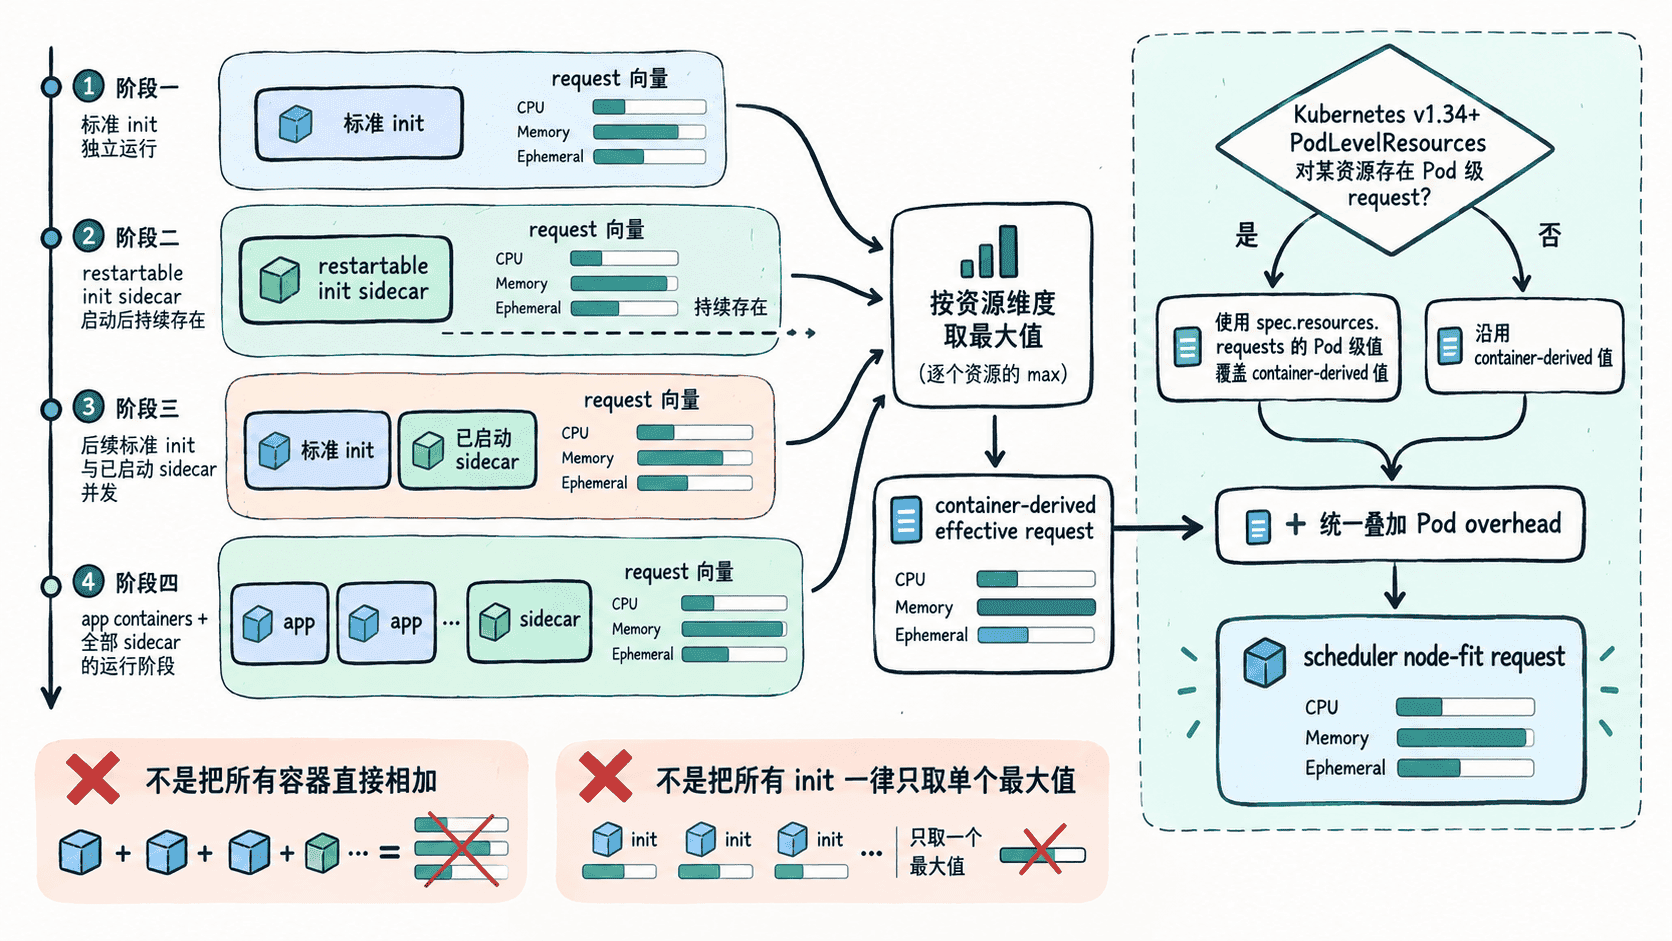
调度器判断 Pod 能否放进节点时,要先按容器生命周期计算并发峰值,再决定 Pod 级资源是否覆盖这个结果,最后计入 Pod overhead。把这三层规则分开,就能正确解释含 init、原生 sidecar 和 Pod-level Resources 的现代调度请求。
学习目标
- 按执行顺序计算普通容器、标准 init 与 restartable init sidecar 的资源峰值
- 理解 Kubernetes v1.34+ 中 Pod 级 request 对调度请求的覆盖关系
- 用
kubectl从资源声明和调度事件定位请求过大的来源
先按生命周期计算容器级请求
资源聚合要对 CPU、内存等每一种资源分别计算。普通应用容器会并行运行;initContainers 中设置 restartPolicy: Always 的 restartable init container 是 Kubernetes 原生 sidecar,启动后会继续存活,因此既影响后续 init 阶段,也会与应用容器同时占用资源。
没有 Pod 级 request 覆盖当前资源时,可以按下面的顺序得到容器级有效 request:
- 按
initContainers的声明顺序扫描,并维护“已经启动且会持续运行的 sidecar request 之和”。 - 遇到标准 init 时,本阶段 request = 已启动 sidecar 之和 + 当前 init request。
- 遇到 restartable init sidecar 时,先把它加入 sidecar 累计值;此时阶段 request 就是更新后的 sidecar 累计值。
- 所有应用容器开始后,运行阶段 request = 应用容器 request 之和 + 全部 sidecar request 之和。
- 对同一种资源,在所有 init 阶段和运行阶段之间取最大值,得到容器级有效 request;如果 RuntimeClass 为 Pod 引入 overhead,再把对应 overhead 加上。
这个规则比 max(sum(app), max(init)) 更完整:后者只适用于没有 restartable init sidecar 的传统情形。只要 sidecar 出现在某个标准 init 之前,后续 init 的峰值就必须把已经运行的 sidecar 一并算进去。
用一个 Pod 走完整计算
下面的主示例同时包含标准 init、原生 sidecar 和两个应用容器。bootstrap 先独立运行;log-agent 启动后持续存在;随后 warm-cache 与 log-agent 同时运行,最后两个应用容器与 log-agent 一起进入长期运行阶段。
apiVersion: v1
kind: Pod
metadata:
  name: request-aggregation-demo
spec:
  initContainers:
    - name: bootstrap
      image: busybox:1.36.1
      command: ["sh", "-c", "echo bootstrap"]
      resources:
        requests:
          cpu: "700m"
          memory: "128Mi"
    - name: log-agent
      image: busybox:1.36.1
      restartPolicy: Always
      command: ["sh", "-c", "while true; do sleep 3600; done"]
      resources:
        requests:
          cpu: "100m"
          memory: "128Mi"
    - name: warm-cache
      image: busybox:1.36.1
      command: ["sh", "-c", "echo warm"]
      resources:
        requests:
          cpu: "500m"
          memory: "512Mi"
  containers:
    - name: app
      image: registry.k8s.io/pause:3.10
      resources:
        requests:
          cpu: "300m"
          memory: "256Mi"
    - name: metrics
      image: registry.k8s.io/pause:3.10
      resources:
        requests:
          cpu: "200m"
          memory: "128Mi"
预期结果
bootstrap 阶段:cpu 700m,memory 128Mi
log-agent 启动阶段:cpu 100m,memory 128Mi
warm-cache 阶段:cpu 600m,memory 640Mi
长期运行阶段:cpu 600m,memory 512Mi
容器级有效 request:cpu 700m,memory 640Mi
CPU 峰值来自 bootstrap,内存峰值来自 log-agent + warm-cache。这也说明不同资源的最大值可以来自不同阶段,不能挑某一个“最重容器”同时代表所有资源。
先用服务端 dry-run 检查对象是否通过当前集群 API 校验;它验证清单合法性,不代表节点一定有足够资源。
kubectl apply --dry-run=server -f request-aggregation-demo.yaml预期输出
pod/request-aggregation-demo created (server dry run)如果 Kubernetes 版本、准入策略、镜像策略或文件路径不同,实际错误信息可能不同。
再应用 Pod 级资源覆盖
Kubernetes v1.34 中 PodLevelResources 为 Beta 且默认启用。启用后,CPU、内存和 hugepages 可以直接在 spec.resources 声明 Pod 级 request/limit。调度计算应理解为“先得到容器生命周期聚合值,再按资源维度应用 Pod 级 request 覆盖,最后加 overhead”,而不是继续把传统 init 公式当成最终答案。
对某一种资源,如果 API 接收并默认化后的 spec.resources.requests 中存在 Pod 级值,调度器使用这个 Pod 级 request 作为该资源的节点放置基准;容器级聚合值不再用于该资源的 node fit。没有 Pod 级 request 的资源仍按容器级规则计算。Pod overhead 独立于这两种模型,最终仍需额外计入。
在上面的 Pod 中,如果增加下面这个片段,CPU 和内存的调度基准就分别变为 1 和 768Mi,而不是前面算出的 700m 和 640Mi;若 RuntimeClass 还产生 overhead,再在此基础上相加。
spec:
  resources:
    requests:
      cpu: "1"
      memory: "768Mi"
生效行为
CPU 调度基准:1 core + Pod CPU overhead
内存调度基准:768Mi + Pod memory overhead
这是片段示例,需要合并到完整 Pod 清单中,并要求集群启用 PodLevelResources。同时声明 Pod 级与容器级资源时,API 还会校验两者是否自洽;不要把 Pod 级 request 设计成任意小于容器生命周期有效 request 的值来规避调度预算。
从 Pending 反查请求来源
Pod 因资源不足而 Pending 时,先看调度事件,不要先用 kubectl top 判断“节点还有没有空闲”。调度器做 node fit 时比较的是 request 与节点可分配资源;瞬时使用量低,并不会抵消已经声明的 request。
kubectl describe pod request-aggregation-demo若失败原因确实是 CPU 或内存 request 不足,预期事件形态类似:
Events:
  Warning  FailedScheduling  <TIME>  default-scheduler  0/<VALUE> nodes are available: <VALUE> Insufficient cpu, <VALUE> Insufficient memory.
<TIME> 和 <VALUE> 会随集群变化。定位时先确认是否存在 Pod 级 request;若存在,优先检查它和 Pod overhead;若不存在,再按 init 顺序重建 sidecar 累计、各 init 阶段与长期运行阶段的峰值。这样得到的才是现代 Kubernetes 调度器实际需要满足的资源预算。