
容器与云原生 / 系统课时
处理扩展资源与设备调度
处理扩展资源与设备调度
GPU、FPGA、高性能网卡等设备要参与 Kubernetes 调度,必须先被节点以扩展资源形式发布,Pod 再按资源名声明需求。本篇用一个 GPU 调度占位实验串起“设备插件发布资源 → 调度器筛选节点 → kubelet 分配设备”的链路,并明确区分调度成功与业务程序真正可用。
学习目标
- 识别节点
capacity与allocatable中的扩展资源 - 正确声明 GPU 等扩展资源,理解整数计数和不可超卖约束
- 根据
FailedScheduling事件判断资源未发布、数量不足或其他节点约束问题
扩展资源如何进入调度
以常见的 nvidia.com/gpu 为例,设备插件先向 kubelet 注册并持续报告健康设备,kubelet 再把资源数量写入 Node 状态。调度器看到的不是 GPU 利用率,而是扩展资源的整数配额:它会用节点 allocatable 减去已绑定 Pod 的资源请求,判断剩余配额是否能满足新 Pod。
具体哪一块设备交给容器,不由 Pod 自己选择。Pod 只声明资源名和数量;Pod 被调度到节点后,kubelet 的设备管理逻辑会在分配阶段与设备插件协作,把选中的设备信息交给容器运行时。
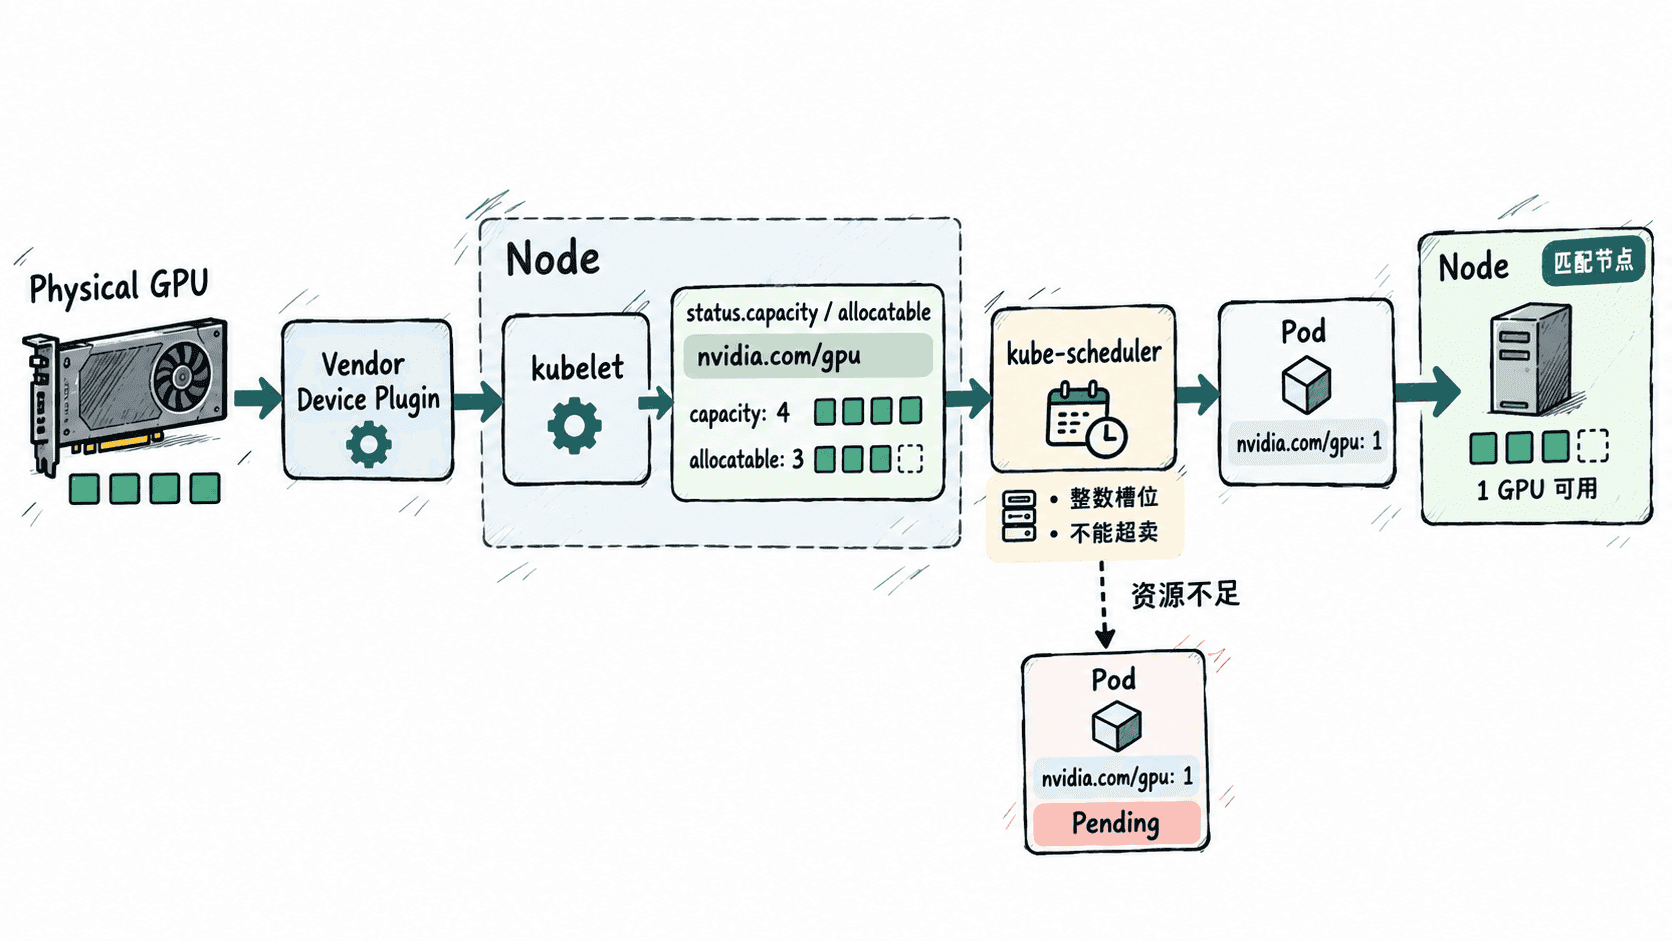
先确认节点是否已经发布 GPU 资源:
kubectl get nodes -o custom-columns='NODE:.metadata.name,GPU_CAPACITY:.status.capacity.nvidia\.com/gpu,GPU_ALLOCATABLE:.status.allocatable.nvidia\.com/gpu'预期输出:
NODE     GPU_CAPACITY   GPU_ALLOCATABLE
<NODE>   <VALUE>        <VALUE>
<NODE> 与 <VALUE> 取决于实际集群。若所有节点都没有 nvidia.com/gpu,应优先检查设备插件、驱动和设备发现链路,而不是先调整 Pod 亲和性或重启调度器。
用 Pod 声明并验证调度
扩展资源可以写在容器的 resources.limits 中。若同时设置 requests 与 limits,两者必须相等;只写 limits 时,Kubernetes 会按相同数量参与调度。扩展资源使用整数数量,下面的示例请求 1 个 GPU。
这只是调度占位实验。registry.k8s.io/pause:3.10 不包含 GPU 计算程序,因此即使 Pod 成功调度,也只能证明扩展资源请求被调度和分配链路接受,不能证明 CUDA、驱动用户态库或业务程序已经可以正常使用 GPU。
apiVersion: v1
kind: Pod
metadata:
  name: gpu-scheduling-demo
spec:
  restartPolicy: Never
  containers:
    - name: workload
      image: registry.k8s.io/pause:3.10
      resources:
        limits:
          nvidia.com/gpu: 1
应用清单并查看调度结果:
kubectl apply -f gpu-scheduling-demo.yaml
kubectl get pod gpu-scheduling-demo -o wide
预期结果是在 GPU 配额充足且其他调度条件同时满足时,Pod 被绑定到某个节点:
NAME                  READY   STATUS    RESTARTS   AGE      IP     NODE
gpu-scheduling-demo 1/1 Running 0 <TIME> <IP> <NODE><TIME>、<IP> 与 <NODE> 都是动态值。若要验证设备真正可用,应改用设备厂商或运行时提供的 GPU 测试工作负载,并在容器内执行相应的设备检测或计算命令;不要把 pause 容器的 Running 状态当成 GPU 能力验证。
扩展资源为什么不能像 CPU 一样超卖
传统扩展资源按整数单位记账,不能把 1 个 GPU 直接请求成 0.5,也不会因为当前利用率较低就把同一个资源槽位再次分给普通 Pod。节点若发布 4 个 GPU,已绑定 Pod 的请求合计为 3,新 Pod 最多还能按常规扩展资源模型请求 1 个。
这与 CPU request 不同:CPU 可以使用 500m 这样的分数单位,而传统扩展资源的调度依据是离散配额,不是实时利用率。
Pending 时按资源链路定位
Pod 因扩展资源无法调度时,先看 Pod 事件,再确认节点是否发布该资源,最后检查节点上已绑定 Pod 的资源请求和其他调度约束。
kubectl describe pod gpu-scheduling-demo预期结果可能在 Events 中出现资源不足信息:
Warning FailedScheduling <TIME> default-scheduler 0/<VALUE> nodes are available: <VALUE> Insufficient nvidia.com/gpu.如果事件指向 GPU 不足,再查看目标节点的资源视图:
kubectl describe node <NODE>预期结果可以在 Capacity 与 Allocatable 中看到扩展资源,例如:
Capacity:
  nvidia.com/gpu:     <VALUE>
Allocatable:
  nvidia.com/gpu:     <VALUE>
Allocatable 是节点可供 Pod 调度的总配额,不会随着每次调度直接改写成“剩余数量”;调度器会另外累计已绑定 Pod 的 request 来计算可用余量。若节点完全没有该资源名,继续排查设备插件和节点设备状态;若资源已发布但仍提示不足,则检查现有 Pod 占用、节点污点、亲和性、节点选择器等条件。GPU 数量满足只是成功调度的必要条件,业务程序能否真正使用设备还需要独立验证。