
容器与云原生 / 系统课时
理解 requests 与调度决策
理解 requests 与调度决策
Pod 能否进入某个节点,核心不是看节点此刻“用了多少”,而是看调度器为该 Pod 计算出的资源请求,加入节点已有请求后是否仍落在可分配容量内。本课只聚焦这一步资源可行性判断,并用一个最小 Pod 验证它如何影响调度结果。
学习目标
- 说明
requests在调度阶段代表什么 - 用“已有请求 + 新 Pod 请求 ≤ 节点可分配量”判断节点是否通过资源过滤
- 区分
requests、limits与实时使用量在调度中的作用边界
requests 如何参与节点过滤
对普通应用容器,调度器会按 CPU、内存等资源维度汇总 Pod 的请求,再与候选节点的可分配资源和已调度 Pod 的请求进行比较。每一种参与调度的资源都必须分别满足容量条件;某一项不足,该节点就不能通过这一轮资源过滤。
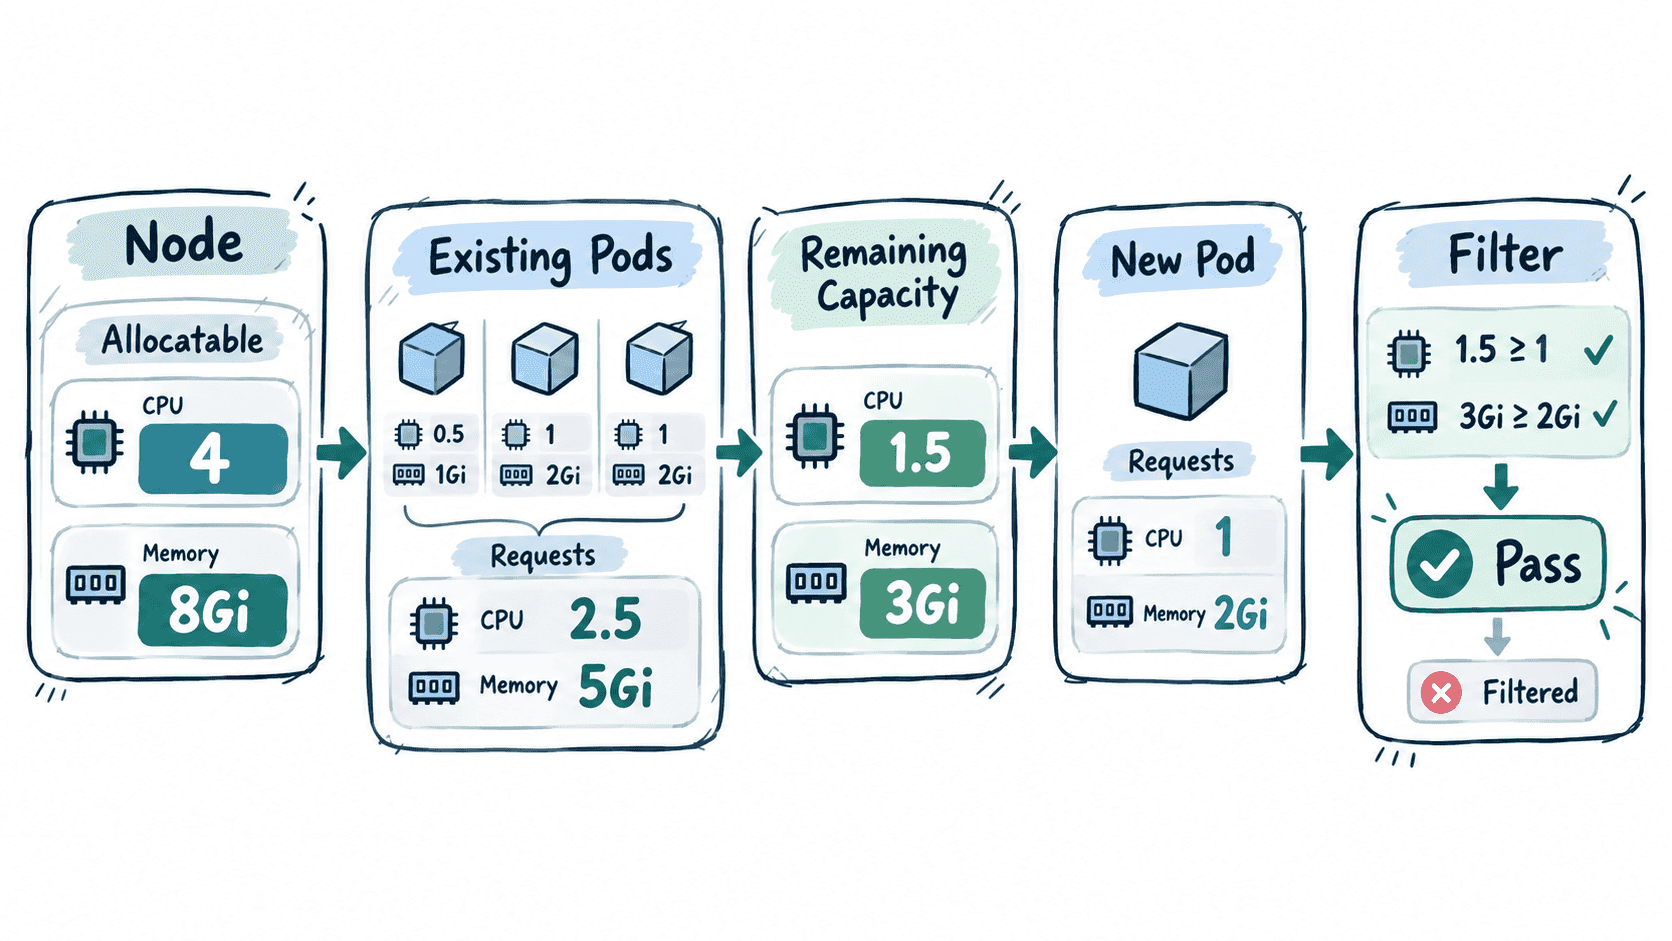
可以把单个资源维度的判断理解为:节点上已有 Pod 的该资源请求总和,加上新 Pod 的请求,不得超过节点对 Pod 可分配的该资源量。这里比较的是调度账本中的请求值,而不是监控系统看到的瞬时使用量。
多容器 Pod 中,普通容器的 CPU、内存请求会按资源维度相加;初始化容器等场景还有额外的有效请求计算规则,因此排查复杂 Pod 时应查看最终对象,而不要只盯着某一个容器。
用最小 Pod 验证请求值
下面的 Pod 请求 500m CPU 和 256Mi 内存,同时设置更高的运行上限。将它保存为 request-demo.yaml:
apiVersion: v1
kind: Pod
metadata:
  name: request-demo
spec:
  containers:
    - name: app
      image: nginx:1.27
      resources:
        requests:
          cpu: "500m"
          memory: "256Mi"
        limits:
          cpu: "1"
          memory: "512Mi"
500m 表示 0.5 个 CPU,256Mi 表示 256 MiB。创建 Pod,并查看调度到的节点:
kubectl apply -f request-demo.yaml
kubectl get pod request-demo -o wide
预期结果
pod/request-demo created
NAME           READY   STATUS    RESTARTS   AGE      IP     NODE     NOMINATED NODE   READINESS GATES
request-demo   1/1     Running   0          <TIME>   <IP>   <NODE>   <none>           <none>
在候选节点资源足够且没有其他调度约束阻止时,Pod 会被绑定到某个节点;<TIME>、<IP> 和 <NODE> 的实际值会因集群而异。这个结果只能说明 Pod 最终找到了可行节点,并不意味着所有节点都能容纳它。
多种资源必须各自满足
CPU 与内存不能互相抵消。假设某节点还能容纳 2 个 CPU,但只剩 512Mi 的可请求内存,那么请求 500m CPU 和 1Gi 内存的 Pod 仍会因为内存这一维不足而被过滤。
扩展资源同样独立判断。例如设备插件暴露 example.com/gpu 后,Pod 对该资源的请求必须由候选节点实际拥有的可分配设备数量满足。扩展资源通常按整数数量申请,不能用充足的 CPU 或内存去弥补 GPU 不足。
requests、limits 与使用量的边界
调度器做资源可行性判断时看的是请求值。limits 主要约束运行阶段的资源上限;但如果只为 CPU 或内存设置 limit 而省略 request,Kubernetes 可能在准入后把对应 request 补成相同值,因此排查时应以最终 Pod 规范为准,而不是根据原始 YAML 猜测。
requests 设得过大,会让更多节点提前被判定为资源不足;设得过小,则可能让过多工作负载同时进入节点,运行阶段更容易出现竞争。合理值应尽量接近业务在正常负载下需要被保证的资源水平,而不是为了“更容易调度”刻意压低。
当 Pod 因资源不足保持 Pending 时,事件中常会出现 FailedScheduling 与 Insufficient cpu、Insufficient memory 或某个扩展资源不足的提示。此时先确认是哪一种 request 没有通过容量条件,再继续检查亲和性、污点等其他调度约束。
理解 requests 的关键是把它视为调度器的容量承诺:对每一种资源,新 Pod 的有效请求都必须落在候选节点剩余的可请求容量之内。