
容器与云原生 / 系统课时
建立调度容量监控指标
建立调度容量监控指标
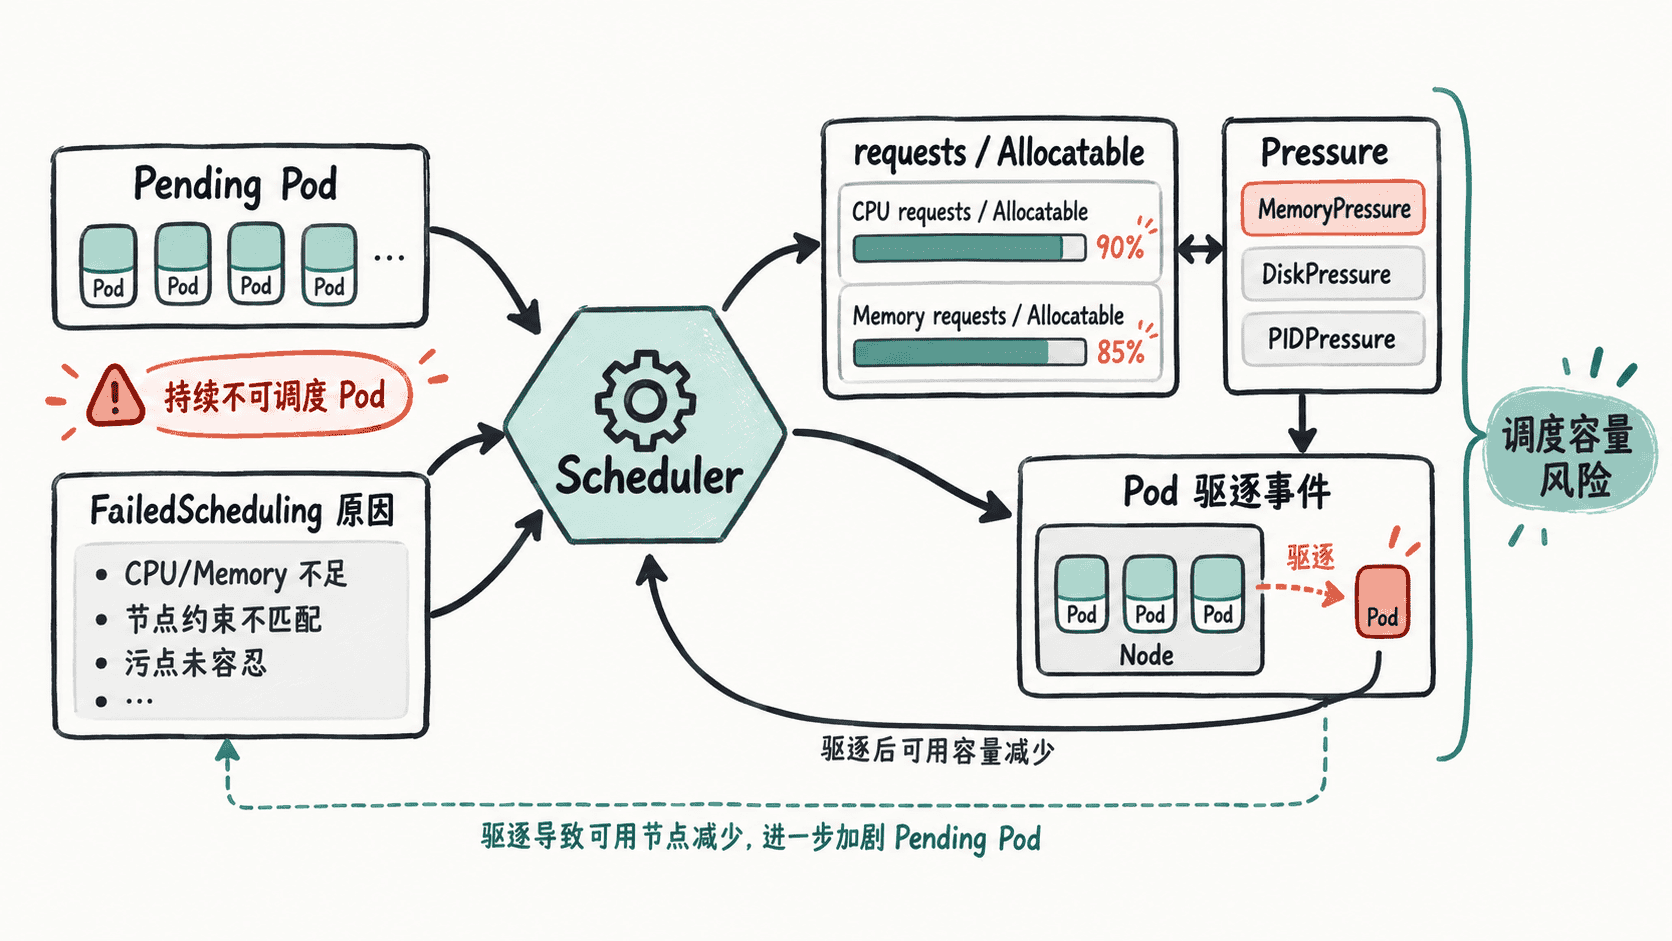
调度故障不能只盯 CPU 使用率。要提前发现容量与放置风险,需要同时观察持续不可调度的 Pod、调度失败原因、节点已请求资源、节点压力状态和驱逐信号,并把它们组合成可告警、可定位的容量视图。
学习目标
- 建立覆盖调度失败、容量余量和节点压力的核心指标集合
- 使用 Kubernetes 状态、事件和 Prometheus 指标区分 Pending 根因
- 设计不会被瞬时抖动轻易触发的调度容量告警
从 Pending Pod 判断调度是否开始失速
Pending 本身不是故障:PVC 未绑定、调度门控等情况都可能让 Pod 暂时处于 Pending。容量监控真正关心的是持续未能完成调度的 Pod,因此要把 phase、调度条件、不可调度状态和持续时间分开观察。
先用 Kubernetes API 查看当前 Pending Pod,再读取 FailedScheduling 事件确认 Scheduler 给出的原因:
kubectl get pods -A --field-selector=status.phase=Pending -o custom-columns='NAMESPACE:.metadata.namespace,NAME:.metadata.name,PHASE:.status.phase,NODE:.spec.nodeName'
kubectl get events -A --field-selector=reason=FailedScheduling --sort-by=.lastTimestamp
预期输出
NAMESPACE   NAME            PHASE     NODE
shop        checkout-<ID>   Pending   <none>

NAMESPACE   LAST SEEN   TYPE      REASON             OBJECT              MESSAGE
shop <TIME> Warning FailedScheduling pod/checkout-<ID> 0/3 nodes are available: <VALUE>实际列宽、时间和值会随集群变化。MESSAGE 可能包含资源不足、污点未容忍、亲和规则不满足或拓扑约束无法满足等信息;事件适合解释原因,但会过期,不应单独承担长期趋势统计。
接入 kube-state-metrics 后,可用 kube_pod_status_unschedulable == 1 直接筛出当前处于不可调度状态的 Pod;kube_pod_status_phase{phase="Pending"} 只作为补充,因为 Pending 还包含尚未进入可调度状态的其他情形。告警持续时间应放在 Prometheus 规则的 for 中,而不是把瞬时的一个 Pending 总数直接视为容量故障。
观察节点请求量而不是只看实际利用率
Scheduler 判断节点能否接纳新 Pod 时,核心依据是资源 requests 与节点 Allocatable,而不是节点此刻的 CPU 使用率。即使 CPU 实际利用率只有 30%,只要已调度工作负载的 requests 接近 Allocatable,新 Pod 仍可能因为 Insufficient cpu 保持不可调度。
如果 Prometheus 已抓取 kube-scheduler 的 /metrics/resources,容量规划优先使用 kube_pod_resource_request。该指标按 Scheduler 理解的 Pod 有效资源请求计算,比简单相加容器 requests 更贴近实际调度口径。节点 CPU 请求比例可写为:
sum by (node) (
  kube_pod_resource_request{resource="cpu",unit="core",node!=""}
)
/
sum by (node) (
  kube_node_status_allocatable{resource="cpu",unit="core"}
)
预期结果
{node="node-a"} 0.72
{node="node-b"} 0.91
{node="node-c"} 0.48
0.91 表示该节点已承诺的 CPU requests 约占 Allocatable 的 91%,不是 CPU 实际利用率。Memory 可用同一公式把 resource 改为 memory、unit 改为 byte。如果暂时只能使用 kube-state-metrics 的 kube_pod_container_resource_requests,应明确它是容器级近似口径,并在升级监控时优先迁移到 Scheduler 的 Pod 级资源指标。
生产环境还应按节点池、可用区和工作负载类型聚合。只看全集群平均值,可能让空闲通用节点掩盖 GPU、专用污点或特定可用区节点池已经接近饱和。
把节点压力与驱逐作为运行期容量信号
调度成功不代表容量健康。节点出现 MemoryPressure、DiskPressure 或 PIDPressure 时,节点可能被加上相应污点,kubelet 也可能在压力持续时触发驱逐。先直接检查 Node Condition:
kubectl get nodes -o custom-columns='NAME:.metadata.name,MEMORY:.status.conditions[?(@.type=="MemoryPressure")].status,DISK:.status.conditions[?(@.type=="DiskPressure")].status,PID:.status.conditions[?(@.type=="PIDPressure")].status'预期输出
NAME     MEMORY   DISK    PID
node-a   False    False   False
node-b   True     False   False
node-c   False    False   False
Prometheus 中可分别监控 kube_node_status_condition{condition="MemoryPressure",status="true"} == 1、DiskPressure 和 PIDPressure 的同类表达式。任一压力由 0 变为 1 后,应与该节点的驱逐事件、Pod 重启和资源请求趋势一起调查,判断是单节点异常还是整个节点池的持续容量压力。
驱逐不能只看总次数。长期保留事件时,至少保留节点、Namespace、工作负载和 reason 等维度;这样才能区分偶发节点故障、磁盘耗尽与系统性资源超卖。
组合成可执行的告警
一个有用的容量告警需要同时回答“是否持续”“影响多大”和“为什么”。建议把信号分成三层:调度层看 kube_pod_status_unschedulable 与 FailedScheduling 原因;容量层看 CPU、Memory requests 相对 Allocatable 的比例;节点层看 Pressure Condition 和驱逐事件。
例如,可以对“不可调度 Pod 持续 10 分钟”设置告警,并在告警详情中附上目标节点池的 CPU、Memory 请求比例以及最近的 FailedScheduling 原因。Deployment 滚动发布造成的短暂 Pending 不应立即触发页面级告警。
当不可调度状态、资源请求比例、节点压力与驱逐事件能够在同一时间轴上关联起来时,容量监控才真正从“资源仪表盘”升级为可以解释调度失败和驱逐风险的诊断系统。