
容器与云原生 / 系统课时
排查 Pod 长期 Pending
排查 Pod 长期 Pending
Pod 长期停留在 Pending 时,关键不是立即改资源或删除重建,而是先从调度事件确定候选节点为什么被全部过滤。下面用一条证据链把问题归类到资源、节点约束、污点或存储,并在修复后确认 Pod 已真正完成节点绑定。
学习目标
- 从 Pod 状态和
FailedScheduling事件识别直接失败原因 - 根据事件内容快速定位资源、节点约束、污点或存储问题
- 修复后确认 Pod 已绑定节点,而不是只观察 Pending 状态消失
先用调度事件确定方向
Pending 只是现象。只要 Pod 尚未写入 spec.nodeName,并持续出现 FailedScheduling,问题就仍位于调度阶段。先一次性取得 Pod 状态、调度事件、资源请求、节点标签和污点,避免没有证据就逐项修改配置。
kubectl get pod web-0 -n scheduling-lab -o wide
kubectl describe pod web-0 -n scheduling-lab
kubectl get pod web-0 -n scheduling-lab -o jsonpath='{.spec.containers[*].resources.requests}'
kubectl get nodes --show-labels
kubectl describe nodes
预期输出
NAME    READY   STATUS    NODE
web-0   0/1     Pending   <none>

Events:
  Type     Reason            From               Message
  ----     ------            ----               -------
  Warning  FailedScheduling  default-scheduler  0/3 nodes are available: <VALUE>
<VALUE> 会随实际失败条件变化。重点读取 FailedScheduling 的 Message,它通常已经指出资源不足、节点亲和性或选择器不匹配、未容忍污点等直接原因。
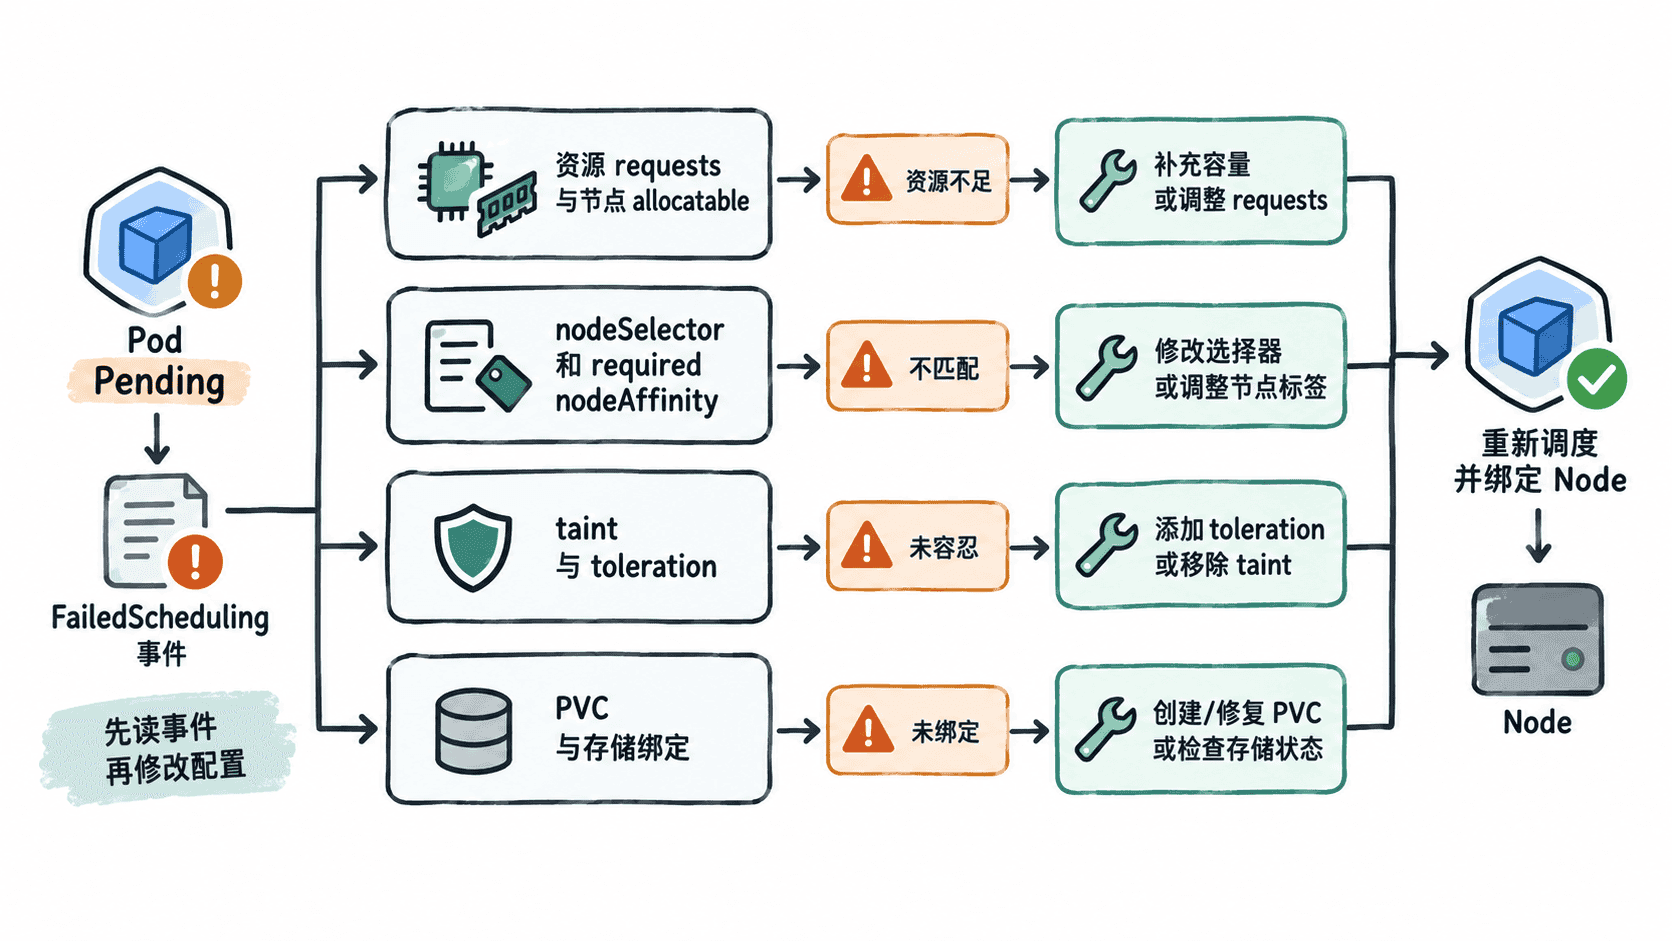
按事件原因修复过滤条件
若事件包含 Insufficient cpu 或 Insufficient memory,比较 Pod 的 requests 与节点可分配资源。调度器依据 requests 判断能否放置 Pod,因此节点当前 CPU 或内存使用率较低,并不代表剩余可调度容量足够。应修正不合理的 requests 或补充容量,而不是反复重建 Pod。
若出现 didn't match Pod's node affinity/selector,检查 nodeSelector、requiredDuringSchedulingIgnoredDuringExecution 与节点真实标签。硬性约束必须至少被一个可调度节点满足;标签写错、环境标签缺失或多个条件组合过严都会导致所有候选节点被过滤。
若出现 had untolerated taint,对照 kubectl describe nodes 中的 Taints 与 Pod 的 tolerations。不要为了恢复调度直接删除用于隔离专用节点的污点,应先确认该 Pod 是否本来就应该进入对应节点池,再决定增加 toleration、调整节点选择条件或修正节点配置。
使用 PVC 时检查存储条件
Pod 挂载 PVC 时,存储也可能参与调度。PVC 未绑定、没有匹配的 PV,或者卷的节点亲和性与 Pod 可选节点不相容,都可能让 Pod 保持 Pending。使用 WaitForFirstConsumer 的 StorageClass 时,PVC 在确定消费者节点前保持 Pending 可能属于正常流程,因此要结合事件判断。
kubectl get pvc -n scheduling-lab
kubectl describe pvc <PVC_NAME> -n scheduling-lab
kubectl get events -n scheduling-lab --sort-by=.lastTimestamp
预期输出
NAME         STATUS    VOLUME    CAPACITY    ACCESS MODES
<PVC_NAME>   <VALUE>   <VALUE>   <VALUE>     <VALUE>
如果事件明确显示无可用 PV、StorageClass 配置失败或 volume node affinity conflict,应先修复 PVC、PV、StorageClass 或卷拓扑条件。此时调整 CPU requests、taint 或普通节点标签通常不能解决根因。
修复后确认已经绑定节点
完成针对性修复后,再检查 Pod 是否获得节点,并确认没有持续新增 FailedScheduling。调度完成只代表 Pod 已越过调度阶段;后续若出现镜像拉取或容器启动错误,应转入对应生命周期阶段排查,不要继续把它当作 Pending 调度故障。
kubectl get pod web-0 -n scheduling-lab -o wide
kubectl get pod web-0 -n scheduling-lab -o jsonpath='{.spec.nodeName}{"\n"}'
kubectl get events -n scheduling-lab --field-selector involvedObject.name=web-0 --sort-by=.lastTimestamp
预期输出
NAME    READY    STATUS     NODE
web-0   <VALUE>  <VALUE>    <NODE_NAME>
<NODE_NAME>
最终验收标准是 spec.nodeName 已有值、NODE 不再为空,并且最新事件不再持续产生新的 FailedScheduling。这样才能证明导致所有候选节点被过滤的条件已经解除。