
容器与云原生 / 系统课时
区分调度失败与运行期驱逐
区分调度失败与运行期驱逐
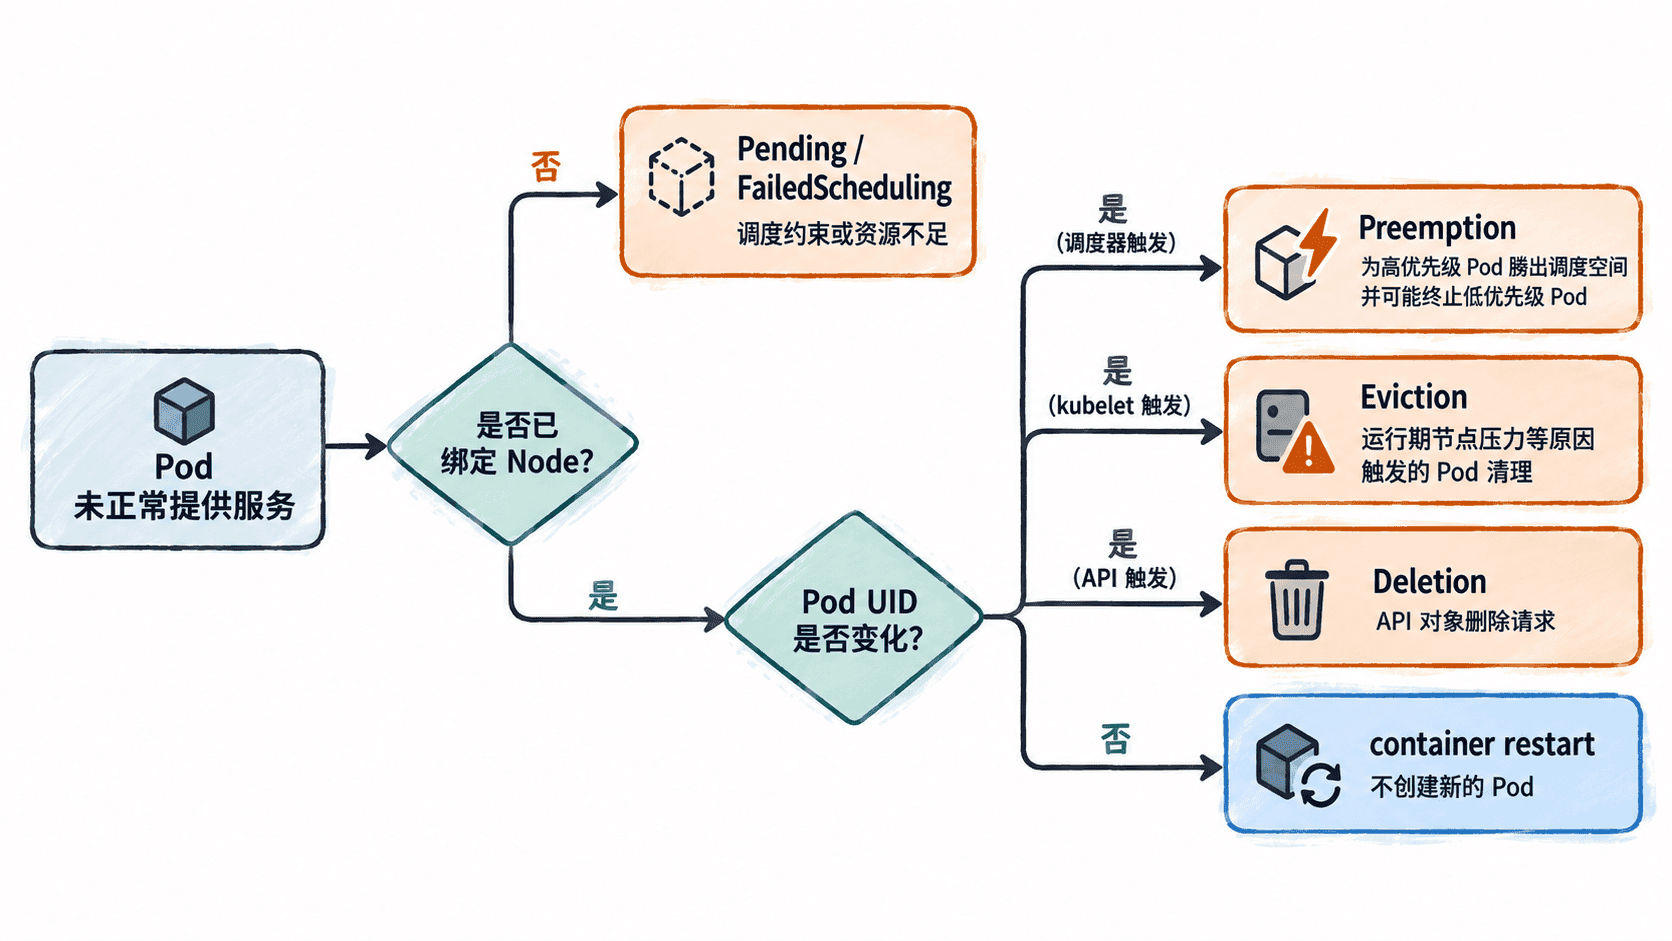
Pod 没有正常提供服务时,先判断问题发生在“绑定节点之前”还是“绑定节点之后”。本课用节点绑定、Pod 状态与事件、终止原因、UID 和容器重启次数组成证据链,区分调度失败、抢占、驱逐、删除与容器重启。
学习目标
- 根据节点绑定、Pod 状态和事件判断故障发生在调度阶段还是运行期
- 区分 Preemption、Eviction、Deletion 与容器重启的触发者和结果
- 使用可直接执行的
kubectl命令收集分类所需证据
先看是否已经绑定节点
最关键的分界线是 .spec.nodeName。尚未绑定节点的 Pod 若因资源、亲和性、污点容忍等约束无法满足,通常保持 Pending,并出现 FailedScheduling 事件。Pod 一旦已经绑定节点,后续终止、驱逐或删除就应转向运行期证据,而不能继续按普通调度失败解释。
下面用一组命令同时收集调度、运行状态、容器重启和事件信息。先把变量改成实际值,整段可以直接复制执行。
POD='your-pod-name'
NAMESPACE='default'

kubectl get pod "$POD" -n "$NAMESPACE" -o custom-columns='NAME:.metadata.name,PHASE:.status.phase,NODE:.spec.nodeName,REASON:.status.reason,UID:.metadata.uid'
kubectl get pod "$POD" -n "$NAMESPACE" -o custom-columns='PRIORITY:.spec.priorityClassName,NOMINATED_NODE:.status.nominatedNodeName,RESTARTS:.status.containerStatuses[*].restartCount,LAST_REASON:.status.containerStatuses[*].lastState.terminated.reason'
kubectl get events -n "$NAMESPACE" --field-selector "involvedObject.name=$POD" --sort-by=.lastTimestamp
预期输出
NAME    PHASE     NODE     REASON   UID
<POD>   Pending   <none>   <none>   <ID>

PRIORITY   NOMINATED_NODE   RESTARTS   LAST_REASON
<VALUE>    <none>           <none>     <none>

LAST SEEN   TYPE      REASON             OBJECT      MESSAGE
<TIME>      Warning   FailedScheduling   pod/<POD>   0/<VALUE> nodes are available: <REASON>
这里展示的是调度失败的典型形态;实际 <TIME>、<ID>、<VALUE> 和 <REASON> 会随集群变化。NODE 为空并伴随 FailedScheduling,可以把问题首先归入调度阶段。
Preemption 仍然属于调度决策
Preemption 发生在高优先级 Pod 无法直接调度时。调度器会评估是否通过移除较低优先级 Pod 来腾出可调度空间,因此它解决的是“高优先级 Pod 如何获得节点资源”,而不是节点已经出现资源压力后的运行期清理。
nominatedNodeName 可以表示调度器为待调度 Pod 提名的候选节点,但它是瞬时证据:为空不能证明没有发生过抢占,非空也不能单独证明抢占已经完成。判断 Preemption 时,应同时查看 PriorityClass、nominatedNodeName、调度事件以及相关低优先级 Pod 是否进入终止过程。
Eviction 是运行期移除
Eviction 面向已经绑定节点的 Pod。典型情况是 kubelet 检测到内存、磁盘或 PID 压力达到驱逐条件并执行 node-pressure eviction;这类被驱逐 Pod 常见状态为 Failed,reason 为 Evicted,message 会记录具体原因。
如果前面的同一组命令看到 NODE 已有值,同时 Pod 为 Failed/Evicted,就应继续检查该节点的 MemoryPressure、DiskPressure、PIDPressure 和相关事件。Kubernetes 还支持客户端通过 Eviction API 请求驱逐 Pod,因此不能把所有 Eviction 都简单等同于节点压力。
Deletion 与容器重启不在同一层级
Deletion 作用于 Pod 对象,例如用户主动删除、控制器缩容,或滚动更新淘汰旧 Pod。若 Pod 由 Deployment、StatefulSet 等控制器管理,控制器可能创建替代 Pod;新旧对象的 UID 不同。仅凭“Pod 不见了”无法判断删除来源,还要结合事件、控制器状态,必要时查看审计日志。
容器重启发生在同一个 Pod 内。Pod UID 保持不变,而对应容器的 restartCount 增加;进程退出、探针失败或容器 OOM 后,在重启策略允许时都可能出现这种现象。若 UID 不变且只有重启次数增加,应优先按容器级故障排查,而不是误判成 Pod 被驱逐或重新调度。
用证据链完成归类
实际排查按“节点绑定 → Pod phase/reason → 事件 → Priority 与提名节点 → UID 与 restartCount”的顺序即可形成稳定判断。Pending、节点为空且出现 FailedScheduling 指向调度失败;Preemption 围绕优先级和调度器决策展开;已绑定节点后出现 reason=Evicted 指向运行期驱逐;UID 改变说明 Pod 对象被替换,而 UID 不变、仅 restartCount 增加通常仍属于同一个 Pod 的容器生命周期。最终结论应由多项证据共同支持,而不是依赖单个状态字段。