
容器与云原生 / 系统课时
排查调度结果不符合预期
排查调度结果不符合预期
Pod 已经成功运行却落在“意外节点”时,问题通常不是调度失败,而是对硬性过滤、软性评分和拓扑规则的作用顺序理解有偏差。本课从实际 Pod、节点标签和调度约束出发,还原候选节点集合,再解释预期节点为什么没有胜出。
学习目标
- 区分决定候选节点资格的硬约束与影响排序的软偏好
- 用实际 Pod 配置和节点状态解释最终落点
- 识别 preferred 亲和性与拓扑分布规则不能保证固定节点的边界
先确认实际落点与完整约束
先记录 Pod 最终落点,再读取实际 Pod 的调度配置。不要只看 Deployment 或 StatefulSet 模板,因为准入控制可能修改 Pod,节点标签和污点也可能在创建 Pod 后发生变化。
kubectl get pod web-0 -n scheduling-lab -o wide
kubectl get pod web-0 -n scheduling-lab -o yaml
kubectl get nodes --show-labels
预期输出
NAME    READY   STATUS    NODE
web-0   1/1     Running   <NODE_NAME>

# 后续输出还会包含 Pod 的 spec、节点标签等详细信息,具体内容因集群而异。
<NODE_NAME> 是本次需要解释的实际结果。重点核对 nodeSelector、nodeAffinity、Pod 亲和与反亲和、topologySpreadConstraints、tolerations、资源 requests,以及是否显式设置了 spec.nodeName。如果 spec.nodeName 已指定,Pod 会绕过默认调度器选择节点。
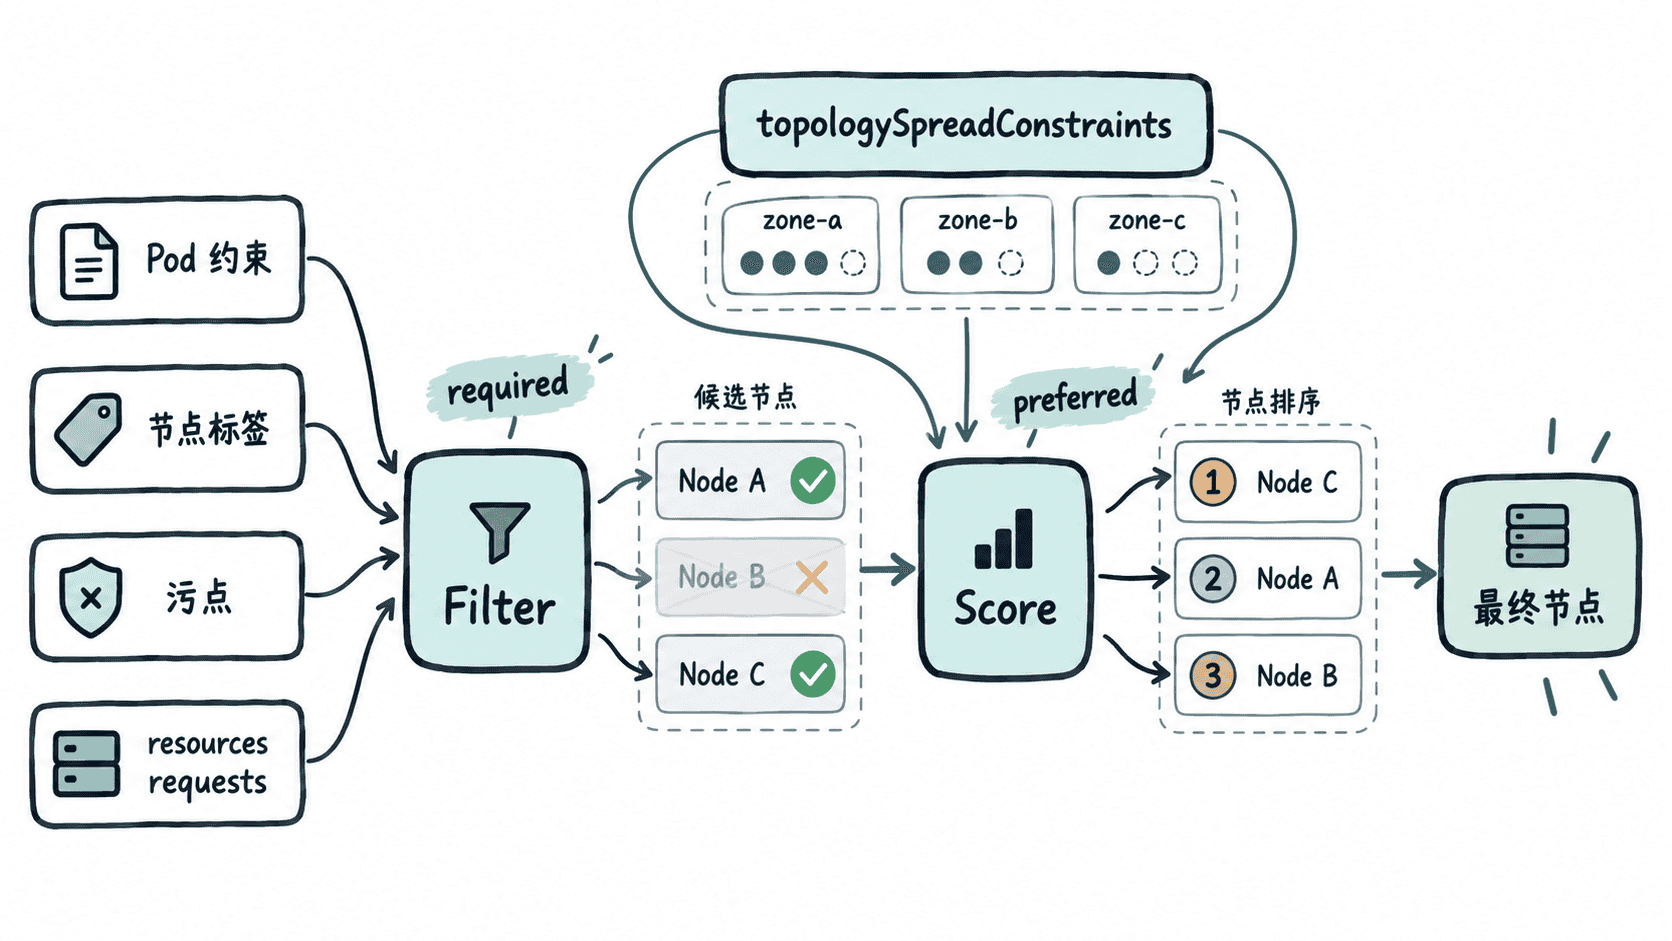
先判断预期节点有没有通过过滤
调度器会先排除不能运行该 Pod 的节点。即使某节点满足 preferred 偏好,只要资源 requests、required 节点亲和、不可容忍的污点、Pod 硬亲和或拓扑硬约束不满足,它就不会进入后续评分阶段。
kubectl describe node <EXPECTED_NODE>
kubectl get node <EXPECTED_NODE> --show-labels
kubectl get pod web-0 -n scheduling-lab -o jsonpath='{.spec.affinity}{"\n"}'
预期输出
Name:               <EXPECTED_NODE>
Taints:             <VALUE>
Allocated resources:
  Resource           Requests
  cpu                <VALUE>
  memory             <VALUE>

<VALUE>
实际字段和资源数值会因集群而异。如果预期节点不满足任何 required 条件,后面的 preferred 权重再高也无法让它被选中。因此排查顺序应先回答“它是否有资格”,再讨论“它为什么没有最高分”。
再检查软偏好是否被误当成保证
preferredDuringSchedulingIgnoredDuringExecution 只影响可行节点之间的评分,不承诺 Pod 一定落到满足偏好的节点。多个评分插件会共同影响最终得分,因此某一条 preferred 的 weight 也不能直接理解为最终总分或命中概率。
下面是依赖 Pod spec.affinity.nodeAffinity 上下文的片段示例:
preferredDuringSchedulingIgnoredDuringExecution:
  - weight: 80
    preference:
      matchExpressions:
        - key: topology.kubernetes.io/zone
          operator: In
          values:
            - us-west-1a
这段配置表示:通过硬性过滤后,位于 us-west-1a 且满足该表达式的节点会获得这项节点亲和偏好的评分优势,但其他可行节点仍可能最终胜出。验证时应比较实际落点与节点标签,而不是把 weight: 80 理解成“80% 概率”或绝对优先级。
kubectl get nodes -L topology.kubernetes.io/zone
kubectl get pod web-0 -n scheduling-lab -o jsonpath='{.spec.nodeName}{"\n"}'
预期输出
NAME          ZONE
<NODE_NAME>   <VALUE>

<NODE_NAME>
拓扑规则要结合现有 Pod 分布判断
PodAffinity、PodAntiAffinity 和 topologySpreadConstraints 都依赖集群当前状态。尤其是拓扑分布规则,调度器不仅检查新 Pod,还会统计匹配选择器的既有 Pod 在各 topology domain 中的分布,因此同一份配置在不同时间可能得到不同落点。
kubectl get pods -n scheduling-lab -o wide --show-labels
kubectl get nodes -L topology.kubernetes.io/zone,kubernetes.io/hostname
预期输出
NAME      NODE          LABELS
<VALUE>   <NODE_NAME>   <VALUE>

NAME          ZONE      HOSTNAME
<NODE_NAME>   <VALUE>   <VALUE>
如果使用 whenUnsatisfiable: DoNotSchedule,会导致偏斜度超出约束的候选节点无法通过该拓扑约束;使用 ScheduleAnyway 时,则主要通过评分倾向更均衡的拓扑域。因此已有 Pod 的数量或分布变化后,新 Pod 的最优节点也可能随之变化。
用重新调度验证推断
确认根因后,只修改与目标不一致的规则。真正要求节点必须具备某标签,应使用 required 硬约束;目标是跨节点或跨可用区均衡,则应调整拓扑分布规则,而不是不断提高 preferred 权重。
重新调度前先确认 Pod 由控制器管理,避免删除独立 Pod 后无法自动恢复。
kubectl get pod web-0 -n scheduling-lab -o jsonpath='{.metadata.ownerReferences[0].kind}{"\n"}'
kubectl delete pod web-0 -n scheduling-lab
kubectl get pods -n scheduling-lab -o wide --watch
预期输出
StatefulSet
pod "web-0" deleted
NAME    READY   STATUS    NODE
web-0   1/1     Running   <NODE_NAME>
控制器类型、Pod 名称和节点名称可能不同。重新调度只能验证规则在当前集群状态下的行为,不能证明软偏好以后始终得到相同节点;需要稳定保证的放置条件,应通过 required 约束或明确的拓扑策略表达。