
容器与云原生 / 系统课时
认识节点压力驱逐链路
认识节点压力驱逐链路
节点压力驱逐发生在节点资源逼近危险边界时,由 kubelet 主动终止 Pod 以回收资源。本文沿资源信号、压力条件、节点级回收、Pod 排序到控制器补建这条链路,说明每一步该看什么,以及 Guaranteed Pod 真正的驱逐边界。
学习目标
- 说清 kubelet 从资源信号到节点压力条件的判断链路
- 理解 kubelet 为什么先尝试节点级回收,再选择要驱逐的 Pod
- 判断普通驱逐排序与
GuaranteedPod 兜底驱逐的边界
从资源信号到压力条件
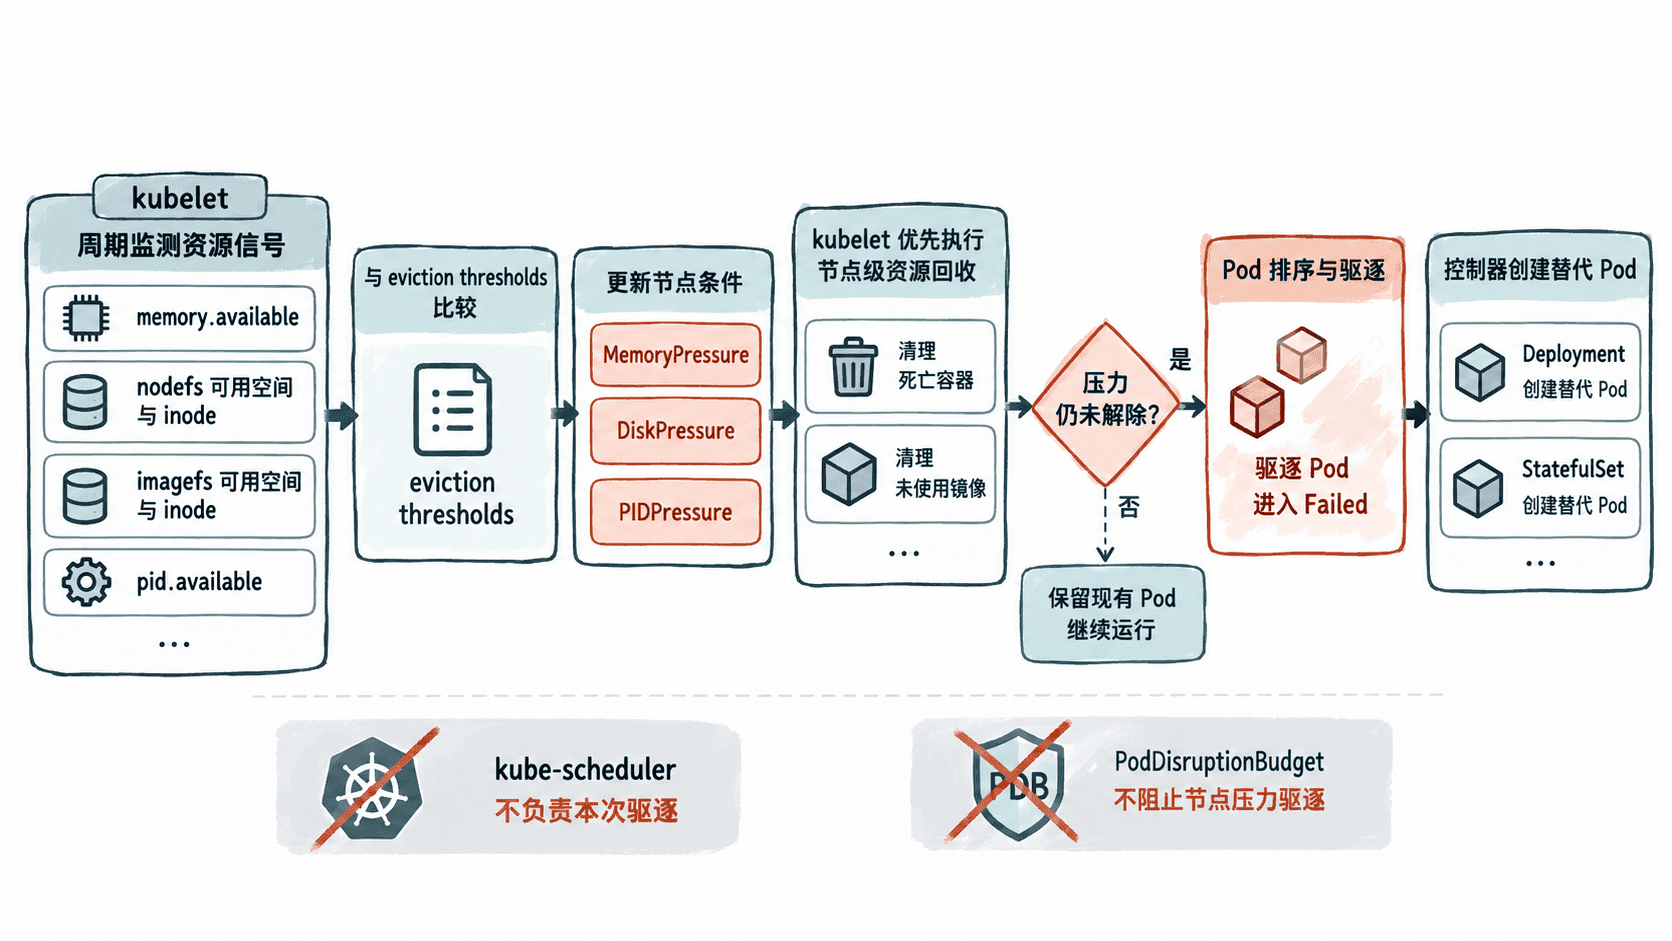
kubelet 会周期性采集节点资源信号,并与软、硬驱逐阈值比较。常见信号包括 memory.available、nodefs.available、nodefs.inodesFree、imagefs.available、imagefs.inodesFree 和 pid.available。内存阈值对应 MemoryPressure,文件系统容量或 inode 阈值对应 DiskPressure,PID 不足对应 PIDPressure。
节点压力条件与“已经驱逐 Pod”不是同一件事。只要软阈值或硬阈值被满足,kubelet 就可以报告对应压力条件;软阈值还需要持续超过配置的宽限时间,才会进入 Pod 驱逐。也就是说,排查时要把“压力已经出现”和“驱逐已经发生”分开判断。
先确认节点压力状态
先从 Node Conditions 判断当前是哪一种资源压力,再把状态变化与 kubelet 事件、Pod 终止时间关联起来。
kubectl describe node <NODE>预期结果(节选)
Conditions:
  Type            Status
  MemoryPressure  False
  DiskPressure    False
  PIDPressure     False
现场节点可能有某一项为 True,并带有不同的 Reason、Message 和时间字段;这些动态值应以实际输出为准。
kubelet 先回收节点级资源
触发阈值并不等于立即牺牲业务 Pod。kubelet 会先尝试回收节点自身可以释放的资源,其中磁盘压力最典型:它可以清理已结束的 Pod 和容器,或删除未使用的镜像。若资源回到安全范围,驱逐流程就在这里停止。
只有节点级回收不足以解除压力时,kubelet 才开始选择终止用户 Pod。因此,看到 DiskPressure 后应先确认垃圾回收和镜像回收是否奏效,不要直接把 Pod 消失归因于调度器。
Pod 驱逐排序真正看什么
对于能够与 Pod request 比较的资源,kubelet 排序依次关注:资源使用是否超过 request、Pod Priority,以及使用量相对 request 的程度。QoS 类别不是直接排序键,但会影响 Pod 是否容易落入“超过 request”的候选集合,因此只能用来估计常见顺序,不能替代实际排序规则。
通常,已经超过 request 的 Pod 会先参与排序,其中 Priority 较低者更容易先被驱逐;在 Priority 相同的情况下,再比较相对 request 的超额程度。对于 inode、PID 这类没有对应 Pod request 的资源,则主要依据 Pod Priority 排序。
驱逐后如何恢复
节点压力驱逐由 kubelet 发起,不是 API-initiated Eviction。被选中的 Pod 会被终止,并进入 Failed 阶段;kubelet 也不会因为 PodDisruptionBudget 不允许中断就停止这类驱逐,因此 PDB 不能作为节点资源耗尽时的保护屏障。
如果 Pod 由 Deployment、StatefulSet 等工作负载控制器管理,控制器通常会创建替代 Pod。新 Pod 需要重新经过正常调度,能否再次落到原节点取决于当时的压力状态、污点、资源容量和其他调度约束。
因此,取证顺序应固定为“资源信号 → 驱逐阈值 → Node Conditions → 节点级回收 → Pod 排序 → kubelet 驱逐 → 控制器补建”。沿这条链路检查,才能区分节点自保、调度失败与控制器恢复这三类完全不同的问题。