
容器与云原生 / 系统课时
演练容量不足与驱逐恢复
演练容量不足与驱逐恢复
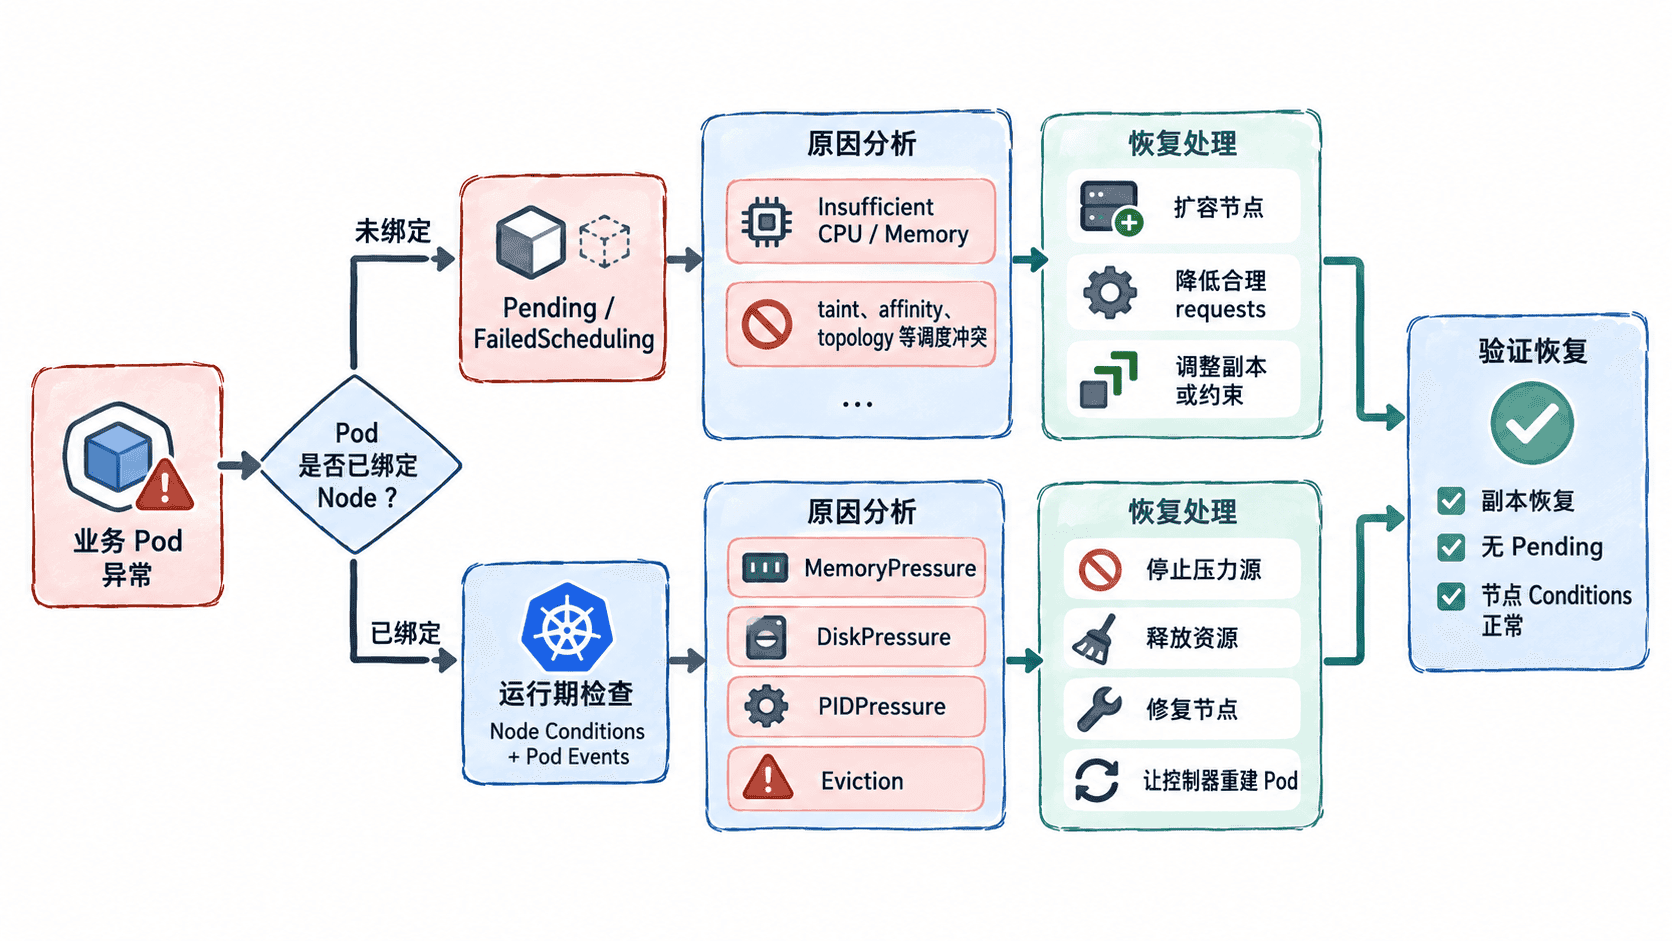
这次演练把“Pod 调度不上”和“Pod 已运行后被驱逐”放进同一个故障闭环:先制造可调度容量不足,再观察节点压力下的驱逐证据,最后沿 Pod 事件、Node Conditions 和资源请求定位根因,完成止损、恢复,并修正容易让故障反复出现的容量与调度策略。
学习目标
- 区分容量不足导致的
FailedScheduling与节点压力导致的 Eviction - 使用 Pod 事件、Node Conditions 和资源请求判断故障发生在调度前还是运行期
- 完成扩容或降载、压力解除和策略修正,并验证工作负载重新稳定运行
建立演练基线
准备一个至少包含两个可调度 Worker Node 的测试集群,并确保当前账号可以创建 Deployment、查看 Node 和 Pod 事件。先创建一个副本数为 3、带明确资源请求的工作负载,确认基线状态能够正常调度。
apiVersion: apps/v1
kind: Deployment
metadata:
  name: capacity-lab
  namespace: default
spec:
  replicas: 3
  selector:
    matchLabels:
      app: capacity-lab
  template:
    metadata:
      labels:
        app: capacity-lab
    spec:
      containers:
        - name: app
          image: nginx:1.27
          resources:
            requests:
              cpu: 500m
              memory: 256Mi
            limits:
              memory: 512Mi
这里必须使用合法的 selector.matchLabels,并让它与 Pod 模板中的 metadata.labels 对应;若误写成 Labels,apps/v1 Deployment 清单会因字段无效而无法按示例创建。保存为 capacity-lab.yaml 后执行:
kubectl apply -f capacity-lab.yaml
kubectl get pods -l app=capacity-lab -o wide
预期输出
deployment.apps/capacity-lab created
NAME                  READY   STATUS    RESTARTS   AGE      IP       NODE
capacity-lab-<ID>     1/1     Running   0          <TIME>   <IP>     <NODE>
capacity-lab-<ID>     1/1     Running   0          <TIME>   <IP>     <NODE>
capacity-lab-<ID>     1/1     Running   0          <TIME>   <IP>     <NODE>
实际 Pod 名称、IP、节点名和时间会不同。若初始状态已经出现 Pending,先降低 requests 或清理实验集群中的无关负载,确保基线能够稳定运行,再开始注入故障。
制造容量不足并定位调度失败
调度器判断的是节点 Allocatable 与已调度 Pod 资源请求之间是否还能容纳新的请求,并不是直接根据节点此刻的 CPU 或内存利用率做装箱。为了稳定制造容量冲突,可以逐步提高副本数,使至少一个新 Pod 的 requests 无法装入任一候选节点。
kubectl scale deployment capacity-lab --replicas=20
kubectl get pods -l app=capacity-lab
预期结果
NAME                  READY   STATUS    RESTARTS   AGE
capacity-lab-<ID>     1/1     Running   0          <TIME>
capacity-lab-<ID>     0/1     Pending   0          <TIME>
...
具体能运行多少个副本取决于节点容量和已有工作负载,因此数量不是固定值。找到一个 Pending Pod 后查看事件:
kubectl describe pod <PENDING_POD_NAME>预期输出中应重点寻找 FailedScheduling。资源确实不足时,消息通常会指出没有节点满足资源请求,但节点数量和原因以集群实际情况为准。
Events:
  Type     Reason            Age      From               Message
  ----     ------            ----     ----               -------
  Warning  FailedScheduling  <TIME>   default-scheduler  0/<N> nodes are available: <REASON>
不要只凭 Pending 就判断“集群容量不足”。如果 <REASON> 指向 taint、node affinity、Pod affinity 或 topology spread constraint,故障属于调度约束冲突;只有原因明确指向 Insufficient cpu、Insufficient memory、ephemeral-storage 或扩展资源不足时,才应进入容量处理路径。
观察节点压力并识别驱逐
驱逐与调度失败发生在不同阶段。调度失败时 Pod 通常还没有 spec.nodeName;节点压力驱逐针对已经绑定到节点的 Pod,由 kubelet 根据节点压力信号和驱逐策略采取动作。
节点压力的注入方式高度依赖运行时、磁盘布局和节点管理权限。不要为了演练在生产节点直接写满磁盘、耗尽内存或创建大量进程;应只在专用测试节点使用受控压力工具,或者利用已经出现压力的测试节点观察真实事件。先检查节点 Conditions:
kubectl get nodes
kubectl describe node <NODE_NAME>
预期输出中,正常节点的压力条件应为 False;发生相应压力时,条件可能转为 True。
Conditions:
  Type             Status
  MemoryPressure   False
  DiskPressure     False
  PIDPressure      False
若测试节点进入压力状态,再查看该节点上的 Pod 和最近事件:
kubectl get pods -A --field-selector spec.nodeName=<NODE_NAME> -o wide
kubectl get events -A --sort-by=.lastTimestamp
预期结果
NAMESPACE   NAME         READY   STATUS     NODE
<NS>        <POD_NAME>   0/1     <STATUS>   <NODE_NAME>
...
LAST SEEN   TYPE      REASON     OBJECT           MESSAGE
<TIME>      Warning   <REASON>   pod/<POD_NAME>   <MESSAGE>
发生驱逐时,可以看到 Pod 终止、控制器重新创建副本,事件中也可能出现与节点压力或 Eviction 相关的信息。不同 Kubernetes 版本、容器运行时和压力类型的事件文本并不完全相同,应依据实际事件、Pod 状态和 Node Condition 联合判断,而不是匹配某个固定字符串。
按故障阶段止损和恢复
容量不足时,先确认 requests 是否符合工作负载真实需求。如果 requests 合理且业务确实需要更多副本,应增加可调度容量;单纯删除 Pending Pod 没有意义,因为 Deployment 重建后仍会面对同样的容量约束。测试环境中可以先把副本恢复到基线值,验证调度恢复:
kubectl scale deployment capacity-lab --replicas=3
kubectl rollout status deployment/capacity-lab
kubectl get pods -l app=capacity-lab -o wide
预期输出
deployment.apps/capacity-lab scaled
deployment "capacity-lab" successfully rolled out
NAME                  READY   STATUS    RESTARTS   AGE      IP       NODE
capacity-lab-<ID>     1/1     Running   0          <TIME>   <IP>     <NODE>
capacity-lab-<ID>     1/1     Running   0          <TIME>   <IP>     <NODE>
capacity-lab-<ID>     1/1     Running   0          <TIME>   <IP>     <NODE>
如果根因是节点压力,恢复动作应针对压力源。例如 DiskPressure 要检查镜像、容器可写层、日志和 emptyDir 等本地存储消耗;MemoryPressure 则要检查节点剩余内存、Pod 内存请求与实际使用以及系统进程占用。压力解除后,还要确认对应 Node Condition 已恢复,而不是只看到新 Pod 重新 Running。
修正容易复发的容量与调度策略
一次恢复只解决当前故障。要避免重复出现,应把本次证据回写到资源请求、节点容量和调度约束中。requests 明显高于长期需求时,可以基于历史监控重新设定,但不能为了“让 Pod 调度成功”直接删除 requests;requests 过低会让调度器高估节点承载能力,真实使用量上升后更容易进入节点压力。
如果 affinity、anti-affinity、taint 或 topology 约束把所有副本限制在很小的节点集合,即使整个集群仍有剩余资源,也可能持续 FailedScheduling。此时应检查这些约束是否真的对应故障域或隔离需求,并保证目标节点池具备足够容量。节点压力频繁出现时,还应治理节点级保留资源、日志与临时存储增长、镜像回收以及工作负载 requests/limits;驱逐是节点自我保护机制,不应被当作常规扩缩容手段。
验证恢复是否真正完成
最后同时检查工作负载、调度事件和节点压力状态,避免只验证其中一层。
kubectl get deployment capacity-lab
kubectl get pods -l app=capacity-lab -o wide
kubectl get nodes
kubectl get events --sort-by=.lastTimestamp
预期结果应满足三个条件:Deployment 的期望副本与可用副本一致,没有新的实验 Pod 持续 Pending,承载工作负载的节点保持 Ready 且不存在持续的压力 Condition。事件列表可能仍保留此前的 FailedScheduling 或驱逐记录,这是正常的历史证据;判断是否恢复应看当前状态以及是否仍持续产生新告警。
NAME           READY   UP-TO-DATE   AVAILABLE   AGE
capacity-lab   3/3     3            3           <TIME>
完整的故障闭环不是“删掉异常 Pod”,而是先判断故障发生在调度前还是运行期,再用事件和节点状态锁定容量、约束或节点压力,针对根因恢复资源,最后用副本可用性、Pending 状态和 Node Conditions 三层证据确认问题没有继续发生。