
容器与云原生 / 系统课时
排查 Pod 被意外驱逐
排查 Pod 被意外驱逐
Pod 突然消失或变成 Evicted 时,不能只看最后一条错误。排查要把 Pod 状态、事件、Node Conditions 与 kubelet 资源压力信号放到同一条时间线上,确认触发者、缺失资源,以及问题是否仍在持续。
学习目标
- 从 Pod 状态和事件中确认驱逐发生的时间、原因与节点
- 结合 Node Conditions 和资源使用情况识别内存、磁盘或 PID 压力
- 区分节点压力驱逐与其他删除、终止现象,并完成恢复验证
先确认这是不是一次驱逐
首先保留故障现场。被驱逐的 Pod 通常仍可通过 API 查询到,status.phase 常见为 Failed,status.reason 为 Evicted,status.message 会描述触发原因。不要看到容器终止就直接认定是 kubelet 驱逐:应用崩溃、Deployment 滚动更新、人工删除和节点关闭也会让 Pod 终止。
先查看 Pod 的状态、所在节点和详细事件:
kubectl get pod <POD> -n <NAMESPACE> -o wide
kubectl describe pod <POD> -n <NAMESPACE>
kubectl get pod <POD> -n <NAMESPACE> -o jsonpath='{.status.phase}{"\n"}{.status.reason}{"\n"}{.status.message}{"\n"}{.spec.nodeName}{"\n"}'
预期输出
Failed
Evicted
The node was low on resource: <RESOURCE_MESSAGE>
<NODE>
<RESOURCE_MESSAGE> 的实际内容会随触发的资源信号和 Kubernetes 版本不同而变化。关键证据是 reason=Evicted、对应说明以及 spec.nodeName,它们把故障限定到具体 Pod 和具体节点。
按时间线关联 Pod、事件与节点压力
节点压力驱逐不是调度器把 Pod “重新调度”出去,而是目标节点上的 kubelet 根据本机资源信号主动终止 Pod。常见压力包括 MemoryPressure、DiskPressure 和 PIDPressure;kubelet 会持续观察可用内存、节点或镜像文件系统的空间与 inode、可用 PID 等信号,并在达到驱逐阈值时采取动作。
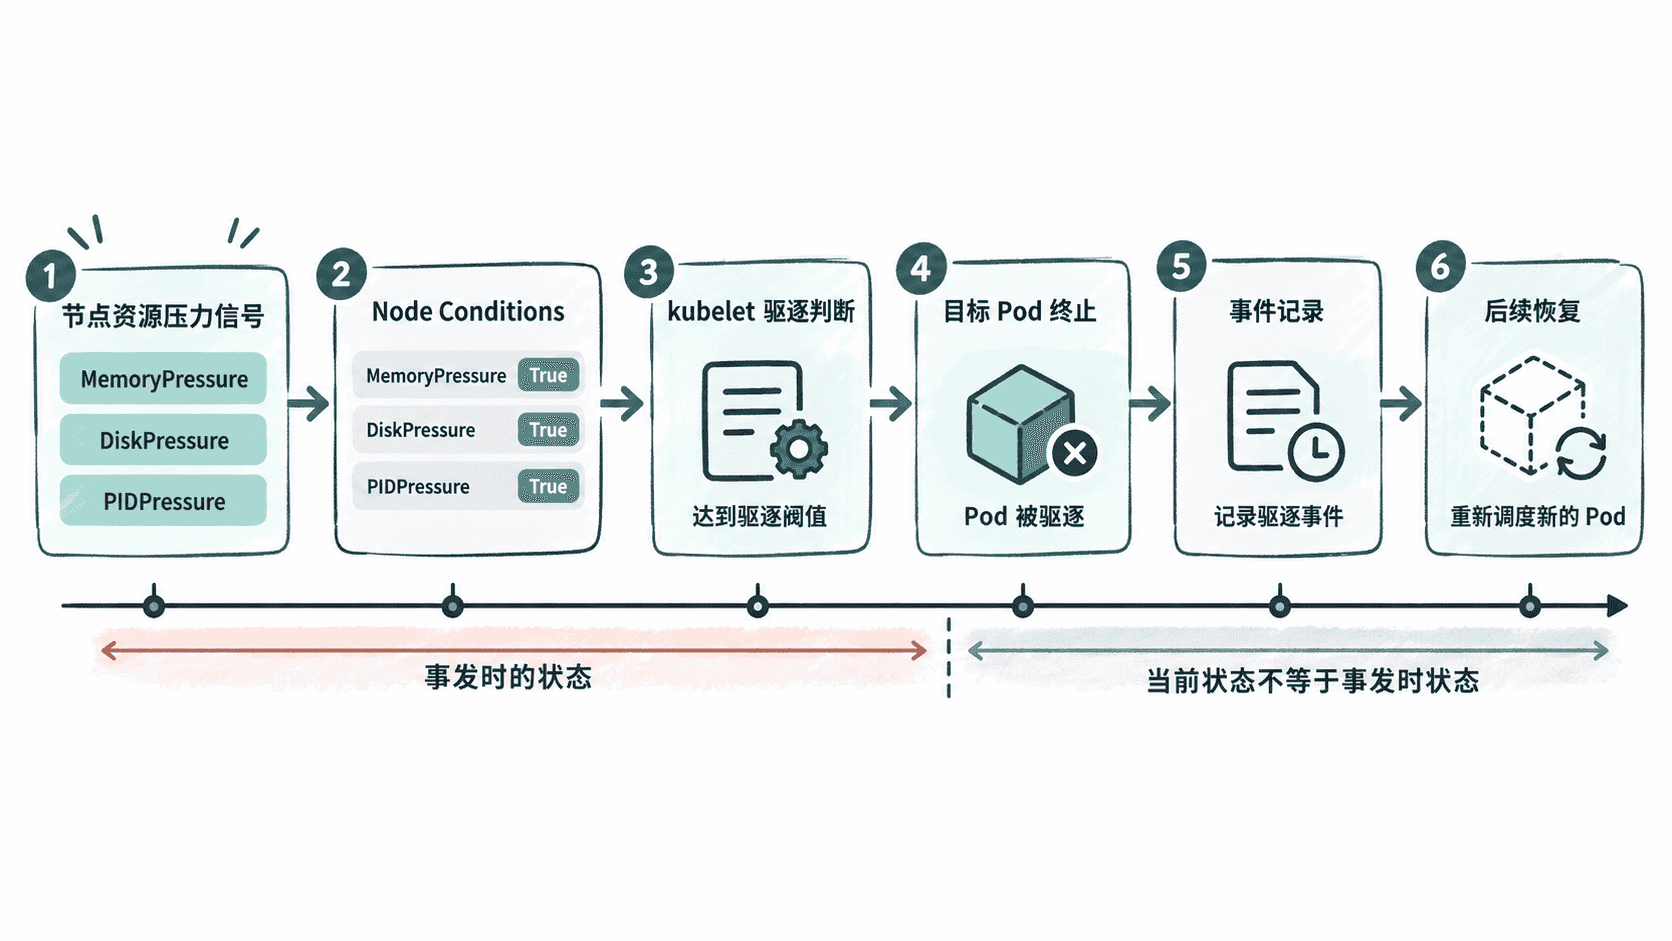
查看该节点当前 Conditions:
kubectl describe node <NODE>
kubectl get node <NODE> -o jsonpath='{range .status.conditions[*]}{.type}{"\t"}{.status}{"\t"}{.lastTransitionTime}{"\t"}{.reason}{"\n"}{end}'
预期输出
MemoryPressure	True	<TIME>	<REASON>
DiskPressure	False	<TIME>	<REASON>
PIDPressure	False	<TIME>	<REASON>
Ready True <TIME> <REASON>这里只是输出形态示例,实际节点未必仍处于压力状态。lastTransitionTime 很重要:如果驱逐发生后压力已经恢复,仅查看当前 False 不能证明当时没有压力,需要继续回看事件和监控历史。
接着按时间排序查看与节点相关的事件:
kubectl get events -A --field-selector involvedObject.kind=Node,involvedObject.name=<NODE> --sort-by=.lastTimestamp预期输出
<NAMESPACE> <TIME> <TYPE> <REASON> node/<NODE> <MESSAGE>事件的保留时间有限,而且不同发行版和组件产生的 Reason、Message 可能不同。因此事件适合还原近期现场,长期根因分析仍应依赖监控系统保存的节点资源曲线和 kubelet 日志。
找出真正触发阈值的资源
如果节点仍在线,可以先用 Metrics API 粗看当前 CPU 和内存。kubectl top pod 不能按 spec.nodeName 做字段筛选,因此先列出目标节点上的 Pod,再结合按内存排序的容器指标定位高消耗工作负载:
kubectl top node <NODE>
kubectl get pods -A --field-selector spec.nodeName=<NODE> -o wide
kubectl top pod -A --containers --sort-by=memory
预期输出
NAME     CPU(cores)   CPU(%)   MEMORY(bytes)   MEMORY%
<NODE>   <VALUE>      <VALUE>  <VALUE>         <VALUE>

NAMESPACE   NAME    READY   STATUS    RESTARTS   AGE       IP     NODE     NOMINATED NODE   READINESS GATES
<NAMESPACE> <POD>   <VALUE> <STATUS>  <VALUE>    <VALUE>   <IP>   <NODE>   <VALUE>          <VALUE>

NAMESPACE   POD     NAME          CPU(cores)   MEMORY(bytes)
<NAMESPACE> <POD>   <CONTAINER>   <VALUE>      <VALUE>
kubectl top 只能反映当前或近期采样值,也不能完整覆盖 kubelet 的所有驱逐信号。磁盘驱逐还要检查文件系统可用空间和 inode,PID 驱逐要检查进程数量;历史内存尖峰也可能早已回落。因此应优先从监控系统查驱逐前后的可用内存、文件系统空间与 inode、PID 使用量,再和 Pod 终止时间对齐。
如果有节点访问权限,还应检查 kubelet 日志中对应时间窗口。以下命令适用于 kubelet 由 systemd 管理的节点:
journalctl -u kubelet --since "<TIME_START>" --until "<TIME_END>" | grep -Ei 'evict|pressure|memory|disk|pid'预期输出
<TIME> <NODE> kubelet[<PID>]: <EVICTION_OR_PRESSURE_MESSAGE>日志文本会因 Kubernetes 版本和发行版不同而变化,不应依赖某个固定句子匹配。重点是确认同一时间窗口内是否出现资源压力判定、驱逐管理器动作以及目标 Pod。
判断为什么偏偏是这个 Pod
发生节点压力后,并不是简单按照“谁占内存最多”选择牺牲者。kubelet 会根据受压资源对候选 Pod 排序,通常综合资源使用是否超过 requests、Pod Priority,以及相对于 requests 的使用量;某些没有对应 request 的资源信号会采用不同的排序依据。因此 Priority 很高并不等于绝对不会被节点压力驱逐,requests 配置失真也会影响相对位置。
检查被驱逐 Pod 的 requests、limits 和优先级:
kubectl get pod <POD> -n <NAMESPACE> -o jsonpath='{.spec.priorityClassName}{"\t"}{.spec.priority}{"\n"}{range .spec.containers[*]}{.name}{"\trequests="}{.resources.requests}{"\tlimits="}{.resources.limits}{"\n"}{end}'预期输出
<PRIORITY_CLASS>	<PRIORITY>
<CONTAINER>	requests=<REQUESTS>	limits=<LIMITS>
如果业务长期实际使用明显高于 requests,调度阶段可能看起来仍有容量,但运行期实际压力会更高。修复时不能只扩大 limits,还要检查 requests 是否反映真实工作集、节点是否有足够余量,以及临时文件、日志或镜像是否持续挤占磁盘。
修复后验证驱逐链路已经消失
先处理真正的资源原因,例如释放磁盘、扩容节点、修正 requests、限制异常进程或迁移高消耗工作负载。然后确认节点压力 Condition 已恢复,并观察新的工作负载是否稳定运行:
kubectl get node <NODE>
kubectl get node <NODE> -o jsonpath='{range .status.conditions[*]}{.type}{"\t"}{.status}{"\n"}{end}'
kubectl get pods -A --field-selector spec.nodeName=<NODE>
kubectl get events -A --sort-by=.lastTimestamp | tail -n 30
预期输出
NAME     STATUS   ROLES     AGE       VERSION
<NODE>   Ready    <ROLES>   <VALUE>   <VERSION>

MemoryPressure	False
DiskPressure	False
PIDPressure	False
Ready	True
验证不能只停留在 Ready。至少还应确认相关 Pressure Condition 已回到 False、资源指标远离驱逐阈值,并在一个完整业务高峰窗口内没有出现新的 Evicted Pod。这样才能证明解决的是驱逐根因,而不是仅仅等节点暂时恢复。