
容器与云原生 / 系统课时
理解污点与容忍
理解污点与容忍
污点和容忍用于从节点一侧控制 Pod 是否适合被调度以及能否继续留在节点上。污点负责“排斥”,容忍只表示 Pod 能接受某类污点,并不保证它一定被放到该节点。本课通过命令验证三种 effect,并拆解 toleration 的匹配规则。
学习目标
- 能说明三种 taint effect 对调度与已有 Pod 的主要影响
- 能判断一个 toleration 是否与节点污点匹配
- 能用
kubectl taint与 Pod 配置验证调度和驱逐行为
污点和容忍如何配合
节点污点常写成 key=value:effect 或 key:effect。调度器检查节点上的污点,并忽略已被 Pod toleration 匹配的项;剩余未被容忍的污点再参与判断该节点是否适合这个 Pod。
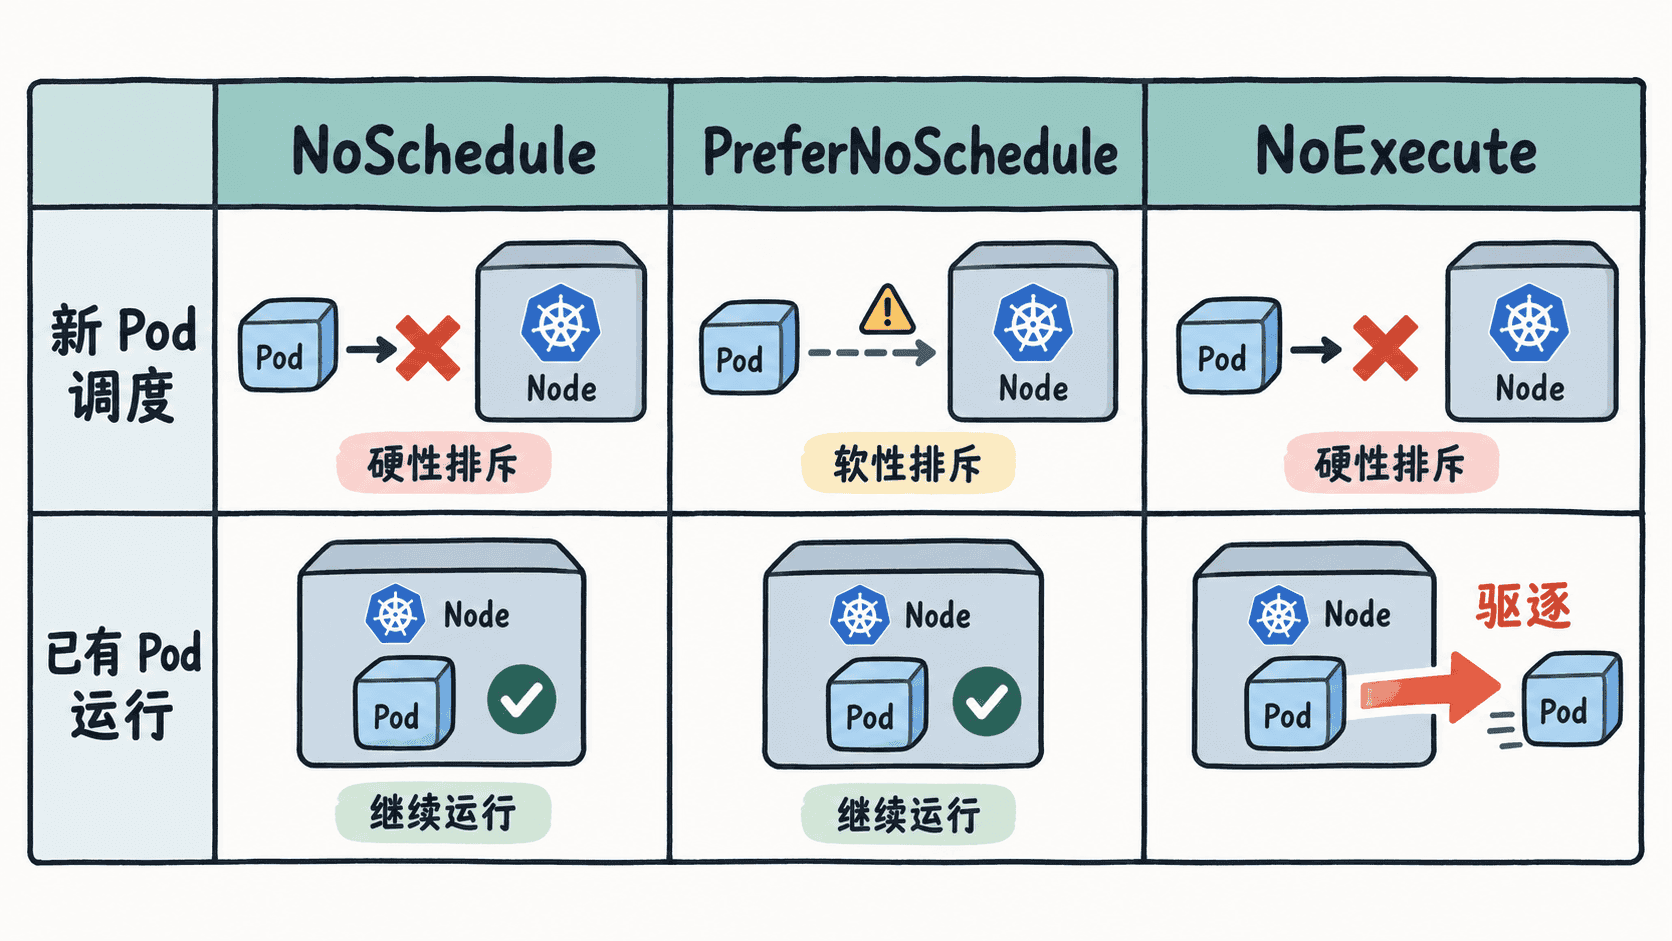
NoSchedule 会阻止不容忍该污点的新 Pod 调度到节点,但不会主动驱逐已经运行的 Pod。PreferNoSchedule 是软性排斥,调度器会尽量避开该节点,但在缺少更合适节点时仍可能选择它。
NoExecute 的核心语义是控制 Pod 是否有资格继续留在节点上:对于已经绑定到该节点的 Pod,不容忍该污点会被驱逐,容忍则可以按 toleration 规则继续运行。对于尚未绑定的 Pod,调度器在节点筛选阶段同样会检查 taint 与 toleration,因此能否选中该节点应放回完整调度流程理解,而不要把 NoExecute 简化成“专门阻止新 Pod”的调度规则。
验证 NoSchedule
先给目标节点加一个 dedicated=team-a:NoSchedule 污点。下面使用 worker-a 作为示例节点名。
kubectl taint nodes worker-a dedicated=team-a:NoSchedule
kubectl describe node worker-a
预期结果
node/worker-a tainted
Taints: dedicated=team-a:NoSchedule
没有匹配 toleration 的已有 Pod 不会因为这个 NoSchedule 污点自动被驱逐,但之后的新 Pod 在调度时不能选择 worker-a。要允许某个 Pod 使用该节点,可以添加精确匹配的 toleration:
apiVersion: v1
kind: Pod
metadata:
  name: toleration-demo
spec:
  tolerations:
    - key: dedicated
      operator: Equal
      value: team-a
      effect: NoSchedule
  containers:
    - name: web
      image: nginx:1.27
这是完整 Pod 配置,可保存为 <PATH>/toleration-demo.yaml。创建并查看调度结果:
kubectl apply -f <PATH>/toleration-demo.yaml
kubectl get pod toleration-demo -o wide
预期结果
pod/toleration-demo created
NAME              READY   STATUS    RESTARTS   AGE      NODE
toleration-demo   1/1     Running   0          <TIME>   <VALUE>
其中 <VALUE> 是实际节点名。Pod 对 worker-a 上该污点具有容忍资格,但 toleration 只是解除排斥,并不会吸引 Pod 前往这个节点;如果还有其他可行节点,调度器仍可能选择别处。若需要限定或优先使用某个节点池,还应配合节点亲和性等正向放置规则。
判断 toleration 是否匹配
toleration 的匹配要同时考虑 key、operator、value 和 effect。operator: Equal 要求 key 与 value 匹配;operator: Exists 只要求 key 匹配,此时不应设置 value。如果 toleration 省略 effect,它可以匹配满足 key、operator 和 value 条件的任意 effect。
一个容易忽略的特殊情况是:当 operator: Exists 且 key 为空时,它可以匹配所有 key;如果同时省略 effect,这个 toleration 会容忍所有污点。生产环境通常不应无意中使用如此宽泛的规则。
理解 NoExecute 与 tolerationSeconds
NoExecute 最重要的区别是它会继续作用于已经绑定到节点的 Pod。节点出现该污点后,不匹配的 Pod 会被驱逐;匹配且没有时间限制的 Pod 可以继续运行。如果 toleration 设置了 tolerationSeconds,Pod 只能在指定秒数内继续容忍这个 NoExecute 污点,超时后污点仍存在就会被驱逐。
片段示例:下面配置需要放入 Pod 的 spec.tolerations,并假设节点存在 maintenance=true:NoExecute 污点。
tolerations:
  - key: maintenance
    operator: Equal
    value: "true"
    effect: NoExecute
    tolerationSeconds: 300
生效行为是:Pod 在该污点持续存在时最多继续留在节点 300 秒;如果 300 秒内污点被移除,就不会因为这次 tolerationSeconds 到期而被驱逐。可以用下面的命令观察节点污点和 Pod 当前状态:
kubectl get node worker-a -o jsonpath='{.spec.taints}'
kubectl get pod toleration-demo -o wide
预期结果
<VALUE>
NAME              READY   STATUS    RESTARTS   AGE      NODE
toleration-demo   1/1     Running   0          <TIME>   <VALUE>
第一行 <VALUE> 代表节点当前的 taint 列表,具体内容取决于实际配置;第二条命令显示 Pod 的实时状态和所在节点。若要验证驱逐,需要确保被观察的 Pod 实际运行在带有该 NoExecute 污点的节点上。
清理测试污点并形成策略
实验结束后可以删除前面添加的 NoSchedule 污点:
kubectl taint nodes worker-a dedicated:NoSchedule-预期结果
node/worker-a untainted污点适合表达“默认不要来”或“只有特定工作负载可以来”的节点治理策略,例如专用节点、特殊硬件节点和维护隔离。容忍只是解除排斥;如果目标是让 Pod 必须或优先落到这些节点,还需要配合节点亲和性等正向放置规则。