
流媒体与实时通信 / 系统课时
搭建并压测一套端到端直播系统
搭建并压测一套端到端直播系统
本课用一套可复现的实验环境把“推流→媒体处理→HLS 分片→并发播放→监控→故障注入”串起来,并用固定指标得到容量基线。完成后,你应能交付一张架构图、一组性能数据和一份故障复盘,而不是只证明服务能启动。
学习目标
- 用 Docker 组装 FFmpeg、SRS、Prometheus 与 cAdvisor 的最小实验链路
- 执行多路推流、并发观看、网络抖动和节点故障测试
- 根据 CPU、内存、请求成功率与恢复时间形成可复核的容量结论
搭建实验链路
本实验采用 SRS 负责 RTMP 接入和 HLS 输出,Prometheus 采集监控数据,cAdvisor 提供容器级 CPU、内存等指标。SRS 官方文档给出了 1935、1985、8080 等默认服务端口以及 HLS 播放地址;这里选用 ossrs/srs:5 作为兼容性较好的实验镜像。citeturn703812search0turn703812search4
建议实验机至少准备 4 vCPU、8 GB 内存、20 GB 可用磁盘。下面的基线以 1280×720、30 fps、约 2 Mbps 的单路测试流为起点,正式容量结果不能直接外推到生产环境。
架构关系如下,图中重点看清推流面、媒体面、播放面和观测面分别在哪里。
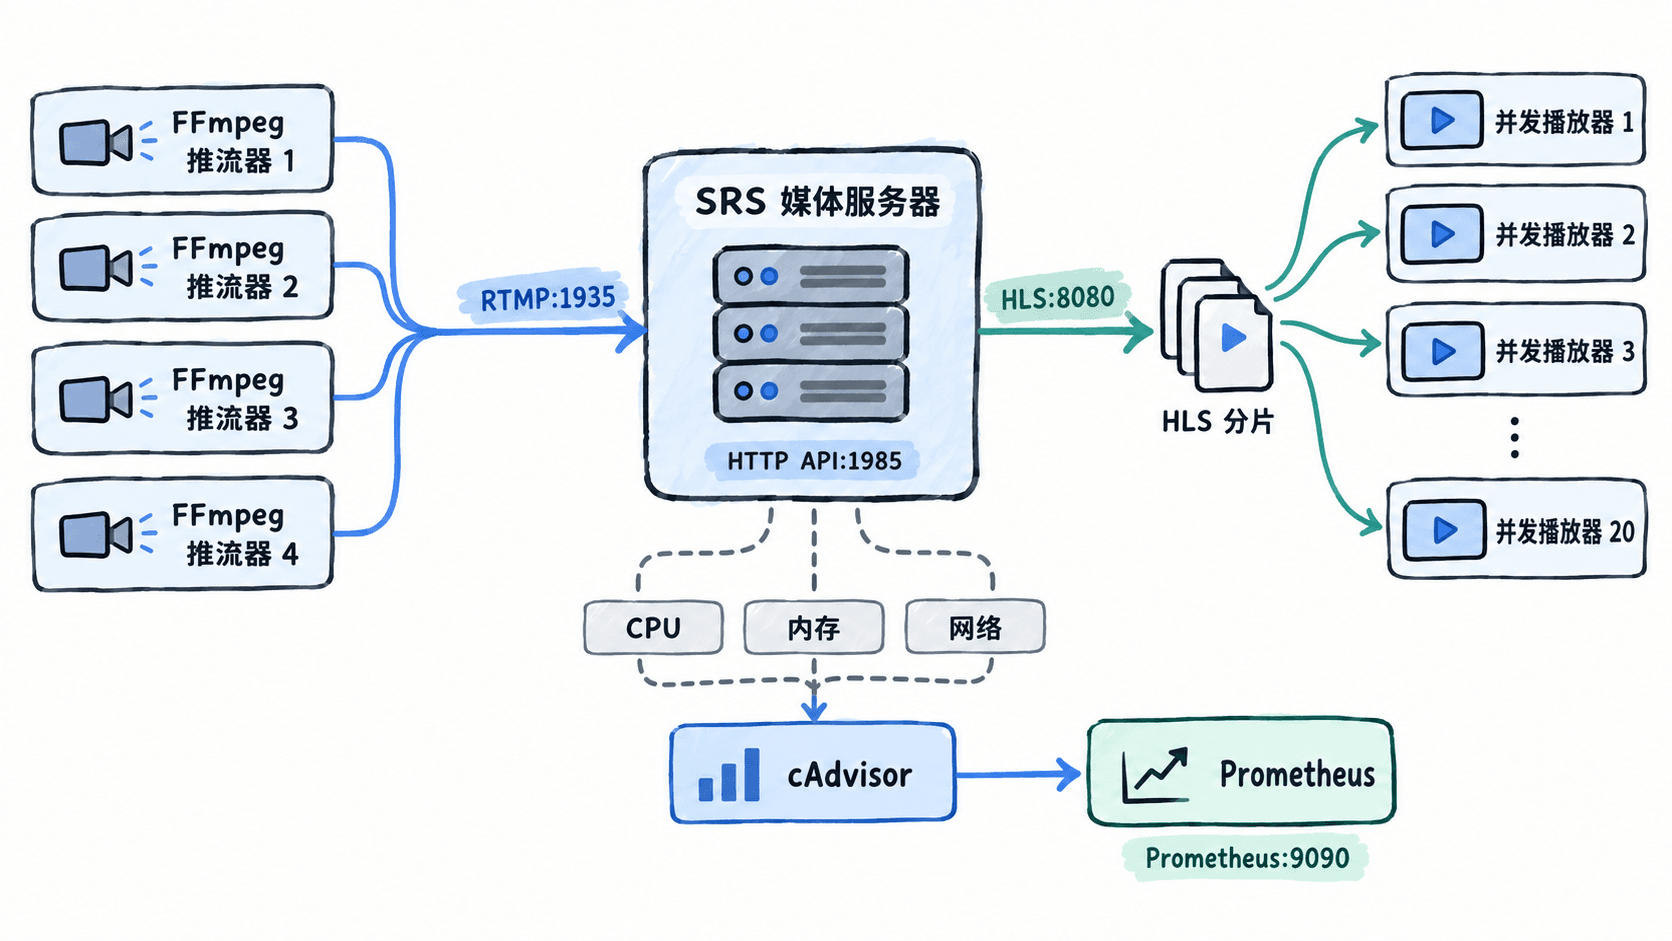
在项目目录创建 docker-compose.yml,内容如下。Prometheus 镜像固定为当前可查到的 3.15.1,避免实验过程中因自动更新导致结果漂移。Prometheus 官方文档也支持通过 Docker 运行并挂载自定义 prometheus.yml。citeturn703812search3turn703812search6
services:
  srs:
    image: ossrs/srs:5
    command: ./objs/srs -e
    ports:
      - "1935:1935"
      - "1985:1985"
      - "8080:8080"

  cadvisor:
    image: gcr.io/cadvisor/cadvisor:latest
    privileged: true
    volumes:
      - /:/rootfs:ro
      - /var/run:/var/run:ro
      - /sys:/sys:ro
      - /var/lib/docker:/var/lib/docker:ro
    ports:
      - "8081:8080"

  prometheus:
    image: prom/prometheus:v3.15.1
    command:
      - --config.file=/etc/prometheus/prometheus.yml
    volumes:
      - ./prometheus.yml:/etc/prometheus/prometheus.yml:ro
    ports:
      - "9090:9090"
再创建 prometheus.yml,让 Prometheus 抓取 cAdvisor。这样至少能比较不同压测阶段的容器 CPU、内存和网络变化。
global:
  scrape_interval: 5s

scrape_configs:
  - job_name: cadvisor
    static_configs:
      - targets: ["cadvisor:8080"]
启动后先检查 1935、8080 和 9090 是否可访问;实验结束可以用 docker compose down 清理容器。
建立可重复的推流与播放基线
先启动链路,再用 FFmpeg 生成 4 路独立测试流。每路使用不同 stream 名称,避免多个推流器争抢同一个发布地址。SRS 支持通过不同 URL 同时承载多个流。citeturn703812search2
docker compose up -d && sleep 5
for i in 1 2 3 4; do
  docker run -d --rm --name "ffmpeg-$i" --add-host=host.docker.internal:host-gateway ossrs/srs:encoder \
    ffmpeg -re -f lavfi -i "testsrc2=size=1280x720:rate=30" \
    -c:v libx264 -preset veryfast -tune zerolatency -b:v 2M -maxrate 2M -bufsize 4M \
    -f flv "rtmp://host.docker.internal/live/stream-$i"
done
sleep 8
curl -fsS http://localhost:8080/live/stream-1.m3u8 | head -n 8
预期输出
#EXTM3U
#EXT-X-VERSION:3
#EXT-X-TARGETDURATION:2
#EXT-X-MEDIA-SEQUENCE:...
#EXTINF:2.000,
...
这里的 ... 表示实际序列号和分片文件名会随启动时间变化。HLS 首次生成分片需要等待一段时间,因此不要在推流刚启动的瞬间把“播放失败”直接判为故障。citeturn703812search4
基线阶段固定记录四项数据:单路码率、同时推流路数、HLS 请求成功率、SRS/cAdvisor 的资源占用。建议每轮持续 5 分钟,前 60 秒作为预热,不把预热区数据混入最终平均值。
执行并发观看与容量测试
并发观看不要只打开多个浏览器标签页,否则很难稳定复现。实验中可直接并行拉取同一 HLS 播放列表;每个播放器循环请求播放列表并访问其中的分片,观察 HTTP 错误和资源变化。
seq 1 20 | xargs -I{} -P20 sh -c 'for n in $(seq 1 60); do curl -fsS http://localhost:8080/live/stream-1.m3u8 >/dev/null || exit 1; sleep 1; done' 预期结果
命令正常结束并返回退出码 0;若任一播放器请求连续失败,xargs 所在命令的退出状态可能为非 0。把测试分成 20、40、80 个并发观看规模,每档至少跑 5 分钟。容量不是“服务还活着”这么简单,建议把判定条件写死:HLS 请求成功率 ≥99.5%,容器 CPU 不持续高于 85%,内存无持续增长趋势,错误率没有随时间累积。如果 40 并发满足条件而 80 并发突破任一门槛,就把 40 并发记录为当前安全基线,而不是把 80 并发写成理论容量。
注入抖动与节点故障
网络抖动测试应独立于并发测试,否则出现卡顿时很难判断是带宽不足还是网络异常。可以在专门的推流容器中注入 120 ms 延迟和 3% 丢包;测试结束立即删除 netem 规则。
docker exec ffmpeg-1 sh -c 'ip link show eth0 >/dev/null && apk add --no-cache iproute2 >/dev/null 2>&1 || true; tc qdisc replace dev eth0 root netem delay 120ms loss 3%'
sleep 120
docker exec ffmpeg-1 tc qdisc show dev eth0
docker exec ffmpeg-1 tc qdisc del dev eth0 root
预期结果
qdisc netem ... delay 120ms loss 3%
qdisc noqueue 0: root refcnt 2
如果实验镜像没有包管理器或没有 tc,不要把“命令不存在”误判成直播系统故障;改用宿主机上的 Linux 测试节点,或使用具备 NET_ADMIN 能力的专用压测容器。生产环境不要直接在承载其他业务的宿主机接口上执行全局 tc。
节点故障测试采用可观察、可恢复的动作。先确认 HLS 正常,再停止 SRS,观察播放请求如何失败、监控多久发现实例消失、恢复后多久重新产生可用分片。故障注入窗口建议固定为 60 秒,并记录 T0=停止服务、T1=监控发现、T2=服务恢复、T3=播放恢复,最终把恢复时间定义为 T3-T0,不要只记录容器重启耗时。
形成性能基线与复盘
最终交付至少包含一张架构图、一张容量表和一份故障复盘。容量表不要只写“CPU 很高”,而应记录可比较的数字,例如:
| 场景 | 推流数 | 播放并发 | 持续时间 | HLS 成功率 | CPU 峰值 | 内存变化 | 结论 |
|---|---|---|---|---|---|---|---|
| 基线 | 4 | 20 | 5 分钟 | 99.9% | 52% | +120 MB | 通过 |
| 并发加压 | 4 | 40 | 5 分钟 | 99.8% | 71% | +180 MB | 通过 |
| 容量边界 | 4 | 80 | 5 分钟 | 98.7% | 91% | +430 MB | 不通过 |
上表只是报告格式示例,实验提交时必须替换成你自己的实测值,不能把示例数字当成真实容量。压测结论应至少回答三个问题:第一,哪一个资源先成为瓶颈;第二,瓶颈出现时哪些业务指标先恶化;第三,把推流数、观看并发或节点数量增加多少后,系统重新回到可接受区间。
故障复盘则按“现象→证据→根因→修复→验证”写。比如一次 3% 丢包测试中,如果 HLS 成功率从 99.9% 降到 97.8%,同时推流端断流重连增加,而 SRS CPU 仍低于 60%,就应优先检查网络丢包和发送端重试,而不是先扩容媒体服务器。这样得到的结果才可以真正用于下一轮容量规划。