
流媒体与实时通信 / 系统课时
推流入口故障如何切换接入节点
推流入口故障如何切换接入节点
本课解决直播推流入口宕机时的切换问题:先发现节点故障,再停止向故障节点分配新连接,客户端按退避策略重连健康入口,并由服务端回收旧发布身份,避免同一主播同时占用两个推流会话。
学习目标
- 能为推流入口设置可执行的健康检查、摘除和恢复条件。
- 能设计客户端重连退避、重连地址选择与会话恢复规则。
- 能验证故障切换后旧节点不会继续占用主播的发布身份。
先把故障路径定义清楚
典型源站集群由多个推流入口组成,例如 ingest-a、ingest-b、ingest-c,前面可以放 DNS、四层负载均衡或专用接入调度器。主播建立推流连接后,入口节点负责维持 TCP/TLS、协议会话和发布状态;数据库或共享状态服务保存主播与流名的唯一占用信息。
图片比纯文字更容易说明“发现故障→摘除→重连→旧会话回收”的关系,因此把一次故障切换画成状态流程:
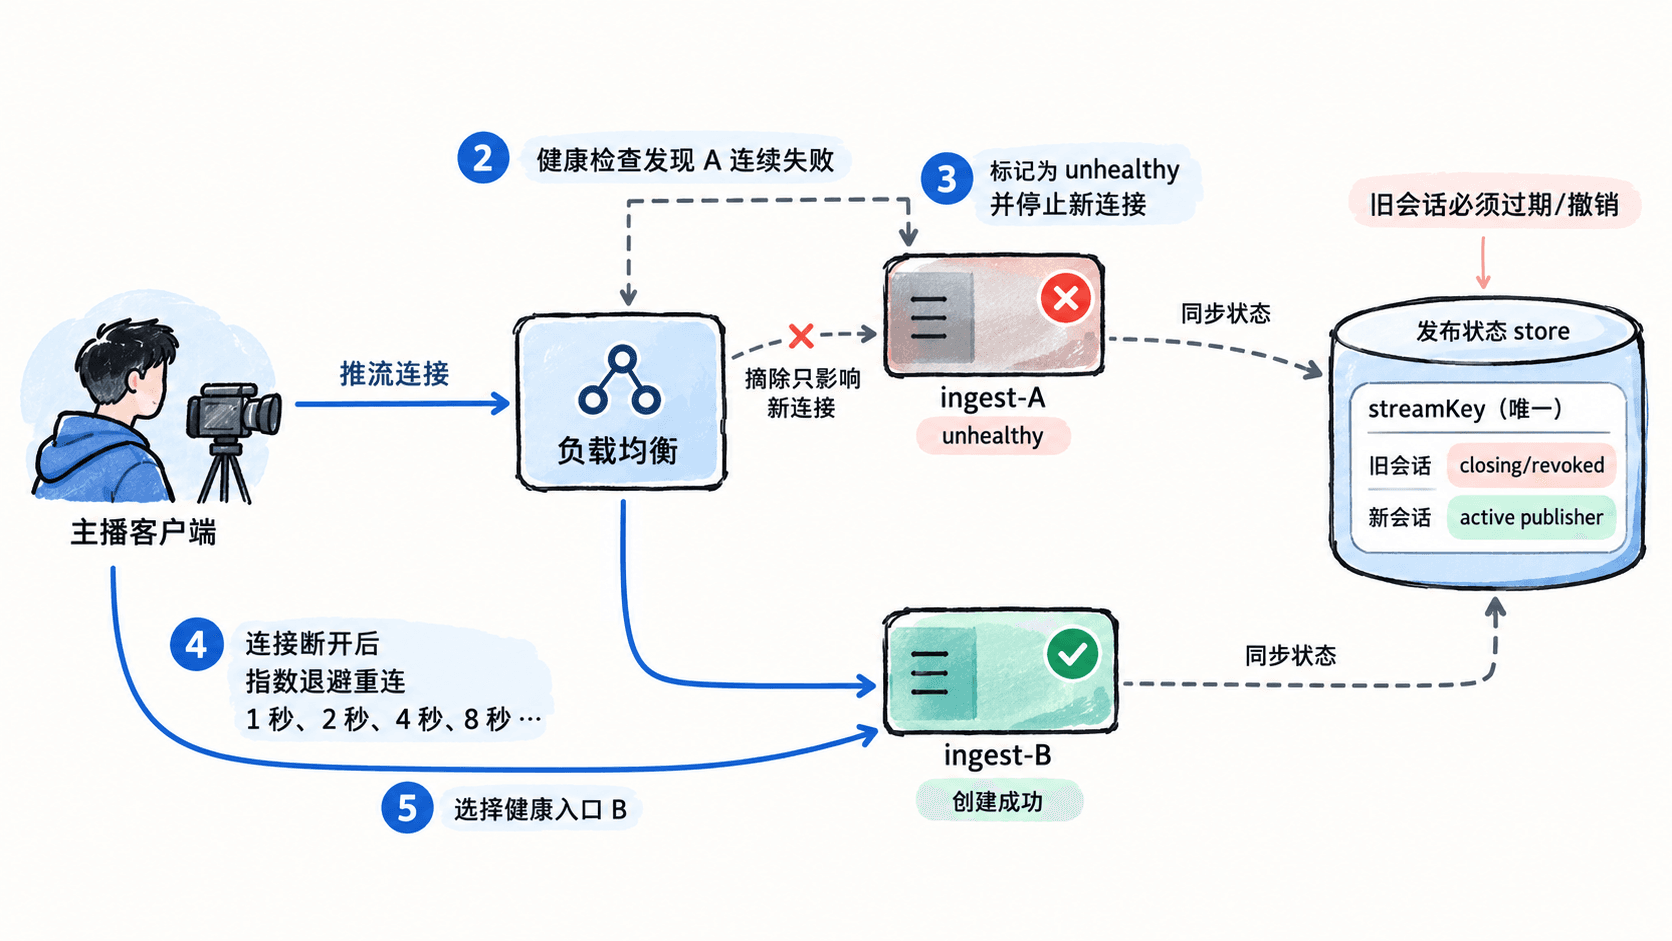
切换的关键不是“把客户端转到另一个 IP”,而是分开处理三个问题:新连接去哪里、旧连接是否还有效、主播发布身份归谁。只做第一项会留下双发布和僵尸会话。
健康检查与入口摘除
健康检查至少分成存活和可接收推流两个层次。进程还活着但磁盘、网络或推流处理线程已经异常时,只看 TCP 端口可能误判健康。
可以采用下面这组起始参数作为生产设计的示例:
| 参数 | 示例值 | 作用 |
|---|---|---|
| 检查周期 | 5 秒 | 每个入口被主动探测一次 |
| 单次超时 | 2 秒 | 超时即判本次失败 |
| 连续失败阈值 | 3 次 | 约 15 秒后摘除 |
| 连续成功阈值 | 2 次 | 约 10 秒后恢复接流 |
| 摘除对象 | 新建推流连接 | 已建立连接单独处理 |
如果入口在 5 秒检查周期下连续 3 次超时,可以把它标为 unhealthy。摘除后不要再给它分配新主播,但不要因为摘除就假设已有连接瞬间消失;已有 TCP 会话通常需要等待连接错误、主动关闭或应用层心跳超时。
检查接口建议返回结构化健康状态,例如 HTTP 200 表示入口具备接流能力,503 表示暂不可接流。不要把“进程端口可连接”直接等同于“推流业务健康”。
curl -i --max-time 2 http://ingest-a:<PORT>/healthz预期结果
HTTP/1.1 200 OK
Content-Type: text/plain

ok
实际端口由部署环境决定;这里的 <PORT> 是占位符。生产环境还应在健康检查中验证推流服务自身的关键依赖,例如发布鉴权、共享状态或必要的本地资源是否可用。
客户端怎样重连才不会形成雪崩
入口故障后,不应让数千个主播同时“立即重连”。推荐指数退避并设置随机抖动,例如基础延迟 1 秒、最大延迟 16 秒:第 1 次等待约 1 秒,第 2 次约 2 秒,第 3 次约 4 秒,第 4 次约 8 秒,第 5 次及以后封顶在 16 秒附近,再叠加少量随机抖动。
一个可执行的重连过程可以这样设计:
- 当前 TCP/TLS 或推流协议连接断开后,把当前入口标记为暂不可用。
- 等待
1s × 2^n,其中第 0 次重试从 1 秒开始,并加入约 0~500 毫秒随机抖动。 - 向调度服务重新获取可用入口,而不是永久重试旧 IP。
- 使用同一个逻辑
streamKey重新鉴权和建立推流连接。 - 新入口确认发布身份创建成功后,再把客户端状态切换为
publishing。
不要在客户端固定写死“失败后永远连接 B”。当 B 也故障,或者故障期间入口列表变化时,这种策略会把局部故障变成持续重试某一台机器。调度层应该返回当前健康入口集合。
旧会话必须主动失效
故障切换里最容易漏掉的是旧节点仍保留发布身份。假设主播 anchor-42 的 streamKey=room-1001 原本在 A 上发布,A 网络故障后客户端连接 B。如果共享状态只记录“最后一次连接到了 B”,而 A 后续恢复并继续发送数据,就可能出现同一流两个活跃发布者。
推荐把发布身份设计成带租约的唯一记录,例如逻辑字段包括 streamKey、sessionId、nodeId、leaseExpireAt。新连接到 B 时,服务端执行“创建或抢占租约”检查:旧租约仍有效则根据故障恢复规则撤销旧会话;新租约成功后,A 即使恢复,也不能继续发送该发布身份的数据。
streamKey=room-1001
oldSession=session-A
newSession=session-B
leaseExpireAt=<TIME>

旧会话处理:REVOKED
新会话处理:ACTIVE
预期结果
同一 streamKey 在共享状态中只有一个 ACTIVE session
oldSession=session-A -> REVOKED
newSession=session-B -> ACTIVE
这类状态转移不能只依赖本地内存。A 和 B 如果各自维护一份“当前主播列表”,网络分区时很容易同时认为自己是主会话。应至少使用一个所有入口都能访问的共享仲裁位置,并让租约具有过期时间,避免节点永久占用身份。
验证故障切换是否真的完成
验收不要只看“客户端重新连上”。至少执行一次完整故障演练:先让主播稳定推流到 A,再阻断 A 的推流服务或网络;观察健康检查在约 15 秒内摘除 A,确认新的主播请求不再进入 A;随后检查客户端按退避重连到 B,并确认共享状态中旧 sessionId 被撤销。
最关键的四个检查点是:A 是否停止接收新连接、B 是否成功建立新发布会话、旧会话是否变为失效状态、恢复后的 A 是否仍会被调度加入。最后再恢复 A,等待连续健康检查成功后让它重新接流,但不要强制正在 B 上发布的主播迁回 A。
常见错误是把“入口摘除”和“现有会话迁移”混为一件事。负载均衡摘除通常只决定以后新连接去哪;已经建立的推流连接要靠客户端重连、服务端租约和会话撤销完成迁移。只有这三部分同时生效,源站集群才能在入口故障后做到可恢复且不重复占用发布身份。