
流媒体与实时通信 / 系统课时
如何用流标识串联全链路日志
如何用流标识串联全链路日志
一次直播卡顿可能出现在推流接入、源站、转码、分发或控制服务。仅凭直播间号检索,容易混入重推流和其他播放请求。本篇建立分层标识与结构化日志约定,并用可运行脚本还原单次发布的媒体路径,定位缺失的处理环节。
学习目标
- 区分直播间 ID、流 ID、发布会话 ID 与请求追踪标识的生命周期。
- 让接入、源站、转码、分发和控制服务能够关联同一次发布。
- 用结构化日志查询路径,并识别重连、CDN 缓存造成的追踪边界。
为每一种标识确定唯一职责
先定义四个主标识,避免让同一个字段同时表示“房间”和“本次推流”。
| 字段 | 表示什么 | 什么时候变化 |
|---|---|---|
room_id |
业务直播间,如 room-1001 |
换直播间才变化 |
stream_id |
房间内的逻辑媒体流,如 camera-main |
换摄像头流或屏幕共享流时变化;同流重推可不变 |
publish_session_id |
一次推流发布会话,如 pub-7e42 |
新建发布会话时重新生成,不能跨重推复用 |
trace_id |
一次控制面或 HTTP 请求的分布式追踪 | 独立请求通常有独立值,不要求整场直播相同 |
room_id + stream_id 适合找业务对象,再加 publish_session_id 才能区分同一流的两次发布。发布会话 ID 应由接入服务在确认新会话时生成,并写入会话注册信息;示例短 ID 便于阅读,生产环境应使用足够随机且全局唯一的标识。
播放器发起 HLS 清单或分片请求时,可以另记 playback_session_id 和该请求的 trace_id。不要把观众的请求追踪 ID 当作推流会话 ID;W3C Trace Context 中的 trace_id 为 32 位十六进制字符串。
沿着真实路径传递业务关联键
发布鉴权通常从控制服务开始;接入服务接受发布后,源站注册、转码任务及分发资源都应能找回同一组业务关联键。它们不必共享同一个 trace_id,尤其媒体包本身不会自动传递 HTTP 追踪上下文。
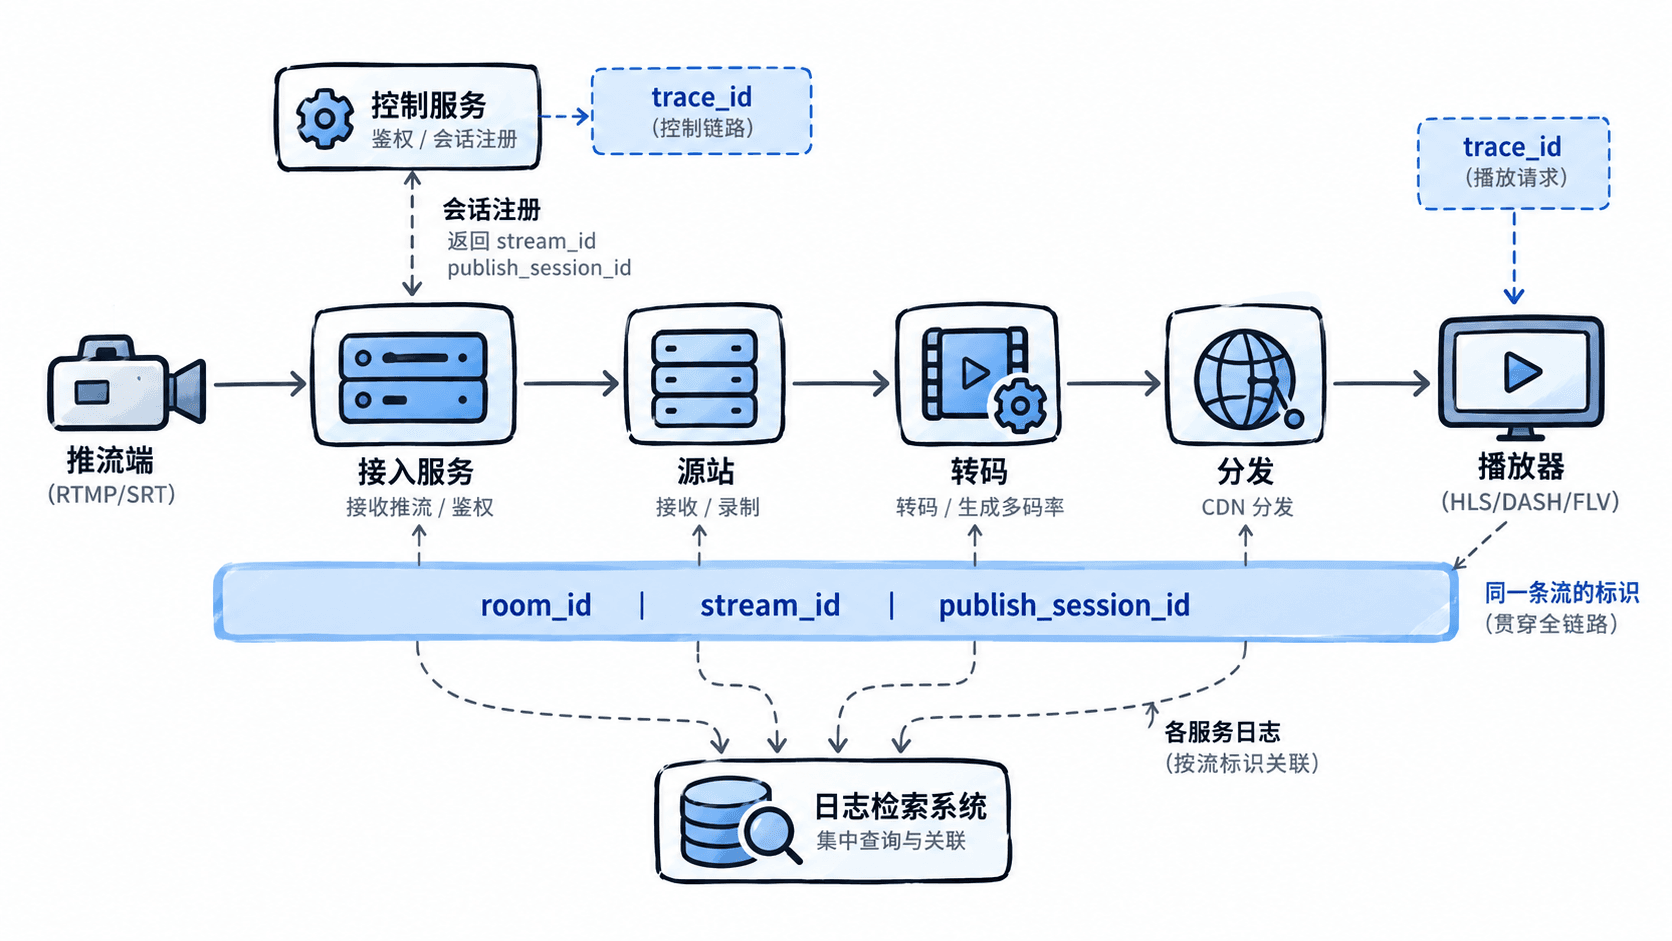
具体接线可以按下列顺序检查:
- 控制服务鉴权发布请求,记录
room_id、stream_id、自身trace_id与鉴权结果;必要时使用服务端会话记录把鉴权结果关联到后续publish_session_id。 - 接入服务在创建发布会话后生成
publish_session_id,将它写入连接日志及流会话注册表,并绑定对应的room_id、stream_id。 - 源站与转码从注册信息或任务消息中取得这三个业务字段,分别记录流注册、任务开始、输出档位就绪以及失败事件。
- 分发服务将播放清单或分片请求映射到对应的流和发布版本,记录请求自己的
trace_id;若是 CDN 缓存命中,源站可能根本没有对应请求日志。
如果使用消息队列下发转码任务,就把关联键放入消息元数据或任务载荷,而不是指望它们出现在音视频编码数据里。
使用结构化字段统一检索
各服务至少统一 timestamp、stage、event、room_id、stream_id、publish_session_id,并根据实际调用补充 trace_id、node、error_code 和 duration_ms。时间统一使用带时区的 ISO 8601 时间戳,便于合并排序。
日志事件名要可检索,例如 publisher_connected、stream_registered、rendition_ready、playlist_served。相较于只打印“转码成功”,带会话字段的 JSON 行能够准确排除上一轮重推产生的旧档位日志。
检索时先固定 publish_session_id,再按 timestamp 看阶段事件;不同机器存在时钟偏差,因此要同步系统时间。不要仅凭“某阶段无日志”就立即判定该阶段未执行,还应确认日志采集是否正常。
跑通一次跨服务日志查询
下面是 Python 3.10+ 的独立演示程序。它模拟五个服务分别产生 JSONL 日志,再按同一次发布会话聚合;实际项目应由各服务在真实事件发生时写入相同字段,而不是集中伪造日志。
import json
from pathlib import Path

identity = {
    "room_id": "room-1001",
    "stream_id": "camera-main",
    "publish_session_id": "pub-7e42",
}
events = [
    ("control", "publish_authorized", "4bf92f3577b34da6a3ce929d0e0e4736"),
    ("ingest", "publisher_connected", None),
    ("origin", "stream_registered", None),
    ("transcode", "rendition_ready", None),
    ("distribution", "playlist_served", "c34c9630c70b4052ac19721e07dc9e47"),
]

path = Path("live-events.jsonl")
with path.open("w", encoding="utf-8") as output:
    for stage, event, trace_id in events:
        # 关联发布用业务键;HTTP 请求的 trace_id 按各自请求记录
        record = {"timestamp": "2026-10-26T09:00:00Z", **identity,
                  "stage": stage, "event": event}
        if trace_id:
            record["trace_id"] = trace_id
        output.write(json.dumps(record, ensure_ascii=False) + "\n")

with path.open(encoding="utf-8") as source:
    rows = [json.loads(line) for line in source]
matched = [row for row in rows
           if row["stream_id"] == "camera-main"
           and row["publish_session_id"] == "pub-7e42"]
print("匹配日志:", len(matched))
for row in matched:
    print(f'{row["stage"]}: {row["event"]}')
将代码保存为 trace_live.py,执行 python trace_live.py。预期输出:
匹配日志: 5
control: publish_authorized
ingest: publisher_connected
origin: stream_registered
transcode: rendition_ready
distribution: playlist_served
脚本会在当前目录生成 live-events.jsonl。两条示例 HTTP 记录的 trace_id 不同,却能借助相同的发布会话键找到同一条业务路径;这正是业务关联与分布式请求追踪的区别。
用断点与重连场景验收
假设控制、接入、源站都记录成功,但同一 publish_session_id 下没有 rendition_ready。先查转码任务是否创建、是否收到携带关联键的消息,再核对转码失败码与任务状态;不要直接认定“转码机器故障”。若分发请求未到源站,则先查 CDN 缓存命中及边缘访问日志。
验收时至少覆盖两次重推:同一 room_id 和 stream_id 对应两个不同 publish_session_id,查询任意一次都不能混入另一轮。再从一条播放请求的 trace_id 找到播放资源映射,并反查发布会话,确保中间映射可追溯。
生产环境应避免记录推流密钥、鉴权 Token、带签名的完整播放 URL 和用户隐私。关键状态变化与错误日志尽量完整保留;高频分片成功日志可采样,但必须明示采样率,否则“没查到日志”不能成为故障结论。