
流媒体与实时通信 / 系统课时
首帧变慢时如何定位链路瓶颈
首帧变慢时如何定位链路瓶颈
首帧突然从 1.2 秒升到 3.8 秒,不能只盯播放器。要把播放器关键时间点与 CDN 命中、源站响应、关键帧和解码初始化串起来,先找出增长最大的阶段,再决定查缓存、媒体链路还是终端。
学习目标
- 能把首帧耗时拆成请求、首包、关键帧、解码等可观测阶段。
- 能用同一个请求标识关联播放器、CDN 与源站日志。
- 能根据时间增量判断主要瓶颈并验证修复是否真正生效。
先把首帧拆成可观测阶段
播放器至少记录 play_click、manifest_ok、first_byte、first_media_segment_ok、keyframe、decode_init、first_frame。实际项目中不要只记录一个 startup_time,否则只能知道“慢了”,不知道慢在哪里。
可以把首帧耗时近似拆成:。这些阶段不一定严格串行,例如网络接收与缓冲可能重叠,因此这套分解主要用于定位增量,而不是把所有指标机械相加。
播放器事件建议统一携带 session_id、play_request_id、stream_id、cdn_cache、edge、source、时间戳。时间统一使用 Unix 毫秒或 RFC 3339,并保证播放器、CDN、源站主机时钟有可靠同步。
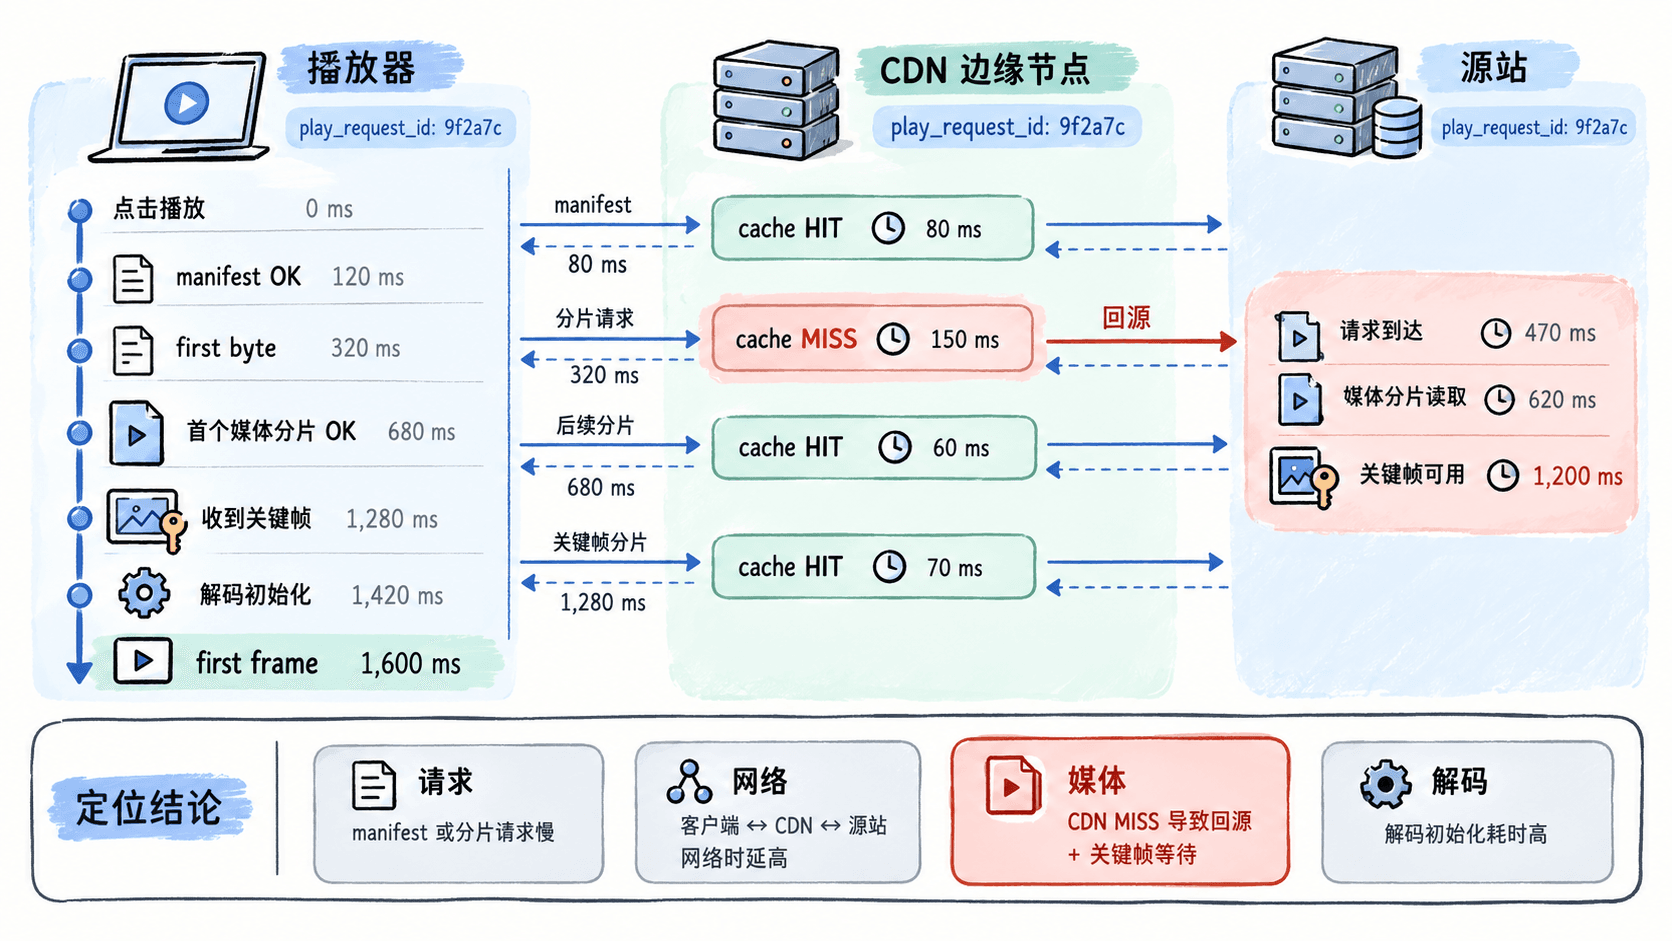
用同一个请求标识串起三侧日志
最容易出错的是播放器、CDN、源站各自有一套时间或 ID,排查时只能凭秒数猜。实际接入时,让播放请求生成一个 play_request_id,播放器把它放入请求头或可透传的查询参数,CDN 日志原样记录,回源请求继续透传给源站。
推荐至少保留这些字段:time、play_request_id、stream_id、edge、cache_status、status、ttfb_ms、upstream_ms、bytes_sent。源站侧再记录 request_arrival、segment_ready、response_complete。这样一次首帧异常可以从播放器反查到具体边缘节点和源站请求。
排查时先按 play_request_id 精确查,再按 stream_id + 时间窗口 聚合。不要先做全站平均,因为首帧问题往往只集中在某个 CDN 节点、线路或直播间。
先区分缓存慢还是源站慢
假设正常请求的首个分片 CDN TTFB 为 80 ms,异常请求为 920 ms。继续看 CDN 日志,如果正常样本是 HIT,异常样本是 MISS,同时 upstream_ms 约 830 ms,那么第一嫌疑就是回源,而不是播放器解码。
一个实用的判断顺序是:
- 看
cache_status是否从HIT变成MISS或BYPASS。 - 看
ttfb_ms是否跟着上升。 - 看
upstream_ms是否占异常 TTFB 的主要部分。 - 再检查源站是否有同一
play_request_id,以及源站响应是否同样变慢。
例如某批请求的平均值如下:
| 阶段 | 正常 | 异常 | 增量 | 初步判断 |
|---|---|---|---|---|
| Manifest TTFB | 110 ms | 130 ms | +20 ms | 非主因 |
| 首个分片 TTFB | 90 ms | 900 ms | +810 ms | 主嫌疑 |
| 关键帧等待 | 650 ms | 720 ms | +70 ms | 次要 |
| 解码初始化 | 180 ms | 200 ms | +20 ms | 非主因 |
这里最大的新增项是首个分片 TTFB,因此优先查 CDN 缓存与回源,而不是先让播放器团队改解码器。
再判断是不是关键帧等待
CDN 快并不代表首帧一定快。直播播放器通常需要拿到能开始解码的关键帧;如果首个收到的媒体数据距离下一个关键帧还有 1.5 秒,即使网络只用了 100 ms,用户仍然会等待。
把“收到首个媒体字节”和“收到可解码关键帧”分开记录非常重要。典型现象是:first_media_segment_ok 基本正常,但 keyframe 到达时间明显后移,此时瓶颈更接近媒体切片、GOP 或等待可解码帧,而不是 CDN TTFB。
例如同一直播流配置中,关键帧间隔约 2 秒;异常采样从收到首个媒体数据到拿到下一关键帧用了 1.8 秒,而正常样本只有 0.7 秒,说明播放器实际上是在“等下一次可解码入口”。这种问题应继续检查编码器关键帧节奏、切片边界以及播放器选段策略,而不是继续调 CDN 超时。
最后排除解码初始化瓶颈
如果网络侧已经确认 first_media_segment_ok 和 keyframe 都没有明显变慢,但 decode_init 到 first_frame 仍增加,例如从 160 ms 上升到 780 ms,就应把重点移到终端。
检查时至少区分三个时间点:收到关键帧、解码器初始化完成、第一帧真正渲染。某些设备的硬件解码器初始化、分辨率切换或音视频轨道协商会带来额外开销。
不要把“视频已经收到”和“用户已经看到画面”视为同一个事件。首帧故障的修复验收也必须同时观察网络和播放器侧两个指标。
用一个小脚本快速找最大增量
下面的 Python 示例直接使用一组归一化后的播放器事件,计算正常与异常样本各阶段耗时,并找出增长最大的阶段。示例中的字段结构可以映射到你的埋点表或日志 ETL 结果。
from statistics import mean

samples = [
    {
        "name": "normal",
        "manifest_ms": 110,
        "segment_ttfb_ms": 90,
        "keyframe_wait_ms": 650,
        "decode_init_ms": 180,
    },
    {
        "name": "incident",
        "manifest_ms": 130,
        "segment_ttfb_ms": 900,
        "keyframe_wait_ms": 720,
        "decode_init_ms": 200,
    },
]

stages = ["manifest_ms", "segment_ttfb_ms", "keyframe_wait_ms", "decode_init_ms"]
normal, incident = samples

for stage in stages:
    delta = incident[stage] - normal[stage]
    print(f"{stage}: normal={normal[stage]}ms incident={incident[stage]}ms delta={delta}ms")

largest = max(
    stages,
    key=lambda stage: incident[stage] - normal[stage],
)
print(f"largest_contribution={largest}")
print(f"incident_total={sum(incident[s] for s in stages)}ms")
预期输出
manifest_ms: normal=110ms incident=130ms delta=20ms
segment_ttfb_ms: normal=90ms incident=900ms delta=810ms
keyframe_wait_ms: normal=650ms incident=720ms delta=70ms
decode_init_ms: normal=180ms incident=200ms delta=20ms
largest_contribution=segment_ttfb_ms
incident_total=1950ms
这段结果说明异常样本最大的新增成本来自首个媒体分片 TTFB。生产环境里再把它与 cache_status、upstream_ms、edge 和 play_request_id 做联表,就能从“播放器变慢”进一步定位到具体 CDN 节点或源站请求。
修复后怎样证明真的好了
不要只看一次播放。修复后至少比较同一流、同一区域、相近时段的正常组和异常组,并同时看 P50、P95、P99。比如 P95 从 3.8 秒降到 1.6 秒,同时 CDN MISS 比例恢复、segment_ttfb_ms 回落到 100 ms 量级,且 keyframe_wait_ms 没有恶化,才可以认为首帧问题主要被修复。
还要做一次反向验证:故意选一个冷缓存节点或已知回源路径,确认链路上的 MISS → upstream → source 关系仍能被日志关联出来。只有异常发生时也能快速复现和定位,监控才真正具备排障价值。
首帧问题的判断顺序可以固定为“播放器时间线 → CDN 命中与 TTFB → 源站回源耗时 → 关键帧等待 → 解码初始化”。每次只优先处理增量最大的阶段,避免看到首帧变慢就直接修改编码参数或播放器逻辑。