
流媒体与实时通信 / 系统课时
低延迟分片如何避免缓存穿透
低延迟分片如何避免缓存穿透
低延迟直播会让边缘节点频繁请求“刚刚应该生成、但实际上还没完成”的分片。若每个请求都直接回源,瞬时并发会被放大到源站;本篇用请求合并、短等待、回源限流和超时四个手段,让未生成分片保持可控。
学习目标
- 能解释低延迟分片未生成时,边缘缓存与源站之间发生了什么
- 能用请求合并和回源并发限制减少同一分片的重复回源
- 能为等待、读取和失败分别设置合理的超时,并验证是否生效
先区分“缓存未命中”和“分片未生成”
普通点播缓存未命中通常意味着“对象已经存在,只是当前节点没有缓存”;直播则多了第三种状态:边缘请求的对象可能还没有在源站生成完。两者处理方式不同。
假设直播分片长度为 1 秒,边缘节点在 t=10.9s 收到 100 个对 seg-011.ts 的请求,而源站预计在 t=11.1s 才完成该分片。如果 100 个请求全部直接回源,就会产生约 100 个上游请求;如果边缘先等待其中一个回源请求完成,其余请求可以复用同一结果。
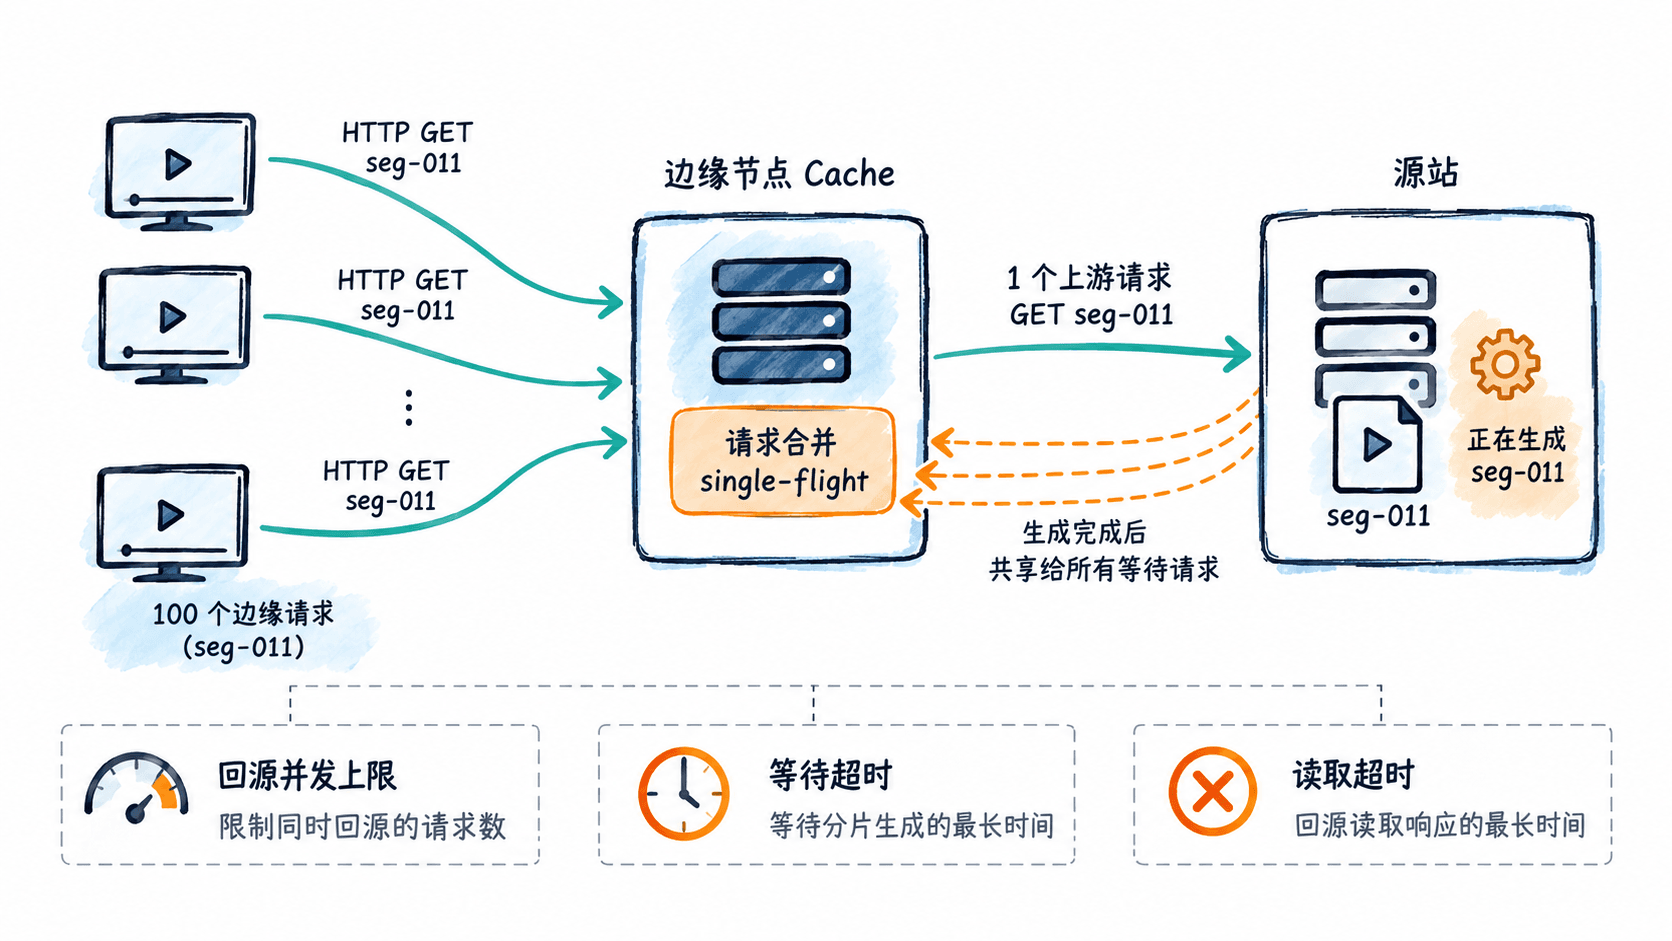
判断是否需要等待时,可以按下面的条件区分:已经生成但未命中缓存,应该尽快回源;明确知道还没生成,则应允许一个短窗口等待;等待窗口结束仍没有对象,就快速失败或返回可重试结果,而不是持续占着上游连接。
用请求合并压住重复回源
以 NGINX 为例,proxy_cache_lock on; 会让同一个缓存键的并发未命中请求围绕一个正在填充缓存的请求等待,而不是全部访问上游。proxy_cache_lock_timeout 控制等待最长时间,proxy_cache_lock_age 则限制锁住期间单个回源请求允许持续多久,超过后可以允许新的回源尝试。
一个适合直播边缘节点的最小配置可以写成:
proxy_cache_path /var/cache/nginx/live levels=1:2 keys_zone=live_cache:100m max_size=10g inactive=30s use_temp_path=off;

server {
    listen 8080;

    location /live/ {
        proxy_cache live_cache;
        proxy_pass http://origin_live;

        proxy_cache_lock on;
        proxy_cache_lock_timeout 200ms;
        proxy_cache_lock_age 500ms;

        proxy_connect_timeout 300ms;
        proxy_read_timeout 1200ms;
    }
}
这里的 200ms 不是“源站必须在 200ms 内生成分片”的硬性要求,而是等待其他请求共享结果的上限。低延迟场景下,等待过长会把观众的播放延迟直接扩大;等待过短则可能让同一分片再次触发回源。应结合分片时长和源站生成抖动实测调整。
预期结果
NGINX 配置检查通过:nginx -t
并发请求同一未命中分片时,首个请求负责回源,其余请求在 proxy_cache_lock_timeout 内等待缓存填充;超时后才进入后续处理。
给源站设置并发上限
请求合并只能降低同一缓存键的重复回源。如果观众同时观看多个直播分片、多个码率,边缘仍可能同时请求 seg-011.ts、seg-012.ts、seg-013.ts 以及不同清晰度对象,所以还需要控制整个边缘节点的回源压力。
可以把容量先换算成一个明确的预算。假设一台源站允许稳定处理 200 个并发媒体请求,而单个边缘节点最多有 50 个并发回源连接,则 4 台边缘同时工作时理论上最多产生 200 个并发回源请求。若再考虑控制面、鉴权和其他流量,实际预算不应直接打满,可以先按 70%~80% 作为生产阈值,例如设置目标上限约 140~160 个有效媒体回源并发。
直播场景里尤其要避免“每个播放器请求一次、源站生成一次”的错误模型。缓存键应包含实际对象身份,例如路径、分辨率和分片序号;对于同一个对象,所有并发请求必须尽量共享同一次回源结果。
用超时把失败限制在边缘
超时至少要拆成三类:连接超时、等待已有回源结果的超时、读取源站响应的超时。三者含义不同。
以 1 秒分片为例,可以先用 300ms 作为连接超时、200ms 作为缓存锁等待时间、1200ms 作为读取超时做基线,然后用真实监控调整。若源站通常 80~150ms 完成分片,200ms 的等待窗口能够覆盖大多数正常抖动;若 p99 经常超过 300ms,就应先检查源站生成耗时,而不是单纯把边缘等待改成 2 秒。
错误做法是把所有超时统一设成 10 秒。这样源站一旦卡住,大量边缘连接会长时间占用连接槽和文件描述符,最终形成级联拥塞。正确做法是让“等待共享结果”的时间短于“完整读取源站”的时间,并让总失败时间低于播放器可接受的重试周期。
验证是否真的阻止了缓存穿透
不要只看缓存命中率。针对同一个尚未生成的直播分片,用并发请求观察三个指标:边缘收到的请求数、源站收到的回源数、最终成功响应数。
例如一次压测发出 100 个并发请求,目标分片只需要一次有效回源。理想结果应接近“边缘 100、源站 1~少量、最终成功 100”;如果源站收到 100 个请求,说明请求合并没有生效或缓存键不一致;如果源站只收到 1 个请求,但 100 个客户端都超时,则需要继续检查分片生成时间与等待窗口的关系。
可直接用 curl 生成一组并发请求做最小验证:
seq 1 20 | xargs -n1 -P20 -I{} curl -sS -o /dev/null -w '%{http_code}\n' 'http://<EDGE_HOST>:<PORT>/live/seg-011.ts'预期输出
200
200
200
200
...
共20行HTTP状态码;在分片已可用且未发生超时的情况下,大多数或全部结果应为200。
进一步检查源站访问日志,同一时间窗口内对完全相同的分片对象,回源次数应明显低于边缘请求次数。若仍接近 20 次,优先检查缓存键、proxy_cache_lock 是否生效,以及响应是否被设置成不可缓存。
最终可以把策略收敛成一条可执行规则:**同一分片只允许少量回源,其他请求短暂等待;超过等待窗口立即结束等待;源站连接和读取也分别设置上限。**这样即使某一批分片生成偏慢,压力也会优先停留在边缘,而不会被成倍放大到源站。