
流媒体与实时通信 / 系统课时
RTP 丢包后如何恢复实时画面
RTP 丢包后如何恢复实时画面
实时视频遇到丢包时,接收端不能简单“等下一个包”:要先用 RTP 序列号确认是否缺包,再用时间戳恢复媒体时间线,并在有限的延迟预算内决定等待、NACK 重传还是直接跳过。本文给出一套可落地的判断方法和参数算例。
学习目标
- 能用 RTP 序列号、时间戳和到达时间区分乱序、丢包与网络抖动。
- 能计算抖动缓冲和 NACK 的等待预算,判断什么时候重传仍然值得。
- 能用一段可运行的模拟程序验证“延迟换完整度”的取舍。
先判断到底丢了什么
RTP 头部中的 sequence number 用来标识包的发送顺序。以 16 位序列号为例,正常接收 1001、1002、1003、1004;如果先看到 1001、1003,只能说明 1002 暂时没有到达,不能立即断定它已经丢失,因为网络可能发生了乱序。
因此接收端通常维护一个“最高已确认序列号”和一个短期抖动缓冲区。若当前最高序列号是 1003,发现 1002 缺口,同时 1003 已经到达但尚未播放,就应先等待一个很短的重排窗口。超过窗口后仍没有 1002,才把它视为丢包并进入恢复逻辑。
RTP timestamp 表示媒体采样时间,不是接收端墙上时钟。以 90 kHz 视频时钟为例,30 fps 视频相邻帧通常相差约 90000 / 30 = 3000 个 timestamp 单位。序列号负责“包的顺序”,timestamp 负责“媒体时间线”,两者不能互相替代。
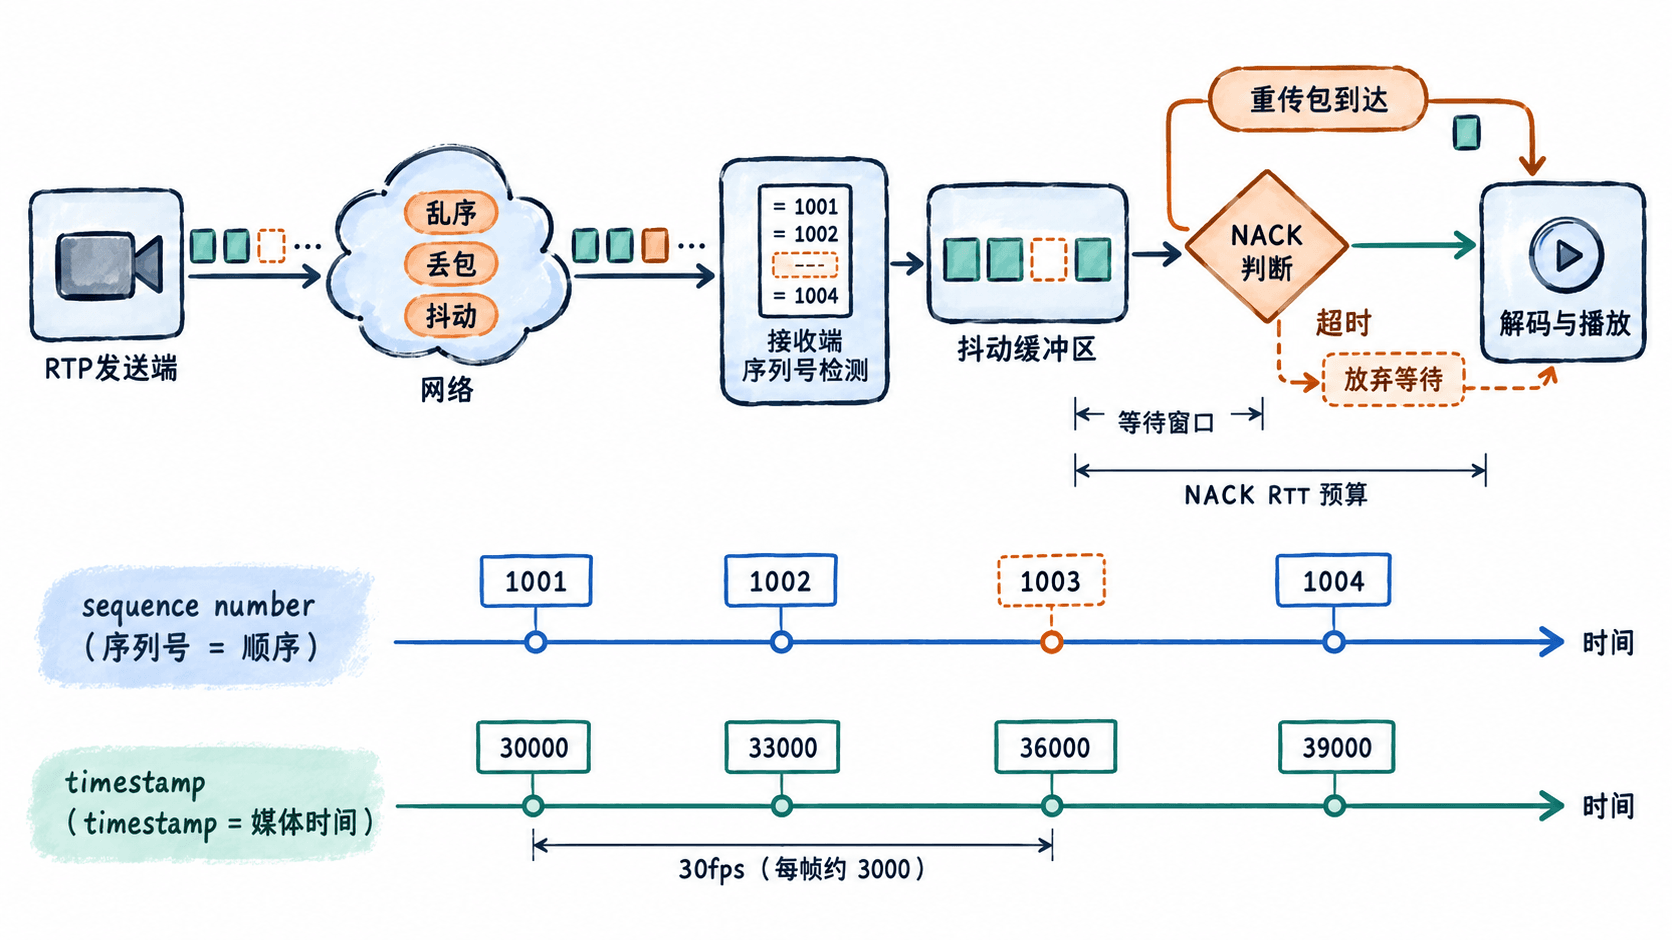
抖动缓冲为什么能救乱序
抖动缓冲器的任务不是永久缓存,而是在“连续播放”和“等待晚到包”之间给出一个有限窗口。假设直播链路目标端到端延迟是 800 ms,其中已经分配 120 ms 给传输与处理、80 ms 给编码解码,那么留给播放侧缓冲的预算约为 600 ms。实际工程中通常还会把这部分预算拆成启动缓冲、正常抖动缓冲和重传等待。
例如当前估算网络 RTT 为 40 ms,媒体包一旦发现缺口后,可以给 NACK 重传预留约 60~100 ms 的等待窗口。若某包在 70 ms 后才回来,但播放器在 50 ms 后就必须继续消费,那么这个包即使重传成功,也已经失去实时播放价值,应丢弃该包并依靠后续完整帧继续播放。
一个实用的检查方法是同时记录四个时间点:send_ts、arrival_ts、play_deadline 和 retransmit_arrival_ts。只比较“是否收到”是不够的,真正决定恢复是否有效的是“收到时是否还来得及进入当前播放点”。
NACK 什么时候值得发
NACK 的目标是告诉发送端“序列号 N 没收到,请重传”。它适合短时、少量丢包,因为重传本身要占用额外带宽并增加接收端等待。
可以先用一个简单预算判断:设当前缺失包的播放截止时间为 D,当前时间为 now,预测重传往返消耗为 RTT + R,其中 R 是发送端排队、编码封装和网络发送的额外时间。只有当
时,NACK 才有较高概率赶在播放点之前生效。比如 now=120 ms、RTT=40 ms、R=20 ms、D=220 ms,则预计 180 ms 到达,仍有 40 ms 的余量,可以重传;如果 D=160 ms,即使立刻发送 NACK 也来不及,应直接丢弃缺失包,不要为了“理论完整”继续堆积延迟。
还要限制 NACK 重复发送。例如同一个缺口在 20 ms 内连续收到多个后续包时,不应为同一个序列号无限发送请求。工程上通常会记录最近一次 NACK 时间,并设置重试次数或总等待上限。
用程序模拟恢复决策
下面的 Python 示例不依赖第三方库,只模拟接收端看到的 RTP 序列号,并根据重排窗口判断“等待”还是“确认丢包”。它不负责解码 RTP 媒体,但可以直接验证序列号检测和 NACK 决策逻辑。
from dataclasses import dataclass

@dataclass
class Packet:
    seq: int
    arrival_ms: int

REORDER_WINDOW_MS = 60
NACK_RETRY_MS = 40

packets = [
    Packet(1001, 0),
    Packet(1003, 18),  # 1002 先缺失,可能只是乱序
    Packet(1002, 42),  # 在重排窗口内到达
    Packet(1005, 105), # 1004 长时间未到达
]

highest_seq = 1000
waiting = {}
last_nack = {}

def seq_distance(a: int, b: int) -> int:
    # RTP 序列号是 16 位,差值需要考虑回绕。
    return (a - b) & 0xFFFF

for packet in packets:
    missing = []
    distance = seq_distance(packet.seq, highest_seq)

    if 0 < distance < 0x8000:
        for seq in range(highest_seq + 1, packet.seq):
            waiting.setdefault(seq, packet.arrival_ms)
            missing.append(seq)
        highest_seq = packet.seq

    for seq in list(waiting):
        age_ms = packet.arrival_ms - waiting[seq]
        if age_ms >= REORDER_WINDOW_MS:
            last = last_nack.get(seq, -NACK_RETRY_MS)
            if packet.arrival_ms - last >= NACK_RETRY_MS:
                print(f"NACK seq={seq}")
                last_nack[seq] = packet.arrival_ms
        elif age_ms > 0:
            print(f"WAIT seq={seq} age={age_ms}ms")

    if packet.seq in waiting:
        print(f"RECOVER seq={packet.seq} after reordering")
        del waiting[packet.seq]
预期结果
WAIT seq=1002 age=24ms
RECOVER seq=1002 after reordering
NACK seq=1004这段模拟展示了两个不同结局:1002 在 60 ms 重排窗口内到达,因此不需要 NACK;1004 长时间没有到达,超过窗口后才进入 NACK。真实 RTP 接收器还需要处理序列号回绕、重复包、多个连续缺口以及媒体帧边界。
丢包严重时不要无限重传
当丢包率从偶发的 0.1%~1% 上升到持续拥塞状态时,NACK 会形成反馈放大:接收端不断请求重传,发送端增加带宽,拥塞更加严重,后续丢包继续增加。此时应优先保护实时性,而不是追求每个 RTP 包都恢复。
一个常见的处理顺序是:先给少量缺口保留短重排窗口;确认缺包后发送一次 NACK;在仍有播放预算时允许一次重试;超过截止时间就跳过缺失数据,并让解码器等待后续可用的关键帧或可恢复参考链。
判断系统是否配置合理,可以同时看三项指标:NACK 成功率、NACK 带来的额外播放延迟、丢包后的可播放帧恢复率。例如一个 30 fps 直播系统里,如果 NACK 成功率只有 20%,但每次恢复又让端到端延迟增加 150 ms,继续扩大抖动缓冲通常比收益更差;应先检查链路拥塞、发送缓存和关键帧间隔。
实际项目中,RTP 恢复策略可以概括成一句可执行的规则:**先用序列号发现缺口,再用时间戳判断媒体连续性,最后用播放截止时间决定是否值得等重传。**这样即使网络短时抖动,也不会为了恢复一个已经过期的包把整个直播链路拖慢。