
流媒体与实时通信 / 系统课时
流服务过载时如何限流与降级
流服务过载时如何限流与降级
当连接数、转码 GPU 和回源带宽同时逼近上限时,继续放量会让排队、超时和重试把压力继续放大。本篇给出一套可直接落地的容量阈值、拒绝顺序、非关键能力关闭和优先级调度方案,让系统先保护存量直播,再牺牲低优先级新请求。
学习目标
- 能用连接数、转码利用率和回源带宽判断过载等级。
- 能设计“先拒绝什么、再关闭什么”的限流与降级顺序。
- 能用监控命令验证限流是否生效,并定位过载传播的主要入口。
先找出真正的瓶颈
直播源站通常同时受三类资源约束:长连接数量、转码算力、出口或回源带宽。三者中任意一项达到硬上限,都可能让其他资源跟着失效。例如一台源站最多稳定承载 10000 条长连接、8 张转码 GPU、40 Gbps 回源带宽时,不应把 10000、8 张、40 Gbps 当成可持续工作点,因为还要留出连接波动、健康检查、故障切换和突发重试的余量。
实际项目可以先设置一个保护区间:连接数达到 8500 条进入告警,9000 条开始拒绝低优先级新连接;GPU 平均利用率连续 30 秒超过 85% 时暂停低优先级转码任务;回源带宽达到 32 Gbps 进入保护态,超过 36 Gbps 时停止非必要回源。具体阈值应按压测得到的稳定工作点调整,而不是照抄这些数字。
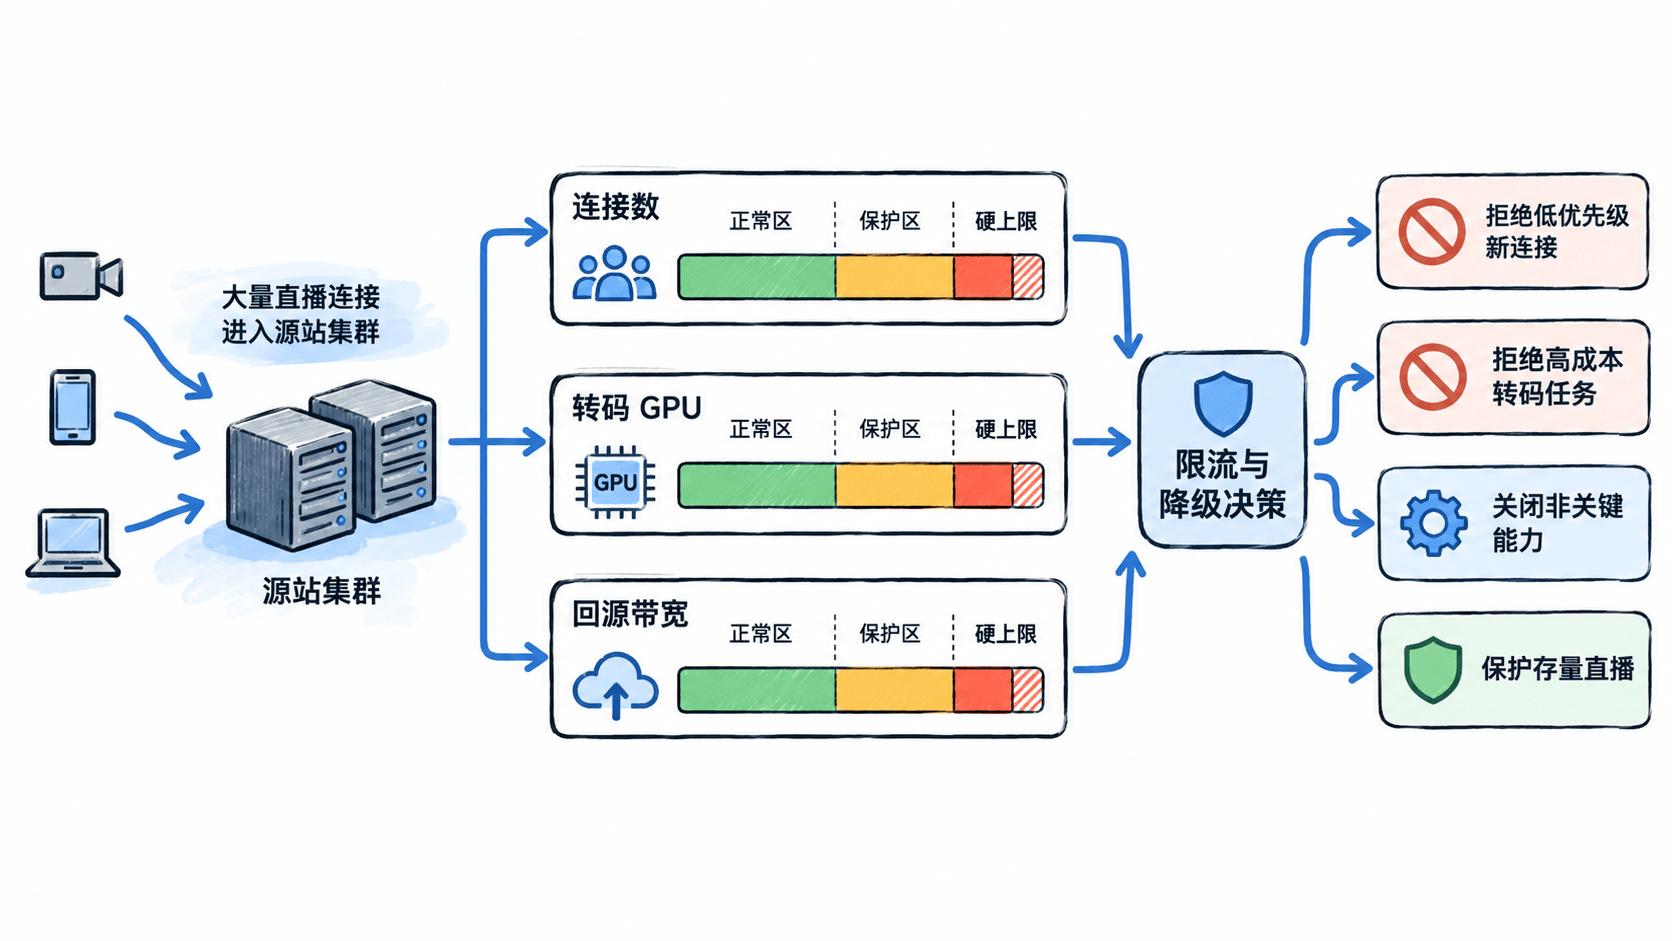
判断过载时不要只看单一指标。假设当前有 9100 条连接、GPU 利用率 89%、回源 34 Gbps,此时虽然三项都还没有达到绝对上限,但已经进入明显保护区,应优先限制新进入流量,而不是等其中一项打满后再处理。
按资源类型实施限流
连接数过载时,最有效的动作通常是限制“新连接”,而不是主动踢掉已经稳定播放的用户。可以把用户请求按业务优先级分为核心直播、普通直播、低优先级测试或临时任务三档。连接数超过 9000 后,核心直播继续接入,普通直播按固定比例拒绝,低优先级请求直接拒绝;只有持续回落到 8000 以下一段时间后,才逐步恢复放量,避免在临界点反复开关。
转码过载时,应优先拒绝新增的高成本任务。例如一个输入流需要同时生成 1080p、720p、480p 三路输出,而当前 GPU 已经长期超过 85%,可以先停止新任务中的 1080p 超清转码,只保留 720p 和 480p;已经在播的任务不要因为一次短时尖峰全部重启,否则重启会产生新的 GPU 峰值。
回源带宽过载时,优先减少非必要回源。对已经有稳定缓存或可以复用已有中间结果的内容,避免重复拉流;对低优先级内容可以延后回源,而核心直播保持实时链路。错误做法是所有请求统一 429 或统一超时,这会把本来应该保住的核心业务一起打掉。
设计降级顺序
降级要按“用户影响最小、释放资源最快”的顺序执行。一个适合直播源站的顺序是:
- 先拒绝低优先级的新连接和新转码任务,不动存量直播。
- 关闭弹幕聚合、非关键录制、额外清晰度生成等辅助能力。
- 对普通直播限制码率、清晰度或并发输出数量,减少单路资源成本。
- 继续保留核心直播的 ingest、转码和播放关键路径。
- 只有硬上限持续触发时,才执行更激进的熔断或实例摘除。
例如当前源站 GPU 总利用率达到 92%,新增任务队列还有 180 个。不要继续接受 180 个任务后再排队;应立即停止低优先级任务入队,并把队列上限压到 50。这样做的目标不是让队列清零,而是避免“排队越来越长→等待时间越来越长→客户端重试→更多请求进入”的反馈环。
用优先级调度保护核心流
建议为请求定义明确的优先级分数,例如核心大型直播为 100,普通商业直播为 70,测试流为 30。资源紧张时只允许系统调度分数不低于当前阈值的任务,而不是让所有队列先进先出。
假设当前可用 GPU 算力只能再接收 3 个高成本任务,但等待队列中有 2 个核心直播、3 个普通直播、10 个测试流。此时应该先接受 2 个核心直播,再从普通直播中选 1 个;测试流全部延后或拒绝。恢复阶段也不要一次性把所有低优先级任务放回队列,而应按每 10 秒一个小批次逐步恢复。
这样做还有一个重要收益:当部分实例故障时,系统可以把剩余容量继续给高优先级流,而不是被大量低价值重试占满。真正可用的保护策略必须明确“谁先被拒绝”,否则所谓优先级只是监控页面上的一个字段。
观察结果并验证是否止住传播
过载保护开启后,至少同时观察拒绝率、新建连接速率、GPU 利用率、回源带宽、转码队列长度和核心直播错误率。理想结果不是所有指标同时降到最低,而是低优先级请求先下降,核心业务保持稳定,资源曲线随后回落。
Linux 上可以直接检查当前连接数量:
ss -Htan state established | wc -l预期输出
8421这里的 8421 只是示例,实际值取决于当前实例。若限流前为 9500、开启保护后逐步降到 8400~8500,说明连接入口已经受到控制;若连接数不降反升,应继续检查是否存在客户端重试、健康检查异常或其他入口绕过限流。
转码节点可以用 nvidia-smi 查看 GPU 使用情况:
nvidia-smi --query-gpu=index,utilization.gpu,memory.used,memory.total --format=csv,noheader预期输出
0, 78 %, 6144 MiB, 16384 MiB
1, 81 %, 6656 MiB, 16384 MiB
如果拒绝新转码任务后 GPU 仍长期高于 90%,不要急着继续加限流规则,应确认是否存在存量任务泄漏、异常重试或单任务成本过高。反过来,如果 GPU 已经降到 60% 左右而核心直播延迟和错误率仍没有恢复,瓶颈很可能已经转移到网络、存储或下游服务。
一个可操作的验收标准是:保护触发后,低优先级新请求在 1~2 个监控周期内明显下降;核心直播成功率不随之同步恶化;资源指标开始远离硬上限;保护解除后按小批次恢复,而不是瞬间恢复全部流量。满足这四点,说明限流与降级已经从“拒绝请求”真正变成了防止局部过载向全链路传播的保护机制。