
流媒体与实时通信 / 系统课时
SRT 如何在弱网推流中恢复丢包
SRT 如何在弱网推流中恢复丢包
本篇用一个可验证的本地实验拆解 SRT 在 UDP 之上如何通过序号、ACK/NAK、重传和接收端延迟缓冲恢复丢包,并用 0%、1%、5% 丢包率比较连续播放能力,最后给出贡献链路选型阈值。
学习目标
- 能解释 SRT 的丢包检测、重传与延迟缓冲为什么必须一起工作。
- 能用固定的
latency、码率和丢包率做一组可重复的弱网实验。 - 能根据恢复窗口、额外带宽和端到端延迟判断是否采用 SRT。
SRT 如何把 UDP 变成可恢复的媒体传输
SRT 仍然使用 UDP 承载媒体包,但在应用协议层维护发送序号与接收确认。接收端发现序号缺口后发送 NAK,请求发送端重传;ACK 则用于确认连续接收进度和辅助发送端清理重传缓存。因此,网络瞬时丢包不会直接等价于播放器立刻出现缺帧。
真正决定“能不能恢复”的是恢复时间是否小于播放截止时间。假设发送端发出序号 100、101、102,接收端先收到 100 和 102,就能发现 101 缺失并请求重传。若 101 在播放到该位置之前补回,媒体可以连续输出;若补回太晚,迟到的数据即使完整,也失去了实时播放价值。
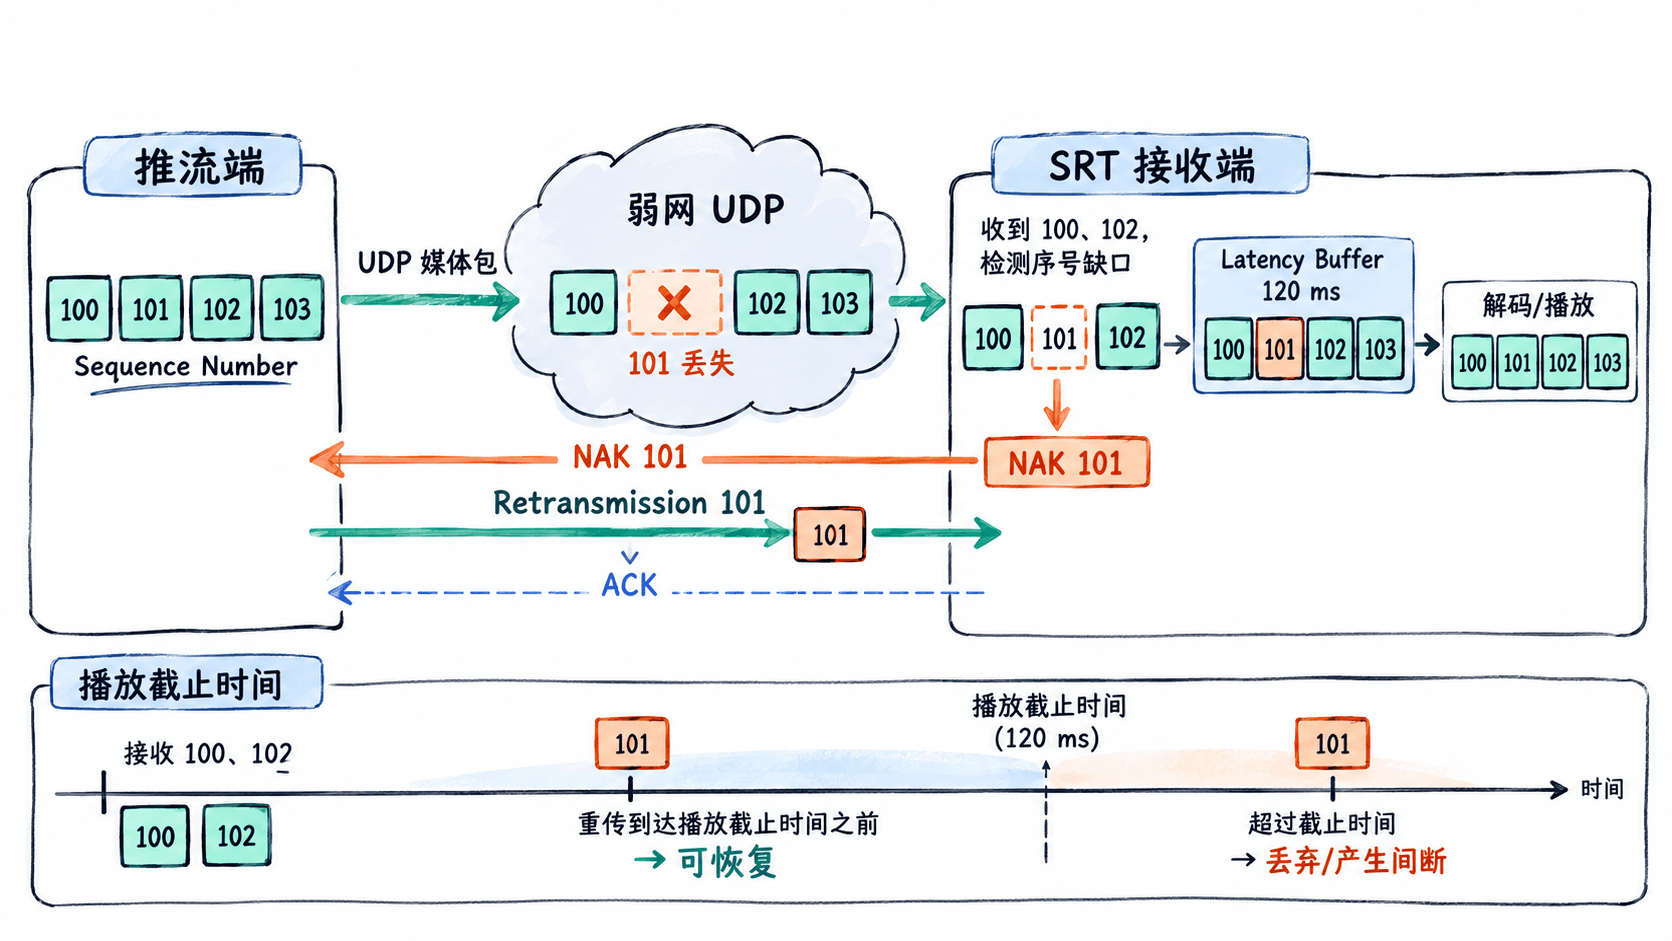
SRT 的延迟参数不是“网络 RTT 的简单放大倍数”,而是接收端为乱序、重传和抖动预留的播放时间预算。工程上可以先把链路 RTT 记为 ,再为抖动和重传留出余量;例如 RTT 约 40 ms、瞬时抖动约 20 ms 时,将 latency=120000(120 ms)作为实验起点通常比 40 ms 更有恢复空间,但最终仍要用真实网络统计验证。
用固定参数做弱网实验
本地实验可以让发送端以 MPEG-TS 推送测试视频,接收端使用 FFplay 或 FFmpeg 从 SRT 拉流。为避免把“编码问题”误判成“传输问题”,先固定视频源、帧率、码率和 GOP,再只改变网络丢包率。
建议第一组参数固定为:H.264 约 4 Mbit/s、30 fps、latency=120000、pkt_size=1316。丢包率依次测试 0%、1%、5%,每档至少运行 60 秒,并记录是否出现持续卡顿、恢复时间和接收端日志中的重传迹象。
下面是一组适合 Linux 环境的最小实验。它假设机器已经安装带 SRT 支持的 FFmpeg,并通过本机 lo 回环接口模拟丢包;tc netem 需要管理员权限。
set -e

# 接收端先启动,监听 9000 端口
ffplay -hide_banner "srt://127.0.0.1:9000?mode=listener&latency=120000"
预期结果
FFplay 打开窗口并持续播放接收到的 MPEG-TS 视频;若发送端尚未启动,接收端保持等待连接。实际发送实验时,在另一终端先清理并设置网络条件,再启动发送端:
sudo tc qdisc replace dev lo root netem loss 1%
ffmpeg -hide_banner -re -f lavfi -i testsrc=size=1280x720:rate=30 -t 60 -c:v libx264 -preset veryfast -b:v 4M -f mpegts "srt://127.0.0.1:9000?mode=caller&latency=120000&pkt_size=1316"
sudo tc qdisc del dev lo root
预期结果
FFmpeg 持续发送 60 秒测试视频;接收端在存在少量丢包时仍应尽量维持连续播放。实验结束后 tc qdisc 被删除,回环接口恢复默认队列。这个实验只验证“链路存在丢包时 SRT 是否仍能保持媒体连续性”,不能直接推出公网表现。生产环境应把网络条件放到真实贡献链路或独立网络仿真环境,并同时记录 RTT、抖动、实际丢包率和发送码率。
丢包率、延迟与带宽开销怎么一起看
可以先用一个固定的 4 Mbit/s 视频做工程估算。若网络对媒体包的随机丢失率为 ,SRT 需要为重传准备额外发送量,粗略的一阶估算是每秒额外重传流量约为 ;但真实开销还受到突发丢包、控制包、重传失败和拥塞控制影响,因此不能把这个乘积当作精确带宽预算。
| 丢包率 | 原始媒体码率 | 一阶重传量估算 | 工程观察重点 |
|---|---|---|---|
| 0% | 4 Mbit/s | 0 Mbit/s | 基线延迟与稳定性 |
| 1% | 4 Mbit/s | 约 0.04 Mbit/s | 少量丢包能否无感恢复 |
| 5% | 4 Mbit/s | 约 0.20 Mbit/s | 是否出现重传拥塞与持续卡顿 |
例如同一条 4 Mbit/s 贡献流,若公网峰值可用上行只有 4.3 Mbit/s,那么 5% 丢包时即使一阶重传量只有约 0.2 Mbit/s,也已经明显压缩了码率余量;实际 SRT 发送速率还会受到协议控制和网络拥塞影响,所以这种链路很容易从“偶发丢包可恢复”变成“重传越多越拥塞”。
另一个关键变量是 latency。在 1% 丢包下,120 ms 的恢复窗口可能足够覆盖一次 RTT 加抖动;到了 200 ms、300 ms,并不意味着画质自动变好,而是给乱序和迟到重传更多生存时间,同时把实时性继续向后推。因此调参时应该同时看恢复成功率和端到端延迟。
什么时候贡献链路值得用 SRT
对于演播室到云端、现场车到中心机房、跨公网跨区域的贡献链路,SRT 的优势在于它把“UDP 的低开销”和“可恢复的媒体传输”结合起来。特别是在网络存在随机丢包、抖动或链路质量波动,而业务又不能接受 TCP 长时间队头阻塞时,SRT 很适合作为贡献传输层。
可以采用下面的判断标准:先做 10~15 分钟连续压测;在目标码率下模拟或采集真实的平均丢包率、95/99 分位 RTT、抖动和可用上行。若主要问题是瞬时丢包,且允许增加约 100~300 ms 级别的贡献链路延迟,SRT 通常值得进入候选方案;若业务要求极低延迟、几乎没有重传时间预算,或者网络已经接近满载,则应谨慎,不能仅因为“支持重传”就直接采用。
典型错误是只看播放器“还能播”就认为链路健康。正确做法是同时记录丢包率、重传量、RTT、延迟缓冲和实际播放延迟,因为 SRT 可能成功隐藏了瞬时丢包,却已经付出了更高的带宽和时延成本。最终是否采用 SRT,应由这组指标共同决定,而不是由单次播放是否黑屏决定。