
流媒体与实时通信 / 系统课时
转码任务积压时如何控制队列
转码任务积压时如何控制队列
当转码输入速率持续高于处理能力时,队列会从短暂波动变成持续增长,最终耗尽内存、磁盘或 worker。本文用“测量输入速率 → 设置有界队列 → 隔离工作进程 → 实施背压与过期丢弃”的方式,把队列控制成可预测的系统,并给出一组可以直接落地的阈值。
学习目标
- 能用输入速率、平均处理时间和 worker 数判断队列是否会持续增长。
- 能设计有界队列、worker 隔离、优先级和过期任务策略,避免积压拖垮源站。
- 能用监控指标和最小实验验证扩容、降级与丢弃策略是否生效。
先算清队列为什么会增长
设转码任务平均到达速率为 ,单个 worker 的平均处理能力为 ,worker 数为 。当 时,系统长期没有足够余量消化输入,队列长度会持续增加。只增加队列容量不能解决这个问题,只会把故障延后。
例如直播系统每秒产生 12 个转码任务,每个 worker 平均每秒处理 2 个任务,当前只有 4 个 worker,则总处理能力为 8 个任务/秒,净增长为 4 个任务/秒。即使队列允许暂存 240 个任务,也只够吸收约 60 秒的持续积压。
生产环境通常把目标设为低于满载运行,例如让 长期保持在 0.7~0.8。这样突发流量到来时仍有处理余量。不要把“CPU 还有 10% 空闲”直接当作扩容依据,因为转码还会受到解码器、编码器、磁盘 I/O、GPU 会话数等资源限制。
用有界队列阻止无限堆积
队列应设置明确的最大长度或最大等待时间。一个简单的计算方法是:允许最多积压 30 秒,输入速率峰值按 20 个任务/秒计算,则队列至少需要容纳约 600 个任务;随后还要根据单任务大小、消息序列化开销和 broker 内存上限做安全余量。
更稳妥的策略是同时限制数量和年龄,例如“最多 600 个任务,且等待超过 30 秒就进入过期处理”。这样可以避免少量超大任务占满空间,也避免队列里堆积已经失去业务价值的直播片段。
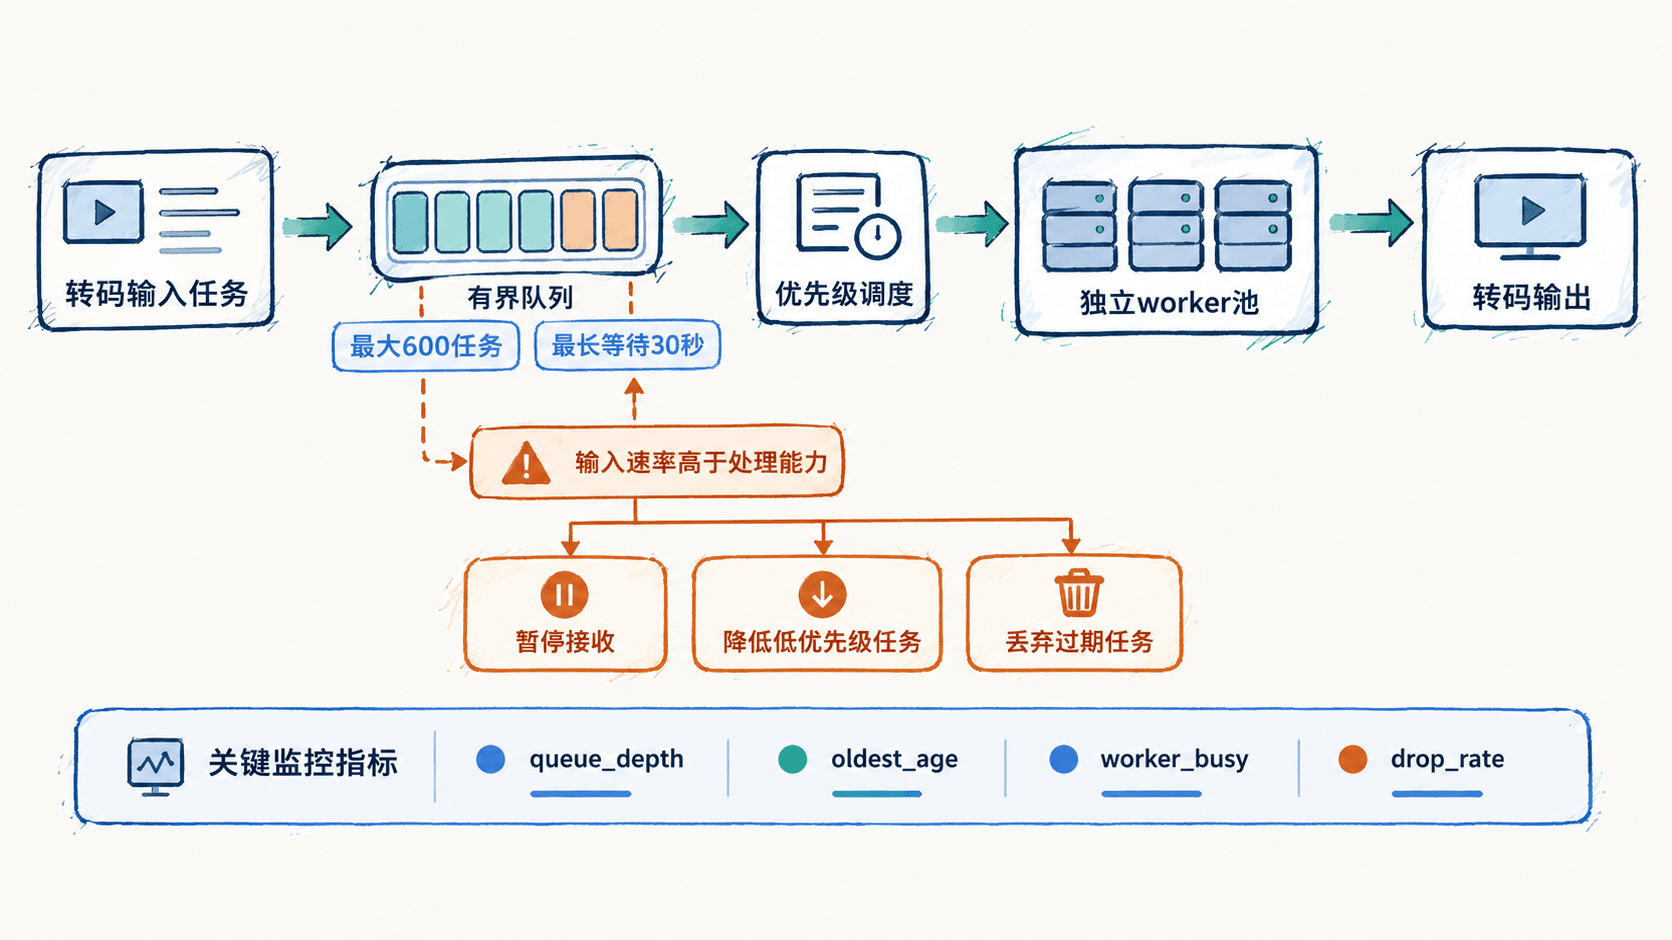
如果使用 Redis Streams、RabbitMQ 或其他消息系统,具体参数名称会因产品不同而变化,但原则一致:生产端不能无限制地把任务写入下游。以 Redis Streams 为例,可以先限制消费端并发,再由业务层判断消息年龄;不要仅依赖 Redis 内存淘汰策略,因为那属于存储层保护,无法表达“这条直播转码任务已经没有播放价值”。
隔离 worker,避免一类任务拖垮全部转码
将任务按资源或业务价值拆成独立 worker 池。例如实时播放转码、录制归档转码、低优先级缩略图转码分别使用不同队列。实时播放队列即使出现峰值,也不应等待一批历史录制任务完成后才能执行。
建议至少建立两级优先级:实时播放任务为高优先级,录制与回放任务为低优先级。高优先级 worker 池预留固定容量,例如总共 10 个 worker 时,8 个服务实时流,2 个服务后台任务;突发期间可以临时让后台池缩到 1 个,但不要让后台任务无限抢占实时池。
常见错误是“所有任务共用一个 FIFO 队列”。假设队头有 20 个归档转码任务,每个平均耗时 5 秒,而新来的实时转码只需 1 秒;共享 FIFO 会让实时任务等待约 100 秒。拆队列后,实时任务可以直接进入专用 worker 池。
背压、扩容和丢弃要按顺序使用
当 queue_depth 连续上升时,先确认是否只是短时尖峰。如果预计 1~2 分钟内会恢复,可以依靠有界队列吸收;如果连续 5 分钟增长,则应进入扩容或降级流程,而不是继续扩大队列。
可以把控制逻辑固定成下面的判定顺序:
queue_depth < 300且oldest_age < 10s:正常处理,不限流。queue_depth ≥ 300或oldest_age ≥ 10s:增加 worker,前提是 CPU、GPU、解码器会话和带宽仍有余量。- 扩容后连续 60 秒仍增长:限制低优先级生产速率,例如暂停新归档转码。
oldest_age ≥ 30s且任务包含播放时效要求:拒绝或丢弃过期任务,并记录原因。- 实时任务也持续超时:进入业务降级,例如只保留主码率,暂停 1080p/60fps 等高成本档位。
不要用“随机丢任务”作为第一手段。丢弃应优先针对已经超过业务截止时间的任务,并保留 stream_id、任务创建时间、丢弃原因和优先级,便于事后统计。
用最小实验验证控制策略
下面的 Python 示例模拟“12 个任务/秒输入、4 个 worker、每个 worker 每秒处理 2 个任务”的持续积压场景,并在队列达到阈值后触发保护。代码只使用 Python 标准库,Python 3.9+ 可运行。
import time
from collections import deque

INPUT_RATE = 12          # 每秒进入的任务数
WORKERS = 4
PER_WORKER = 2           # 每个 worker 每秒处理的任务数
MAX_QUEUE = 60
DROP_AGE = 5             # 等待超过 5 秒视为过期

queue = deque()
created_at = deque()

for second in range(1, 8):
    for _ in range(INPUT_RATE):
        queue.append(second)
        created_at.append(second)

    capacity = WORKERS * PER_WORKER
    for _ in range(min(capacity, len(queue))):
        queue.popleft()
        created_at.popleft()

    dropped = 0
    while len(queue) > MAX_QUEUE:
        queue.pop()
        created_at.pop()
        dropped += 1

    while created_at and second - created_at[0] > DROP_AGE:
        queue.popleft()
        created_at.popleft()
        dropped += 1

    oldest_age = second - created_at[0] if created_at else 0
    print(f"t={second}s queue={len(queue)} oldest_age={oldest_age}s dropped={dropped}")
预期输出
t=1s queue=4 oldest_age=0s dropped=0
t=2s queue=8 oldest_age=1s dropped=0
t=3s queue=12 oldest_age=2s dropped=0
t=4s queue=16 oldest_age=3s dropped=0
t=5s queue=20 oldest_age=4s dropped=0
t=6s queue=24 oldest_age=5s dropped=0
t=7s queue=24 oldest_age=5s dropped=8
这个实验的重点不是模拟真实转码耗时,而是验证一个控制事实:输入速率 12 高于处理能力 8 时,队列必然增长;加入“最大队列 + 最大年龄”后,系统会停止无限吞吐债务,并明确统计被丢弃的任务。
看哪些指标才能判断真的恢复
至少监控 queue_depth、oldest_age、任务处理耗时、worker 忙碌率、扩容后处理速率和 drop_rate。其中 oldest_age 往往比单纯的队列长度更能反映直播体验,因为队列只有 100 个任务并不一定有问题,关键在于这些任务是不是已经等待了 2 秒还是 2 分钟。
验收时可以制造一个高于处理能力的输入压测,例如把输入速率从 8 提高到 12 个任务/秒,持续 120 秒。合格结果应是:队列达到上限后不再无限增长;高优先级任务仍能获得固定 worker 容量;过期任务按规则被拒绝或丢弃;恢复到 8 个任务/秒以下后,oldest_age 和 queue_depth 能持续下降。若只看到队列从 600 增长到 1000,再扩大到 2000,说明系统只是把故障推迟了,并没有真正实现背压。