
流媒体与实时通信 / 系统课时
强制停播如何在媒体集群内生效
强制停播如何在媒体集群内生效
强制停播不是把数据库里的直播状态改成“停止”就结束,而是要让业务指令可靠到达正在承载流的媒体节点,并阻止旧连接重新发布,同时把最新状态推给订阅端。本文用一条可验证的停播链路把这些环节串起来。
学习目标
- 能区分业务控制面、媒体节点和播放订阅端各自负责什么。
- 能设计带幂等、版本号和超时处理的踢流与禁发机制。
- 能按“命令是否送达、节点是否执行、客户端是否收到新状态”的顺序定位集群不一致。
先把停播拆成三件事
强制停播至少要同时完成停止当前媒体会话、禁止同一直播再次发布、通知订阅端状态变化。三件事的状态源可以不同,但最终必须收敛到同一个直播版本。
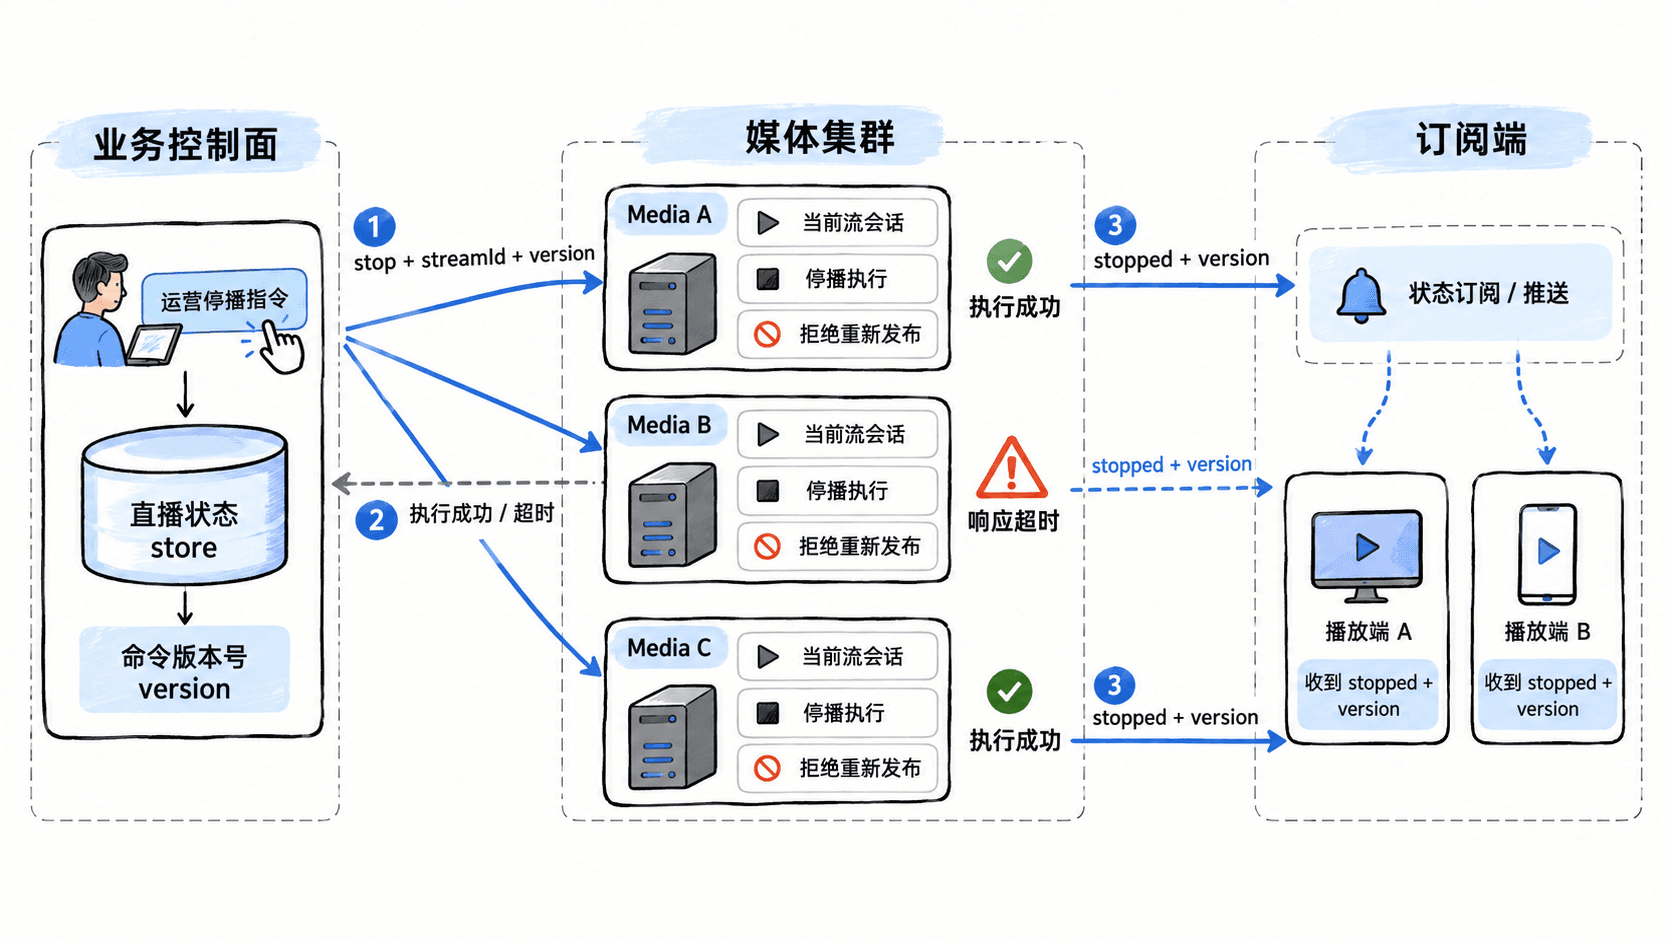
例如直播间 room-42 当前由 Media A 承载,运营在控制台点击停播后,控制面产生命令 stop(room-42, version=18)。这个命令需要传播到真正持有流会话的节点;只更新业务数据库而不通知 Media A,流仍可能继续推送。
更稳妥的状态模型是把“直播业务状态”和“节点会话状态”分开:业务侧记录 STOPPING、STOPPED 等控制状态,媒体侧记录当前会话是否存在;禁止重新发布则单独根据最新版本或封禁状态做入口校验。
用版本号和幂等保证最终收敛
集群中最容易出错的是旧命令晚到。例如 stop version=18 已经执行,网络重试又送来一个 start version=17。如果节点只看“最后收到的消息”,旧命令可能把已经停掉的流重新拉起来。
节点处理命令时应先比较版本号:只接受不小于本地已处理版本的命令;重复收到同一版本的 stop 直接返回当前结果,不再次创建副作用。这样即使消息重复投递,也不会重复踢流或重复刷新状态。
推荐至少记录这些字段:streamId、commandId、version、action、issuedAt、expiresAt。commandId 用于幂等,version 用于解决乱序,过期时间用于限制长期积压命令。
一个最小可运行的模型如下,它只模拟媒体节点的状态机,但可以直接验证“重复命令”和“旧命令晚到”两个关键边界。
from dataclasses import dataclass

@dataclass
class MediaNode:
    active: bool = True
    blocked: bool = False
    version: int = 0

    def apply(self, action: str, version: int) -> str:
        if version < self.version:
            return f"ignored old version={version}"

        self.version = version
        if action == "stop":
            self.active = False
            self.blocked = True
            return f"stopped version={version}"
        if action == "start":
            if self.blocked:
                return f"rejected start version={version}"
            self.active = True
            return f"started version={version}"
        raise ValueError(f"unsupported action: {action}")


def main() -> None:
    node = MediaNode()
    print(node.apply("stop", 18))
    print(node.apply("stop", 18))
    print(node.apply("start", 17))
    print(node.active, node.blocked, node.version)


if __name__ == "__main__":
    main()
预期输出:
stopped version=18
stopped version=18
ignored old version=17
False True 18真实媒体集群还需要把这个状态机接到会话管理和发布入口。踢流解决当前连接,封禁/拒绝发布解决断线重连;只有做了后者,用户不断重新推流时才不会出现“刚踢掉又上线”的循环。
节点不一致时按控制面、执行面、订阅面排查
先查控制面是否生成了唯一命令,再查命令是否到达承载节点,最后查订阅端是否收到更新。不要一上来重启整个媒体集群,否则会把真正的传播问题掩盖掉。
- 控制面:确认直播间状态已经从
LIVE进入STOPPING或STOPPED,并记录本次commandId与version=18。如果这里没有记录,优先修业务事务或命令发布逻辑。 - 传播层:检查命令队列、RPC 或内部 HTTP 调用是否返回成功;区分“请求发出”和“节点确认执行”,不要用 HTTP 200 自动代表停播已完成。
- 媒体节点:在承载节点上确认当前
streamId会话已经关闭,并确认发布鉴权入口开始拒绝新的连接。若只关闭会话,没有改变封禁状态,重连后仍会恢复。 - 集群收敛:对所有已知承载节点核对相同的
version。某节点停在17,而控制面已经是18,说明命令传播失败、消费积压或节点状态持久化异常。 - 订阅端:确认推送的状态版本不低于播放器当前版本。客户端收到
stopped version=18后应停止播放、清理重连定时器;迟到的旧状态不能把界面重新改成“直播中”。
可以把一次操作的验收标准固定成三个条件:当前流不存在、重新发布被拒绝、订阅端最终显示停止。只满足第一个条件,强制停播仍然可能在几十秒后恢复。
处理超时、重复执行与部分成功
媒体集群里经常出现“2 个节点成功、1 个节点超时”。这时不要把整体结果简单写成失败,也不要因为一个超时就无限重试。控制面应记录每个节点的执行结果,并对未确认节点进行有限次数的幂等重试。
推荐把节点响应分成三类:SUCCESS 表示已执行;ALREADY_STOPPED 表示目标状态已经成立;TIMEOUT 表示尚未确认。前两类都可以视为业务上的成功收敛,只有 TIMEOUT 需要继续追踪。
当出现“控制台已停播、部分节点仍在播、播放器还显示直播中”时,最有价值的排查顺序不是重试所有请求,而是沿着同一个 commandId 和 version 逐段追踪。只要能回答“命令是否生成、是否到达、是否执行、是否被旧状态覆盖”,通常就能把问题定位到控制面、传播层、媒体节点或订阅层中的一个明确边界。