
流媒体与实时通信 / 系统课时
控制平面如何向媒体节点下发指令
控制平面如何向媒体节点下发指令
本课解决直播控制服务与媒体节点状态不一致的问题。你会用“期望状态—命令—实际状态”三层模型设计下发链路,并处理确认、超时重试、幂等和最终收敛,避免重复关流或路由切换造成状态抖动。
学习目标
- 能区分控制平面的期望状态、媒体节点实际状态和命令执行结果
- 能设计带命令 ID、超时和有限重试的下发机制
- 能用状态回报校正控制面的记录,并验证系统最终收敛
先把三种状态分开
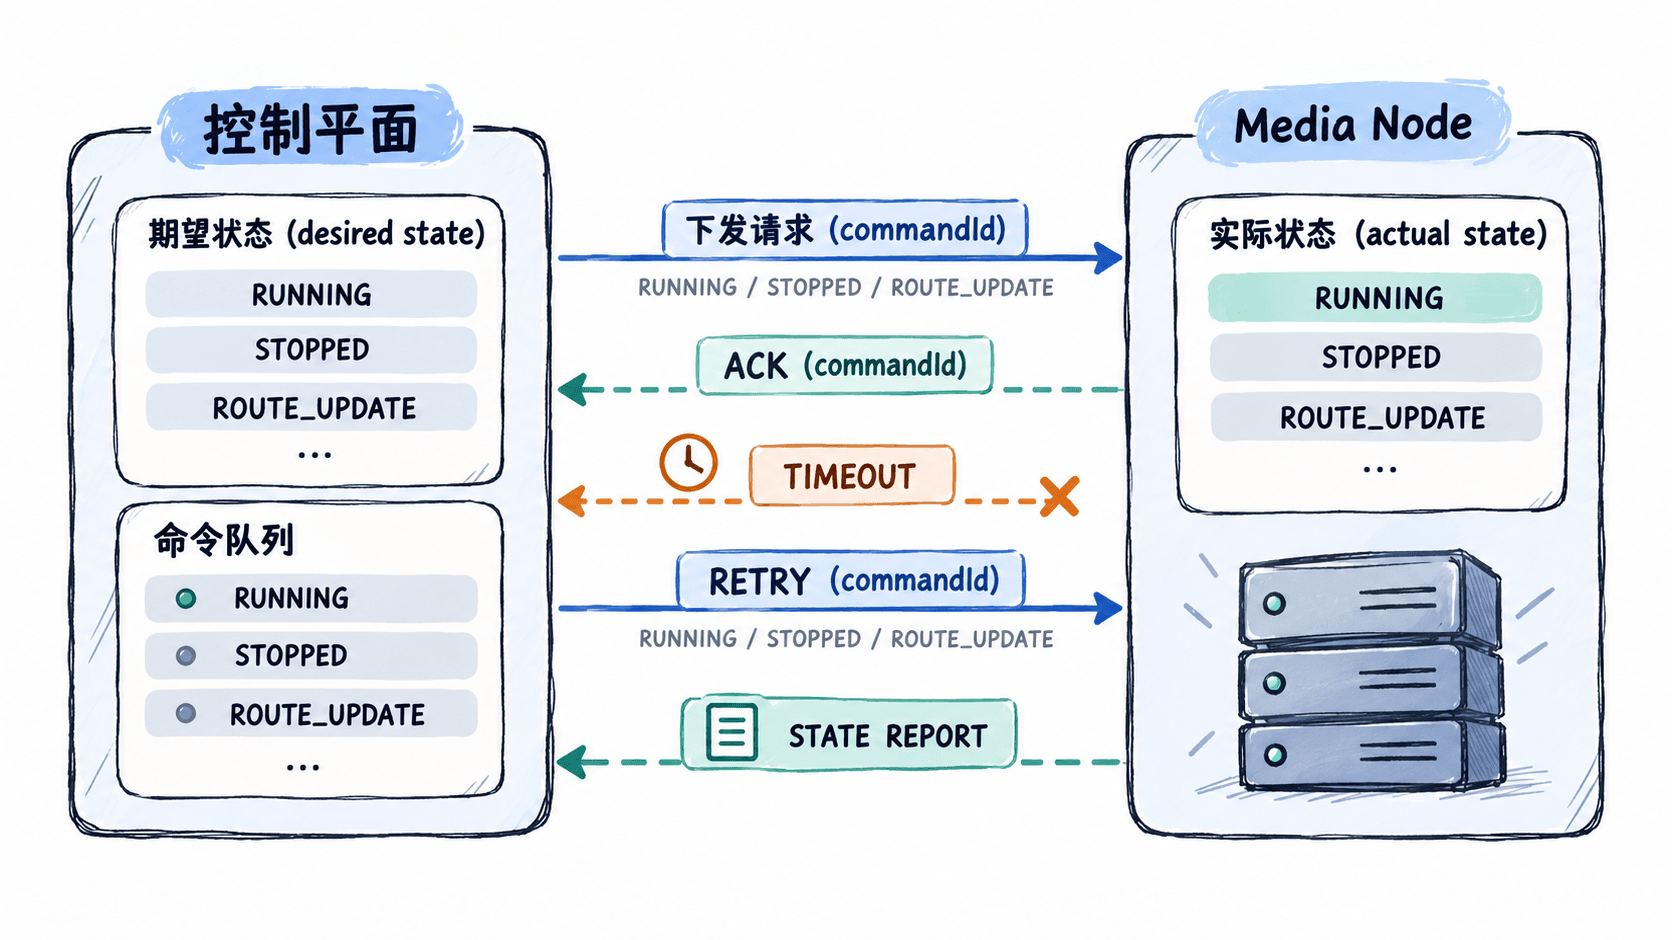
直播系统里不要把“数据库里写成了关闭”和“媒体节点已经关闭”当成同一件事。控制服务保存的是期望状态,媒体节点暴露的是实际状态,两者之间通过带唯一命令 ID 的操作连接。
一个正在直播的流可以记录为:desired=RUNNING、actual=RUNNING。运营侧点击停播后,控制服务先把期望状态改成 STOPPED,再向选定媒体节点发送 StopStream。此时如果网络中断,状态可能短暂变成 desired=STOPPED、actual=RUNNING,这不是异常数据,而是正在收敛的状态。
下发链路怎么设计
推荐把一次控制操作拆成五个可检查的阶段:
- 控制服务生成全局唯一
commandId,例如cmd-8f31,并记录目标流、目标节点、命令类型和期望版本。 - 将命令写入可重试的队列或持久化任务表,状态先记为
PENDING。 - 媒体节点收到命令后,先按
commandId做幂等检查,再执行STOP、ROUTE_UPDATE等动作。 - 节点返回
ACK,但 ACK 只表示“命令已接收或执行完成”的协议结果,最终是否生效仍以状态回报为准。 - 控制服务收到状态回报后,用版本号或状态时间戳更新实际状态;当
desiredVersion == actualVersion时标记为已收敛。
这里最容易犯的错误是收到超时就直接再次执行业务动作。正确做法是先重发相同的 commandId,由媒体节点幂等处理;这样即使第一次命令已经执行,只是 ACK 丢失,也不会再次触发副作用。
超时重试与幂等
假设内部链路的正常响应通常低于 300 ms,可以将单次 ACK 超时设为 1 s,最多重试 3 次,并采用 1 s、2 s、4 s 的退避。超过上限后不要继续无限重试,而是进入 UNKNOWN 或 FAILED,等待节点状态回报或人工干预。
一个最小可运行的 Node.js 示例用固定 commandId 模拟“ACK 丢失后重试但不重复执行”。适用于 Node.js 18+。
const executed = new Set();

async function sendCommand(command) {
  if (executed.has(command.commandId)) {
    return { ack: true, duplicate: true, state: "STOPPED" };
  }

  executed.add(command.commandId);
  // 首次执行真正改变媒体节点状态。
  return { ack: true, duplicate: false, state: "STOPPED" };
}

async function main() {
  const command = {
    commandId: "cmd-8f31",
    streamId: "live-1001",
    action: "STOP"
  };

  const first = await sendCommand(command);
  const retry = await sendCommand(command);

  console.log(first);
  console.log(retry);
}

main().catch(console.error);
预期结果
{ ack: true, duplicate: false, state: 'STOPPED' }
{ ack: true, duplicate: true, state: 'STOPPED' }
示例中的 duplicate=true 说明重试命中了同一个命令记录,而不是重新执行一次停流动作。生产环境通常把幂等记录放在 Redis、数据库或节点本地持久状态中,而不是进程内 Set,否则服务重启后会丢失去重信息。
状态收敛怎么验收
控制平面至少要记录 desiredVersion、actualVersion、commandId、updatedAt 和最后一次错误原因。以同一条直播流为例,停播后可以出现如下过程:
| 时间 | 期望状态 | 实际状态 | 命令状态 | 处理 |
|---|---|---|---|---|
| T0 | RUNNING | RUNNING | IDLE | 正常 |
| T1 | STOPPED | RUNNING | PENDING | 等待下发 |
| T2 | STOPPED | RUNNING | TIMEOUT | 触发重试 |
| T3 | STOPPED | STOPPED | ACKED | 节点已执行 |
| T4 | STOPPED | STOPPED | CONVERGED | 关闭控制任务 |
验收时不要只检查控制服务返回 200。至少还要检查媒体节点确实不再接受该流的发布数据、状态回报已经变成 STOPPED,并且对应 commandId 不会再次触发执行。
哪些情况下不能继续重试
如果节点返回“流不存在”且状态查询也确认 actual=STOPPED,这类错误可以直接视为幂等成功,不应继续重试。相反,网络超时、连接重置这类结果属于未知执行结果,必须先通过状态查询判断第一次请求是否已经生效。
还有一种典型错误是两个控制操作同时作用于同一条流,例如 STOP 和 ROUTE_UPDATE 并发发送。可以为每条流维护单调递增的期望版本,只允许节点接受不低于当前版本的命令;旧版本即使晚到,也只能被拒绝或标记为过期。这样控制面的“最后一次有效意图”不会被网络乱序覆盖。
实际生产设计里,命令队列负责“把意图送到节点”,状态回报负责“证明节点最终做到了什么”,而版本号和幂等键负责防止重复、乱序和迟到命令破坏状态收敛。