
流媒体与实时通信 / 系统课时
RTCP 反馈如何驱动拥塞控制
RTCP 反馈如何驱动拥塞控制
本篇把“接收端反馈”落到发送端码率决策:从丢包、往返时间和接收速率估计出当前网络状态,再决定加码、降码还是暂缓调整,最后用可计算的例子识别排队延迟和过度降码率。
学习目标
- 看懂 RTCP Receiver Report 中的丢包、抖动和时间信息如何成为发送端的控制信号。
- 能用一个可执行的简化控制器,把丢包率、RTT 和估计带宽转换为目标发送码率。
- 能区分“真正拥塞”“无线抖动”和“编码输出过低”,避免因为一次丢包就大幅降码率。
RTCP 反馈里哪些数据真正有用
在 RTP 直播链路中,接收端通常通过 RTCP Receiver Report 反馈接收质量。发送端重点关注累计丢包数、最高序列号扩展后的接收进度、到达间隔抖动以及用于 RTT 计算的时间戳字段。RTCP 本身不规定一个所有实现都必须采用的单一“目标码率算法”,实际控制器会把这些观测量转换成自己的拥塞状态。
最容易直接计算的是丢包率。假设一个统计窗口内应收到 10,000 个 RTP 包,实际少了 120 个,则估算丢包率约为 。但 1.2% 并不等于必须立即把视频码率砍半,还要结合 RTT 是否上升、接收吞吐是否下降以及丢包是否连续发生。
RTT 更适合观察“队列是否开始堆积”。例如基础 RTT 约 40 ms,随后在 3 个反馈周期内上升到 55、90、150 ms,同时接收速率从 6.0 Mbps 降到 4.5 Mbps,这比“单次丢了几个包”更能说明链路正在形成排队拥塞。
从反馈到发送端决策
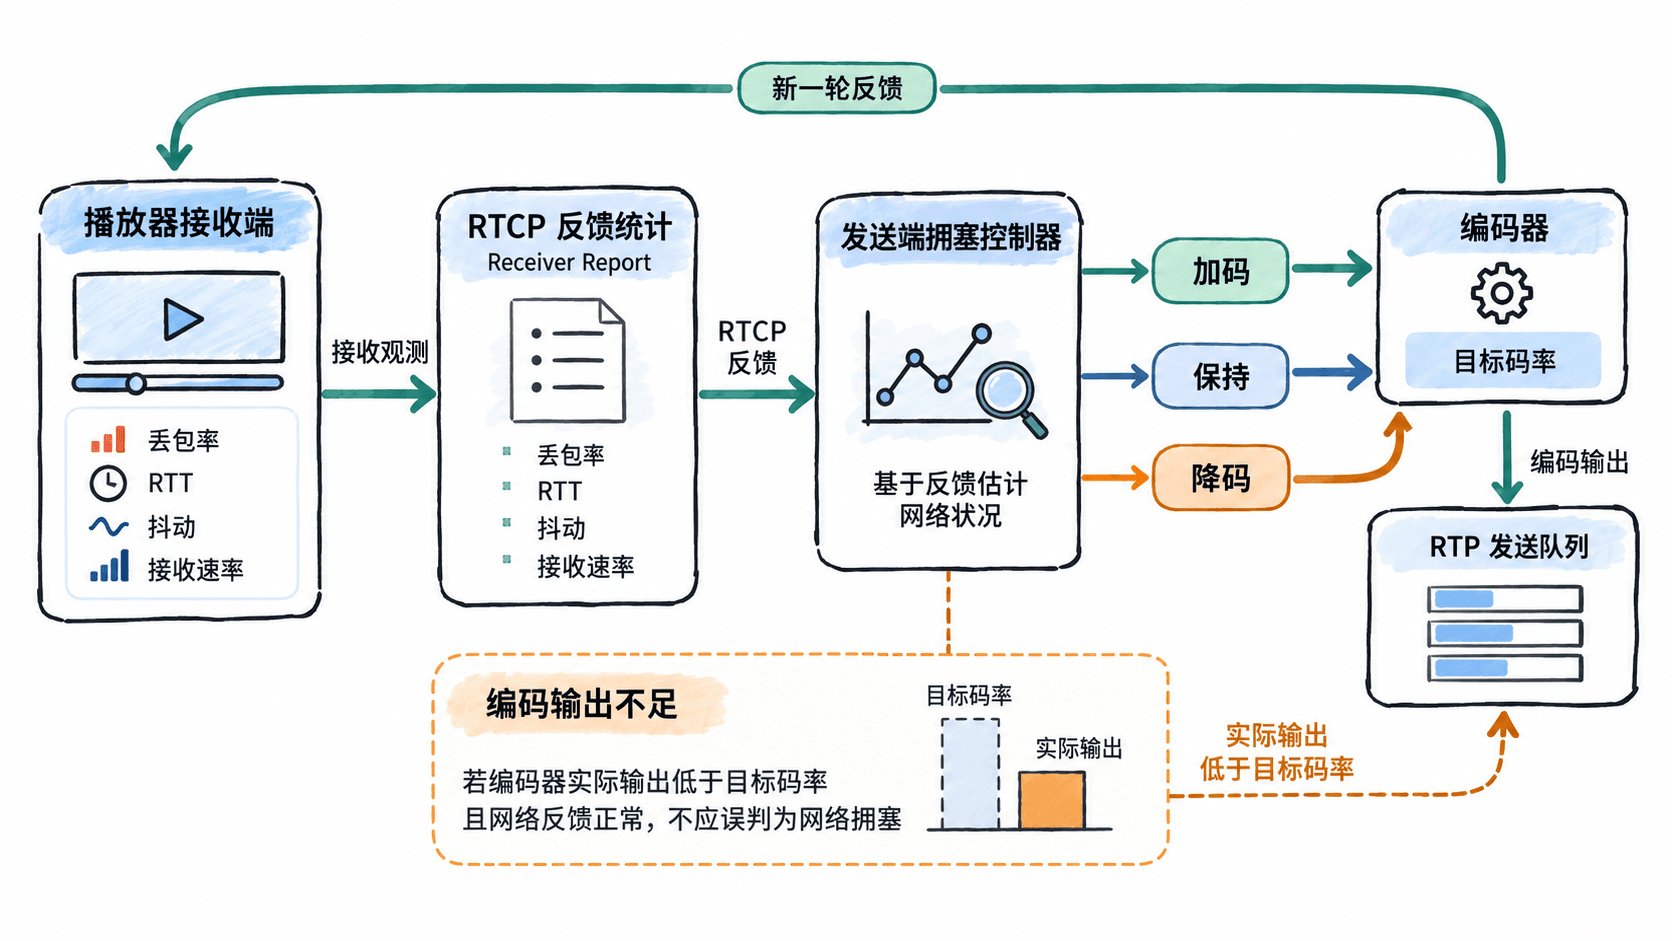
一个实用的判断顺序是:先确认反馈是否持续,再看 RTT 与接收速率是否共同恶化,最后才决定幅度。只看到 1 次 0.5%~1% 的随机丢包时,可先保持;若丢包连续升高且 RTT 同步上升,则进入降码率状态;如果 RTT 稳定、接收速率稳定,而编码器本身只能产出 1.8 Mbps,就不应把 1.8 Mbps 当成网络拥塞证据。
用反馈计算一个可执行的码率调整
下面用一个简化的控制器演示决策过程。它不是 WebRTC、GCC 或其他标准算法的完整实现,而是教学用的可运行模型:把丢包率、RTT 与带宽估计作为输入,并用“快降、慢升”的原则限制振荡。真实系统还会加入时间平滑、趋势检测、发送队列、带宽探测和媒体层联动。
假设当前发送码率为 4.0 Mbps,带宽估计为 5.2 Mbps。若丢包率达到 4%,并且 RTT 已从 50 ms 升到 120 ms,则同时满足“丢包偏高”和“延迟明显增长”,目标码率可以先按 0.70 的比例降到 2.8 Mbps,再观察下一反馈周期,而不是连续多次立即砍半。
from dataclasses import dataclass


@dataclass
class Feedback:
    loss_rate: float          # 例如 0.04 表示 4%
    rtt_ms: float
    base_rtt_ms: float
    bandwidth_mbps: float


def update_bitrate(current_mbps: float, feedback: Feedback) -> float:
    """教学用的快降慢升控制器,不代表具体标准算法。"""
    rtt_ratio = feedback.rtt_ms / feedback.base_rtt_ms

    # 丢包较高且 RTT 明显上升,优先快速降码率。
    if feedback.loss_rate >= 0.03 and rtt_ratio >= 1.5:
        target = current_mbps * 0.70
    # 反馈正常且还有明显带宽余量,缓慢增加,避免振荡。
    elif feedback.loss_rate < 0.01 and rtt_ratio < 1.25:
        target = min(current_mbps * 1.10, feedback.bandwidth_mbps * 0.90)
    else:
        target = current_mbps

    return round(max(0.5, target), 2)


feedback = Feedback(
    loss_rate=0.04,
    rtt_ms=120,
    base_rtt_ms=50,
    bandwidth_mbps=5.2,
)

print(update_bitrate(4.0, feedback))
预期输出:
2.8这个例子中,RTT 是基础值的 倍,丢包率又达到 4%,因此触发降码。下一周期不能机械地继续乘 0.70,而应重新读取反馈;否则 4.0 → 2.8 → 1.96 → 1.37 Mbps 的连续快速下降,会把本来仍可用的带宽浪费掉。
为什么会出现过度降码和排队增长
两种错误方向都很常见。第一种是“见丢包就重降码”:无线网络短暂干扰造成 1 个反馈周期的丢包,发送端立即大幅降到很低,随后链路恢复却又缓慢升码,最终表现为画质长期偏低。修正方法是对反馈做时间平滑,并要求丢包、RTT 或接收速率至少有两个信号一致恶化。
第二种是“只看编码器目标码率,不看发送队列”。例如编码目标为 6 Mbps,但网络实际只能稳定传 4.5 Mbps,发送队列每秒增加约 Mbit,约合 187.5 KB/s。持续 20 秒后,理论积压约 3.75 MB;即使播放器缓冲尚未立刻耗尽,端到端延迟也会继续增长。
因此生产系统通常把“目标码率”“实际发送速率”和“发送队列/在途数据”一起看。若目标码率已经从 6 Mbps 降到 4 Mbps,但实际发送仍只有 3 Mbps,而且队列还在增长,说明调整还没跟上;若目标降到 3 Mbps 后队列停止增长、RTT 回落,则说明控制开始生效。
实际排障时怎样判断是哪一类问题
先在同一个时间窗口记录四组数据:发送码率、实际发送速率、RTCP 反馈中的丢包与 RTT,以及发送队列长度。把时间窗口固定为 1~2 秒,连续观察至少 5 个窗口,比只看某一秒的尖峰更有价值。
若丢包从 0.4% 升到 4.0%,RTT 从 45 ms 升到 130 ms,接收速率从 5.8 Mbps 降到 3.9 Mbps,同时发送队列持续增加,可以优先判定为网络拥塞,并执行降码率。
若丢包只有 0.5%,RTT 基本保持 45~50 ms,网络接收速率稳定在 6 Mbps,但编码器实际只产出 2 Mbps,则问题在编码侧。此时继续降低网络目标码率不会解决 CPU、编码 preset 或内容复杂度导致的输出不足。
若编码目标与实际发送都约 4 Mbps、RTT 稳定、丢包低,但播放器仍出现卡顿,应继续检查接收端缓冲、解码耗时和渲染丢帧,不能继续把所有现象归因于 RTCP 拥塞控制。
在工程上,好的控制器不是让码率“越低越安全”,而是在反馈表明链路有余量时逐步升码,在拥塞证据持续出现时快速降码,并用新的 RTCP 反馈验证调整是否真的让 RTT、队列和接收速率恢复。这样才能避免既造成画质损失,又没有真正消除排队延迟。