
流媒体与实时通信 / 系统课时
热门直播间如何抑制回源风暴
热门直播间如何抑制回源风暴
热门直播间在开播、突发上热门或 CDN 缓存同时失效时,大量观众会在几秒内请求同一个播放清单和相邻分片。正确做法不是单纯增加源站机器,而是让相同请求合并、让 CDN 分层缓存,并提前把热点对象推入边缘节点。
学习目标
- 能用请求量和缓存命中率估算一次回源风暴的规模。
- 能为直播清单、媒体分片设计请求合并与分层缓存策略。
- 能通过一个小型模拟验证“合并请求 + 热点预热”对源站压力的改善。
先算清回源风暴
假设一个热门直播间有 20 万在线观众,客户端每 2 秒刷新一次 Media Playlist;若首层缓存恰好同时失效,理论请求到达率约为 次/秒。若每个请求都回源,源站会在同一时间处理数量级相同的请求,而这些请求读取的是同一个直播窗口。
分片请求也会形成热点。假设每个观众平均同时追 2 个媒体分片,则即使播放器把请求均匀分散到最近的几个分片,刚生成的分片仍可能成为瞬时热点。真正需要控制的是“相同对象在同一时间被多少请求重复取源”,而不是简单统计总流量。
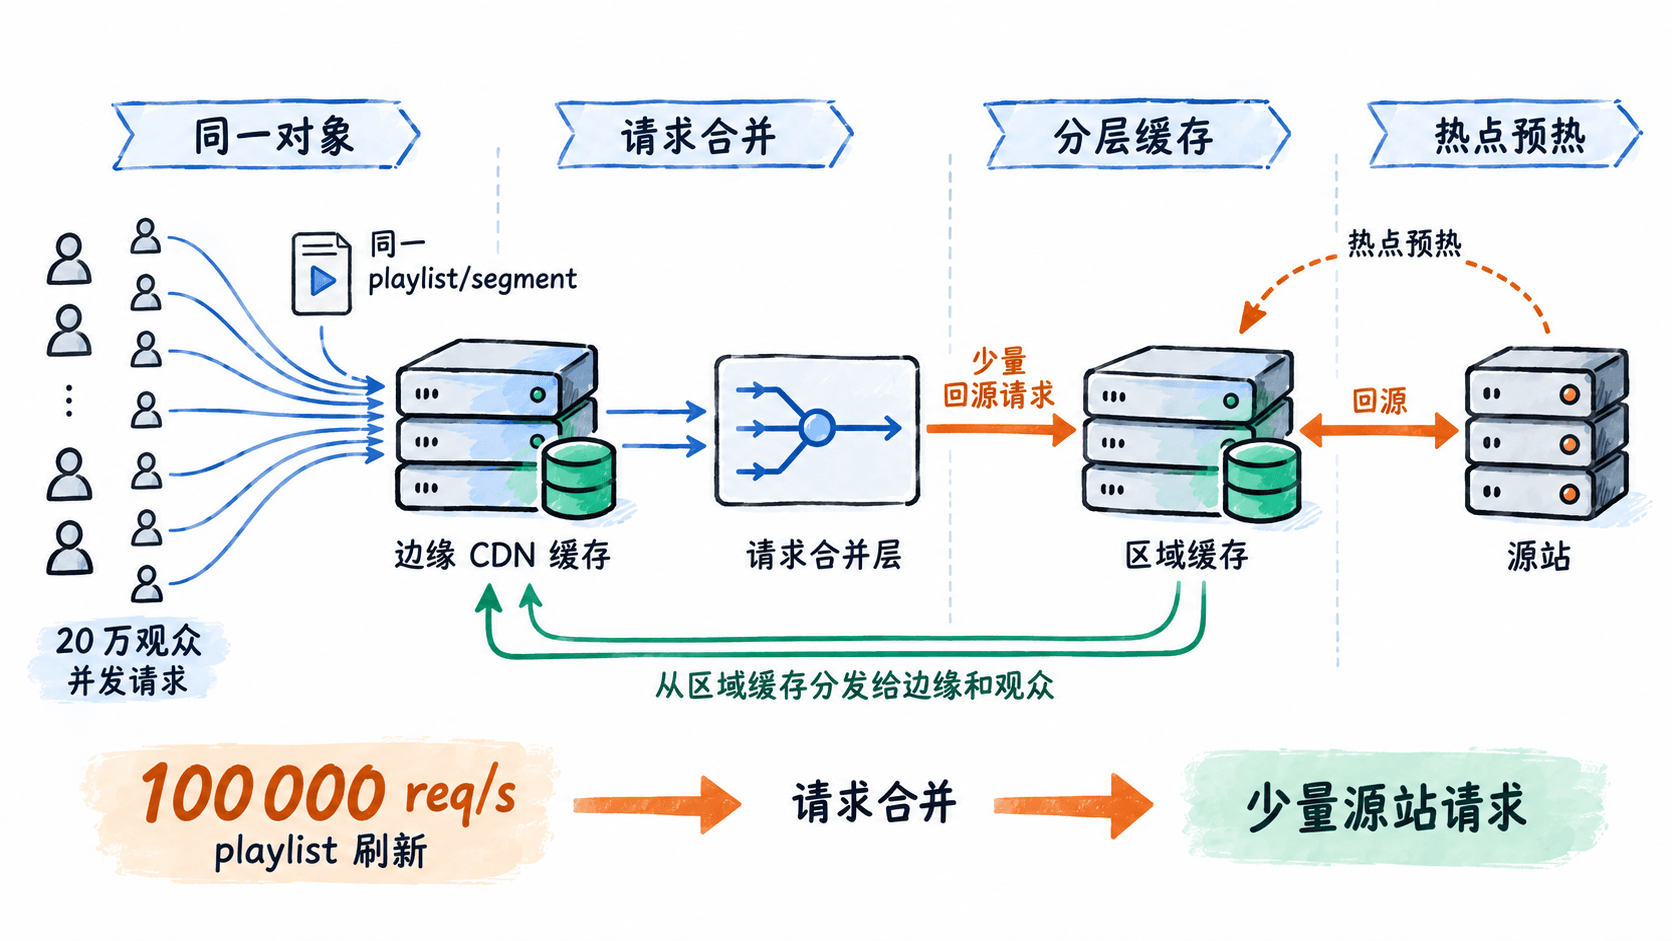
请求合并要放在回源边界
请求合并的目标是:同一个缓存键在缓存未命中时,只允许一个请求去拉源,其余请求等待同一份结果。工程上常称为 request coalescing、single-flight 或 collapsed forwarding。
例如同时到达 5000 个 /live/abc/index.m3u8 请求,错误做法是让 5000 个工作线程同时访问源站;正确做法是把它们按缓存键分组,首个请求成为 leader,其他请求成为 waiters。源站只处理 1 次,成功后 5000 个等待者共享同一份响应。
清单和分片的策略应区分。直播 Media Playlist 更新频繁,不能把 TTL 配得过长;例如 2 秒刷新一次的清单可以配置较短 TTL,并允许 stale-while-revalidate。媒体分片一旦成为不可变对象,通常更适合长缓存,因为相同序号的分片内容不会再修改。
| 对象 | 示例缓存键 | 推荐思路 | 风险点 |
|---|---|---|---|
| Media Playlist | /live/abc/index.m3u8 |
短 TTL + 请求合并 | TTL 过长会增加直播延迟 |
| MPEG-TS 分片 | /live/abc/seg-120.ts |
长 TTL + 分层缓存 | 旧分片应按窗口自然淘汰 |
| CMAF/fMP4 分片 | /live/abc/chunk-120.m4s |
长 TTL + 请求合并 | 小 chunk 热点更集中 |
下面的最小模拟把 5000 个相同请求拆成“无合并”和“请求合并”两种情况,便于观察源站请求数差异。
from concurrent.futures import ThreadPoolExecutor
from threading import Lock
import time

REQUESTS = 5000
CACHE_KEY = "/live/abc/index.m3u8"
source_requests = 0
lock = Lock()

# 模拟没有请求合并:每个并发请求都会访问源站。
def fetch_without_coalescing(_):
    global source_requests
    with lock:
        source_requests += 1
    time.sleep(0.001)
    return CACHE_KEY

# 模拟 single-flight:同一缓存键只允许一次源站拉取。
flight_lock = Lock()
flight_done = False

def fetch_with_coalescing(_):
    global source_requests, flight_done
    with flight_lock:
        if not flight_done:
            source_requests += 1
            flight_done = True
            return CACHE_KEY
        return CACHE_KEY

with ThreadPoolExecutor(max_workers=100) as pool:
    list(pool.map(fetch_without_coalescing, range(REQUESTS)))
print("without_coalescing_source_requests=", source_requests)

source_requests = 0
flight_done = False
with ThreadPoolExecutor(max_workers=100) as pool:
    list(pool.map(fetch_with_coalescing, range(REQUESTS)))
print("with_coalescing_source_requests=", source_requests)
预期输出
without_coalescing_source_requests= 5000
with_coalescing_source_requests= 1
这个示例刻意把网络延迟压缩成极简模型,生产环境还需要处理 leader 超时、回源失败、等待者取消以及多进程之间共享状态等问题;真正的关键仍是“同一缓存键在同一时间窗口只产生一个有效回源”。
用分层缓存降低跨地域回源
单层 CDN 在热点失效时,可能让大量边缘节点同时向同一个源站请求。更稳妥的方式是设置“边缘缓存 → 区域缓存/Shield → 源站”的层级。
例如一个热门直播有 100 个边缘节点,每个节点同时遇到 seg-120.ts 未命中。若无 Shield,源站可能收到约 100 次相同分片请求;增加区域缓存后,可让这 100 次边缘请求汇聚到少量区域节点,再由区域节点只回源 1 次。
设计缓存键时要避免把无关参数带入键。例如播放器携带 token、client=android、debug=0 等参数,如果全部拼入缓存键,会把本来相同的分片拆成许多对象。应只保留真正影响媒体内容的字段,并把鉴权尽量放在缓存对象之外处理。
热点预热与失效时机
请求合并解决的是“已经发生的并发回源”;热点预热解决的是“让大量观众进来之前就有缓存”。直播平台通常可以在开播或预测到热门事件时,提前把最新清单和即将出现的首批分片放入区域缓存,再让边缘节点按需拉取。
预热对象不要覆盖过大的历史窗口。假设直播窗口保留 6 个分片,每片 2 秒,只需预热当前清单和即将产生的 1~2 个分片即可;把几分钟历史分片全部预热通常只会浪费缓存容量。
清单更新还要避免“全网同秒失效”。例如 2 秒 TTL 的清单在整点统一过期,会制造周期性尖峰。可以给不同缓存节点加入少量 TTL 抖动,例如在 1.8~2.2 秒范围内刷新,使请求分散在一个小时间窗内;同时保留请求合并作为最后一道保险。
一次实战验收可以设三组指标:源站 QPS、CDN 命中率、热点对象回源次数。以刚才的 5000 并发模拟为例,理想结果不是“源站流量为零”,而是“同一个对象的并发请求被压缩到 1 次左右”,并且回源峰值不再随观众数线性增长。
什么时候不能只靠请求合并
请求合并无法解决源站本身每秒持续产生大量新对象的问题。例如一个直播每 500 毫秒生成一个新 CMAF chunk,而观众持续增长,热点对象会不断变化。这时仍需要源站扩容、区域 Shield、合理的分片时长、连接复用以及限流策略共同承担压力。
常见错误是只设置 Cache-Control 的 TTL,却没有 single-flight;另一种错误是只做 single-flight,却让所有边缘节点都直接回源。前者会在失效瞬间产生请求风暴,后者会把压力从“每个观众”降低到“每个边缘节点”,但仍可能让源站承受不可控的节点级峰值。
因此,对热门直播最实用的组合是:短周期清单采用请求合并和适度 stale-while-revalidate;不可变分片采用长缓存;边缘与区域之间设置 Shield;热门直播在开播前做有限预热;再用源站回源 QPS 和缓存命中率持续验证。