
流媒体与实时通信 / 系统课时
直播质量指标如何分层采集
直播质量指标如何分层采集
要把直播质量问题定位到具体环节,不能只盯播放器卡顿率。应沿着“推流接入→转码→分发→播放”的链路,把指标放在真正发生问题的位置,并统一带上地域、设备、流等维度。
学习目标
- 能把接入、转码、CDN、播放和端到端指标放到正确的采集位置。
- 能设计地域、设备、流三个核心维度,避免指标只有总体平均值。
- 能用一组样例数据判断瓶颈究竟发生在源站、CDN 还是播放器侧。
按链路确定采集位置
先按直播数据流把指标分层,原则是“在哪个组件产生,就在哪个组件采集”,不要让播放器日志承担整条链路的解释工作。
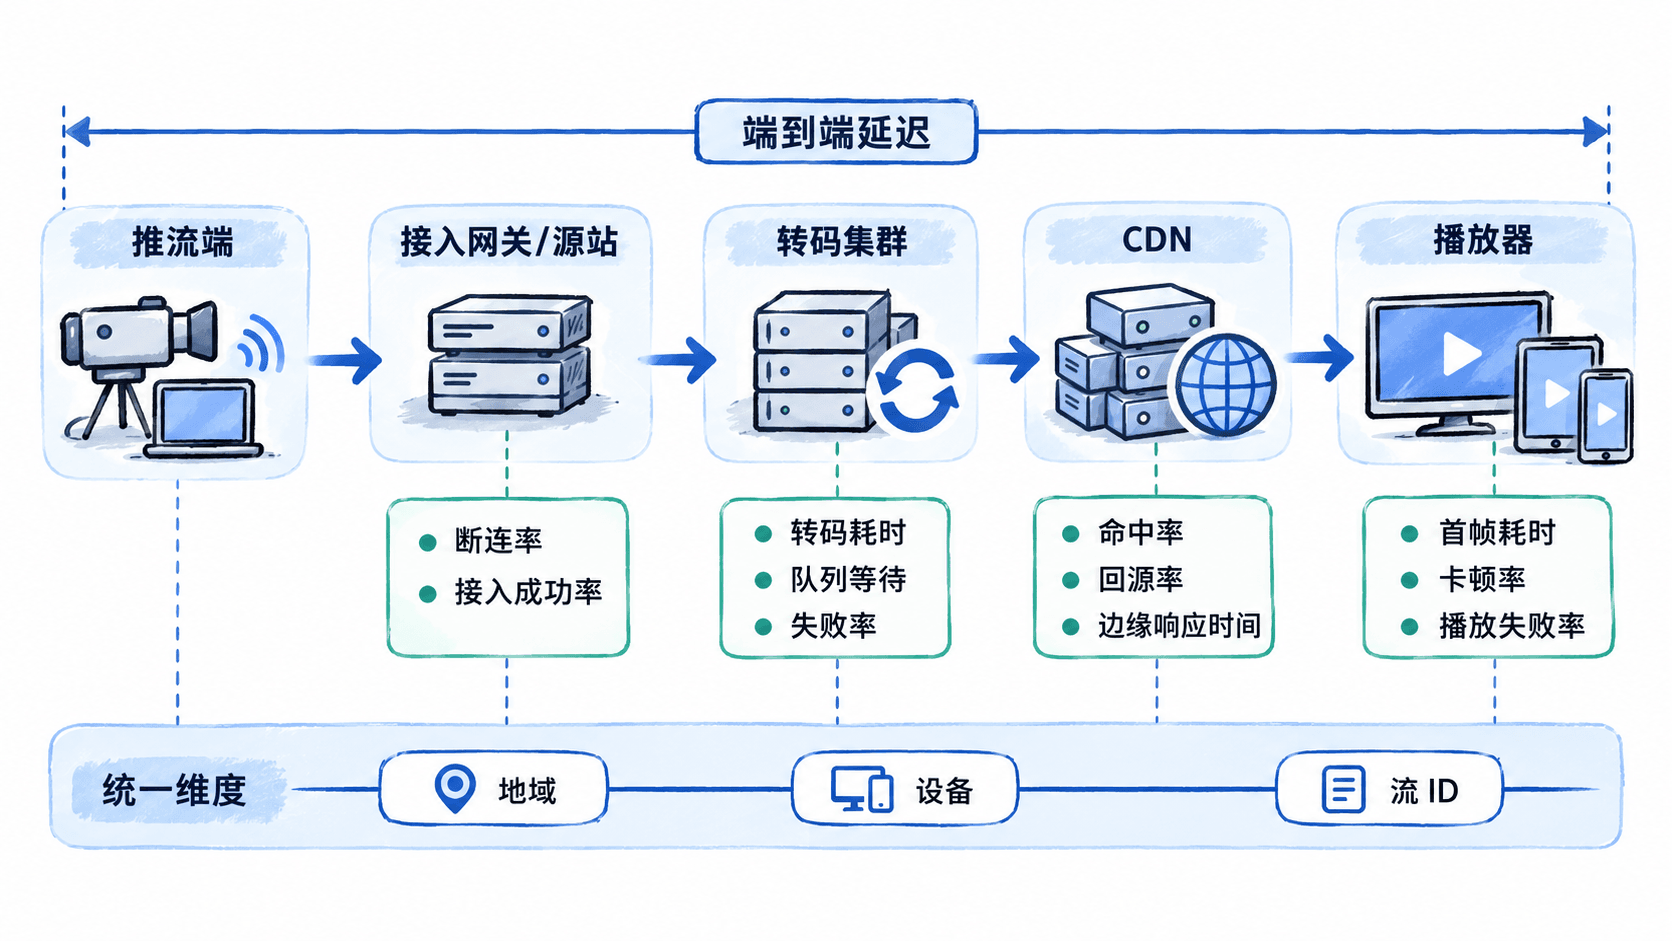
接入断连率应在接入网关或源站统计,例如 1 分钟内新建推流会话中有多少连接异常断开。转码耗时和失败率应来自转码服务本身,否则无法区分“没流进入”和“进入后处理失败”。
CDN 命中率属于分发层指标,通常由 CDN 日志、边缘节点统计或监控接口提供。首帧耗时、卡顿率和播放失败率则属于播放侧,必须结合播放器 SDK 的事件时间戳采集。
端到端延迟不能直接从某一个服务实例得到,通常需要在推流时间戳、媒体时间戳或业务埋点之间建立对应关系,再计算“主播产生内容”到“观众可见”的时间差。
指标怎样定义才可比较
同名指标如果统计口径不同,仪表盘上的数字没有比较价值。接入断连率应明确分子和分母;例如本分钟新增 1000 个推流会话,其中 20 个在建立后异常断开,则断连率为 。
转码耗时建议至少保留平均值和 P95。假设 10,000 个转码任务中平均耗时 180 ms,但 P95 达到 620 ms,那么平均值看似正常,长尾却已经可能把下游缓冲吃光。
CDN 命中率可以按请求数或字节数统计,两者不能混用。播放器卡顿率也要固定分母,例如按“卡顿总时长/有效播放时长”计算时,10 分钟播放中卡顿 12 秒就是 。
端到端延迟应同时记录 P50、P95 和异常峰值。只报平均 2 秒,无法看出少数用户是否已经达到 8 秒以上的不可接受状态。
三个维度要贯穿所有指标
地域用于回答“哪里出问题”,例如将 region=us-west-2 与 region=ap-southeast-1 分开;设备用于回答“谁受影响”,至少保留平台、系统版本和播放器版本;流维度用于回答“哪一路流异常”,核心字段通常是稳定的 stream_id。
不要把高基数字段直接无控制地做成指标标签。例如把完整播放 URL、用户 ID 或动态错误文本作为 Prometheus label,会让时间序列数量迅速膨胀。高基数字段更适合写入日志或追踪系统,再通过 stream_id 等稳定字段关联。
一组推荐的基础维度可以是:region、device_type、stream_id。对播放器侧再增加 player_version,对转码侧增加 codec、resolution。维度应服务于排障问题,不应为了“以后可能有用”无限扩张。
用一组数据定位瓶颈
假设同一时间窗口采集到以下结果:接入断连率 0.8%,转码 P95 210 ms,CDN 命中率 96%,首帧 P95 4.8 s,卡顿率 5.2%,端到端延迟 P95 9.1 s。此时不能直接把问题归因给 CDN,因为命中率本身并不差。
更合理的定位顺序是先看首帧、卡顿和端到端延迟,再向上检查转码输出是否持续、CDN 边缘响应是否异常。若进一步发现首帧主要集中在某两个地域,而源站转码延迟正常,就应按地域切分 CDN 和播放数据,而不是继续扩大转码集群。
实际仪表盘至少应支持以下查询:某地域过去 15 分钟首帧 P95、某设备类型卡顿率、某条流的断连率,以及同一窗口的转码 P95 和 CDN 命中率。这样才能把“用户体验差”逐层还原成具体组件问题。
用代码验证一组质量指标
下面是一个可直接运行的 Python 小例子:它用同一时间窗口的样例指标计算卡顿率,并根据简单阈值给出“正常/观察/告警”结果。它适合先验证监控面板上的计算口径,生产环境再接入实际指标源。
from dataclasses import dataclass

@dataclass
class PlaybackQuality:
    played_seconds: float
    stalled_seconds: float
    startup_seconds: float

    @property
    def stall_rate(self) -> float:
        if self.played_seconds <= 0:
            raise ValueError("played_seconds must be greater than 0")
        return self.stalled_seconds / self.played_seconds


def classify(q: PlaybackQuality) -> str:
    if q.stall_rate >= 0.05 or q.startup_seconds >= 5.0:
        return "告警"
    if q.stall_rate >= 0.02 or q.startup_seconds >= 3.0:
        return "观察"
    return "正常"


quality = PlaybackQuality(
    played_seconds=600,
    stalled_seconds=12,
    startup_seconds=2.4,
)

print(f"stall_rate={quality.stall_rate:.2%}")
print(f"status={classify(quality)}")
预期输出
stall_rate=2.00%
status=观察
这个例子故意把“计算口径”和“告警阈值”分开:前者决定数据是否可信,后者决定运营如何响应。生产环境不要直接照搬示例阈值,应先按业务 SLA、编码规格和历史分位数建立基线。
最终的质量监控视图应让人从“哪里慢、谁受影响、哪条流异常”三个问题直接下钻,而不是只给出一个全站平均卡顿率。这样才能把指标采集真正变成可执行的全链路排障入口。