
流媒体与实时通信 / 系统课时
卡顿率和直播延迟同时升高怎么办
卡顿率和直播延迟同时升高怎么办
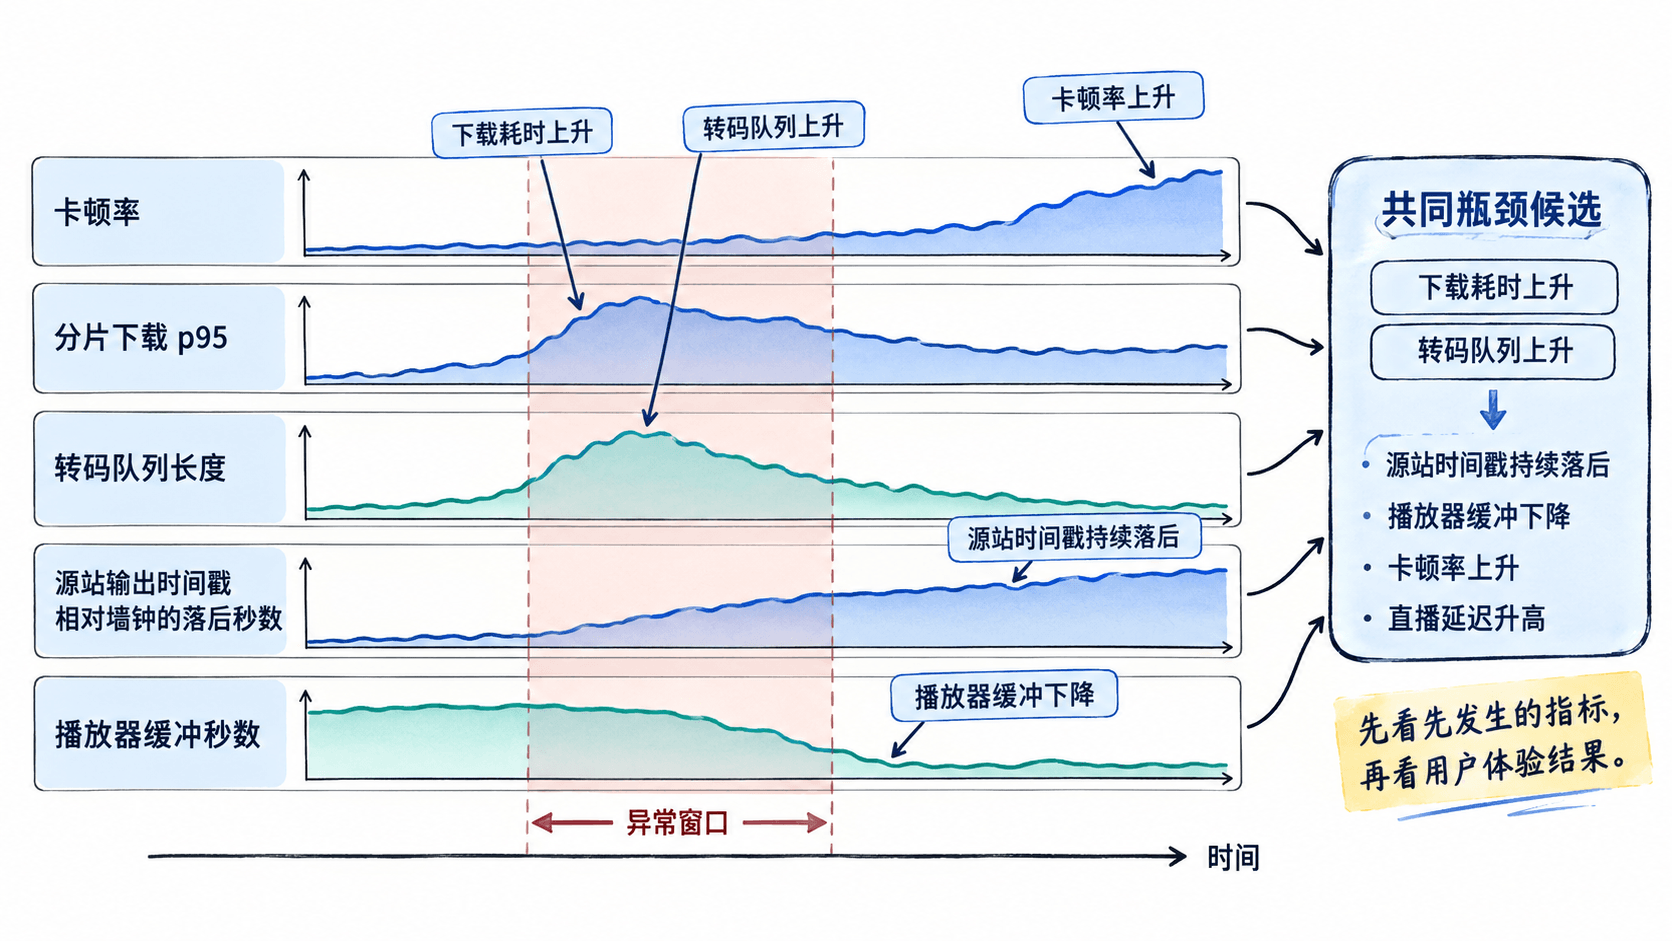
当卡顿率和端到端延迟同时上升,先不要直接扩容播放器或转码节点。把分片下载耗时、转码排队长度、源站输出时间戳和播放器缓冲水位按同一时间轴对齐,先判断它们是否被同一个上游瓶颈推动,再验证修复后四条指标是否一起回落。
学习目标
- 能把卡顿、延迟与下载、转码、源站时间戳、播放器缓冲四类指标放到同一时间轴分析。
- 能区分“共同瓶颈导致的同步恶化”和“播放器自身缓冲策略异常”。
- 能用一组可复现的数据完成修复前后的关联验证。
先固定同一时间窗口
直播排障最容易犯的错误是分别查看四套监控,看到的时间点并不一致。建议以 1 秒或 5 秒为采样粒度,至少保留最近 10 分钟,并统一使用同一时区和同一个直播流 ID。
重点观察四项数据:分片下载耗时通常看 p95/p99;转码看队列长度或等待时间;源站看最近输出媒体时间戳与当前墙钟的差值;播放器看缓冲秒数。卡顿率则作为结果指标,用来判断用户体验是否同步恶化。
一个典型异常窗口可能是:下载 p95 从 180 ms 升到 700 ms,转码队列从 4 增至 26,源站输出时间戳落后墙钟从 0.8 s 扩大到 4.2 s,而播放器缓冲从 6 s 降到 1.5 s。四项变化方向一致时,应优先检查媒体链路的共同瓶颈,而不是先改播放器参数。
用时间顺序区分根因
不要只看相关系数,还要看谁先变。假设 20:00:00 开始出现异常:20:00:00~20:00:20 转码队列从 5 增到 30;20:00:10~20:00:40 源站输出时间戳持续落后;20:00:20~20:00:50 分片下载 p95 升高;20:00:30 以后播放器缓冲跌到 2 秒以下;随后卡顿率上升。这种领先关系更支持“上游产能不足或输出变慢”这一假设。
反过来,如果下载耗时和源站时间戳都稳定,但播放器缓冲从 5 秒突然跌到 0.8 秒,再伴随卡顿率升高,就不应该把主要精力放在转码集群上。此时检查播放器 ABR、网络切换、最大缓冲上限以及播放端时钟偏差更合理。
实际排查可以按以下顺序做:
- 先找卡顿率与直播延迟共同开始恶化的时间点。
- 向前回看 30~60 秒,寻找四类中间指标中最早异常的一项。
- 检查该指标对应资源是否出现持续排队、超时、限速或容量不足。
- 再观察后续指标是否按照“上游异常→源站延迟→缓冲下降→卡顿”的顺序变化。
把四条指标放到同一份数据里
现场可以先用统一时间戳导出 CSV,再做简单的相关性和领先关系检查。下面的示例不依赖第三方库,直接用 Python 标准库计算 Pearson 相关系数,样本代表同一条流的连续 8 个采样点。
from math import sqrt

# 示例数据:下载耗时、转码队列、源站时间戳落后秒数、播放器缓冲秒数、卡顿率
samples = [
    (180, 4, 0.8, 6.0, 0.5),
    (190, 5, 0.9, 5.8, 0.6),
    (210, 7, 1.0, 5.5, 0.7),
    (300, 12, 1.5, 4.8, 1.0),
    (420, 18, 2.3, 3.9, 1.8),
    (560, 24, 3.1, 2.8, 3.0),
    (680, 29, 4.0, 2.0, 4.6),
    (710, 31, 4.3, 1.6, 5.2),
]


def corr(xs, ys):
    mx = sum(xs) / len(xs)
    my = sum(ys) / len(ys)
    numerator = sum((x - mx) * (y - my) for x, y in zip(xs, ys))
    den_x = sqrt(sum((x - mx) ** 2 for x in xs))
    den_y = sqrt(sum((y - my) ** 2 for y in ys))
    return numerator / (den_x * den_y)

rows = list(zip(*samples))
labels = ["download_p95_ms", "transcode_queue", "source_lag_s", "buffer_s", "stall_rate_pct"]

for label, values in zip(labels[:-1], rows[:-1]):
    print(f"{label:18s} vs stall_rate: {corr(values, rows[-1]):.3f}")
预期输出
download_p95_ms    vs stall_rate: 0.981
transcode_queue    vs stall_rate: 0.995
source_lag_s       vs stall_rate: 0.989
buffer_s           vs stall_rate: -0.993
这组结果只能说明样本窗口内存在很强的同步变化,不能单独证明哪一个指标是根因。真正的判断还要结合时间先后:如果转码队列最先达到持续增长,且 GPU 利用率或单帧处理时间同步恶化,就应优先定位转码侧。
修复后必须验证“整条链路”
假设确认是转码排队导致输出变慢,修复动作可以是增加 Worker、降低高峰期非必要转码规格,或修复单节点异常。不要只验证“队列从 30 降到 5”,而应重新观察完整链路。
一次可执行的验收条件可以设为:修复后连续 5 分钟,转码队列维持在 10 以下;源站时间戳相对墙钟的落后量回到 1 秒量级;播放器缓冲恢复到 4 秒以上;分片下载 p95 回到异常前的基线附近;卡顿率回落并稳定,不再出现与延迟同步的二次爬升。
最有效的验证方式是做一次“故障前基线→故障窗口→修复窗口”的对照,而不是只截取修复后的一分钟。若修复转码后队列下降、源站时间戳追平、播放器缓冲恢复、卡顿率同步下降,才可以较有把握地确认这条因果链成立。
一个常见错误是直接把播放器最小缓冲从 2 秒调到 6 秒。这样可能暂时降低卡顿,却把直播延迟进一步推高,而且没有解决源站输出变慢的问题。正确做法是先恢复媒体链路的产能,再根据业务目标调整播放器缓冲策略。